





















01
Necessários Sempre ativo
Indispensáveis para o funcionamento do site (sessão, preferências, segurança). Sempre ativos.
A 1 de outubro de 2026, a Cloudflare lançou os modelos de decisão Clef e Clef-flash e a Strands Labs lançou o Strands Decider 2B, todos de pesos abertos sob Apache 2.0. Eis onde os modelos de decisão pequenos e calibrados encaixam nos agentes de um MSP, e onde param.
A 1 de outubro de 2026, duas empresas publicaram a mesma ideia no mesmo dia. A Cloudflare lançou dois modelos de decisão, o Clef e o Clef-flash, alojados no Workers AI e publicados no Hugging Face com licença Apache 2.0. No mesmo dia, a Strands Labs lançou o Strands Decider 2B, um modelo de decisão com dois mil milhões de parâmetros cujos pesos, dados de treino e scripts estão abertos sob Apache 2.0.
Um modelo de decisão não escreve texto. Lê uma situação, o «estado», e um conjunto de perguntas tipadas, e devolve uma probabilidade para cada resposta permitida, para que o seu código possa encaminhar um ticket, aprovar ou suspender uma chamada a uma ferramenta, ou passar o caso a uma pessoa. Ambos os fornecedores apresentam o seu lançamento como resposta à atenção em torno do Jev, o modelo de decisão da Typesafe AI, e ambos dizem que os seus modelos são compatíveis com a API dele.
Há um enquadramento que se aplica a tudo o que se segue: todos os valores de exatidão e latência deste artigo são declarados pelo fornecedor. Isso inclui a mediana de 209 ms que a Cloudflare declara para o Clef e de 39 ms para o Clef-flash, e os cerca de 115 ms que a Strands declara numa RTX 3090 local.
Para um MSP, o interessante não é quem lidera uma classificação. É que as decisões pequenas, estruturadas e repetíveis dentro de um agente podem passar de um grande modelo genérico para algo barato, calibrado e executável no seu próprio hardware. Este artigo explica o que é um modelo de decisão, o que cada fornecedor lançou, onde o padrão encaixa e onde termina.
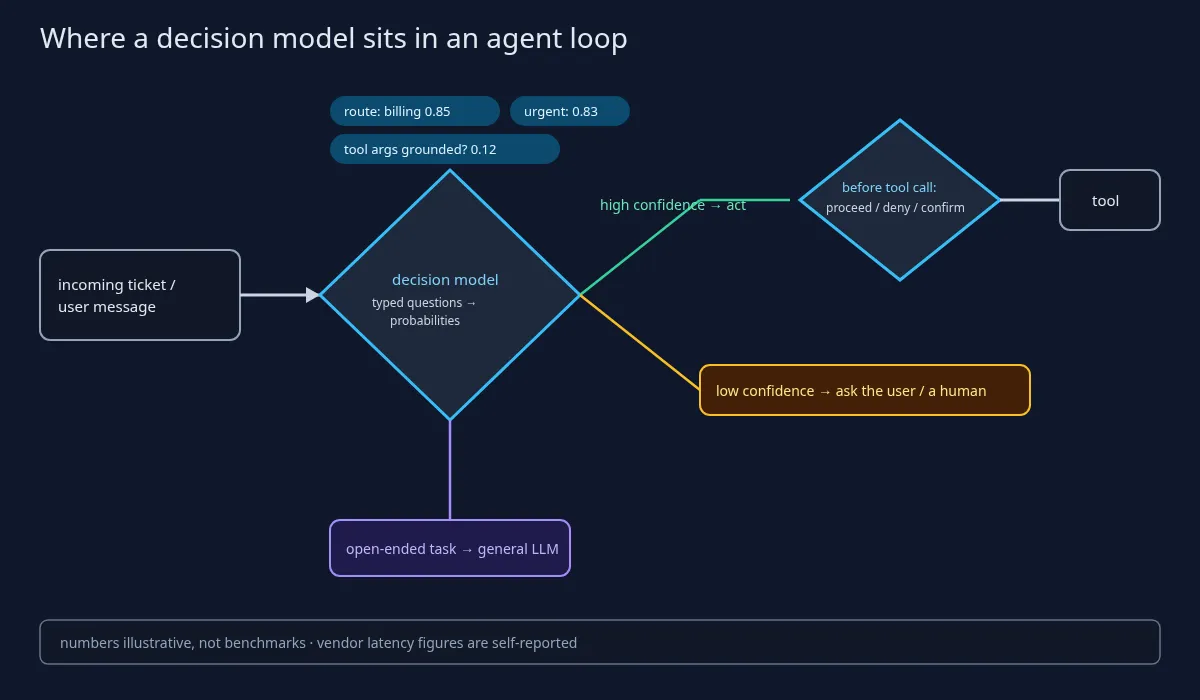
As duas publicações descrevem a mesma interface. Passa-se um estado, que pode ser texto ou JSON e, no caso do Clef, imagens, juntamente com perguntas tipadas. Uma pergunta de sim ou não chama-se noul nas duas API, uma pergunta de escolha única é um choice e uma escala ordenada é um score. O modelo devolve uma probabilidade para cada opção permitida e responde sempre a partir das opções fornecidas.
Isto é útil por duas razões. Uma resposta de um conjunto fechado não precisa de análise da saída e não pode inventar uma categoria nova. E uma probabilidade permite ao código definir um limiar: agir acima dele, perguntar a uma pessoa abaixo dele. A Strands sublinha que várias perguntas sobre a mesma entrada saem baratas se forem feitas em conjunto, pelo que uma só passagem pode devolver uma equipa de destino, um indicador de urgência e uma verificação de fundamentação.
Os fornecedores apresentam a diferença face a um modelo de linguagem pela forma como a resposta é produzida. A decisão é tomada numa única passagem paralela sobre a entrada, e não token a token, e é daí que vêm as promessas de velocidade.
O que um modelo de decisão não é conta igualmente. Segundo a própria Strands, o seu modelo é muito mais fraco do que os modelos de raciocínio em problemas complexos, e inútil para programar, conversar ou resumir, porque não consegue gerar texto. A sua força são as escolhas pequenas e repetidas, não as difíceis.
Os classificadores existem há anos, e um leitor cético dirá isso mesmo. A proposta, tal como a publicação da Cloudflare a enquadra, é um único modelo que aceita categorias novas no momento do pedido, sem novo treino: muda-se a pergunta, não o modelo.
Segundo a publicação da Cloudflare de 1 de outubro e a sua ficha no Hugging Face, foram lançados dois modelos: o Clef e o Clef-flash, alojados no Workers AI e descarregáveis sob Apache 2.0. A ficha descreve o Clef como um modelo multimodal de 27B, pós-treinado a partir do Qwen3.8-27B, que lê texto, JSON, imagens ou vídeo e responde numa única passagem direta, sem geração livre. Segundo a publicação, o Clef-flash congela uma base Qwen3.5-9B. Ambos acrescentam uma pequena cabeça de encaminhamento e adaptadores de baixa ordem com ordem 256, treinados com funções de perda de calibração.
A Cloudflare refere duas coisas que, segundo diz, distinguem o Clef: um codificador de visão, para que as imagens possam fazer parte do estado, e uma janela de contexto de 64k tokens, que contrapõe aos 32k do Jev.
Os números vêm de uma execução interna, pela própria Cloudflare, do conjunto Decision Index, e todos são declarados pelo fornecedor. A Cloudflare declara uma exatidão BFCL case-exact de 98,47 para o Clef e de 98,76 para o Clef-flash. Declara uma latência mediana de 209,3 ms para o Clef e de 38,8 ms para o Clef-flash, com uma latência p95 declarada de 238,6 ms e 122,4 ms, respetivamente.
As mesmas tabelas mostram também o lado mais fraco. Os valores declarados pela própria Cloudflare colocam o Clef atrás do Jev em conjuntos de raciocínio mais difíceis, como GPQA Diamond, MMLU-Pro e BBH. Encaixa no padrão: os modelos de decisão são feitos para escolhas delimitadas, não para raciocínio difícil.
Mais duas afirmações do fornecedor, assinaladas como tal. Numa história ilustrativa, a Cloudflare relata que um fluxo de classificação de domínios demorou 2,2 segundos com o Clef contra 4,7 segundos com o gpt-oss-120b. Como compromisso, a Cloudflare diz que não lê nem armazena os pedidos e respostas, nem treina com eles, salvo se o cliente aderir ao seu serviço de fine-tuning.
O alojamento próprio é possível, mas não é leve. O exemplo de referência da ficha foi testado numa única H200; o Clef é um modelo de 27B, não um modelo para portátil. O Clef-flash e o endpoint alojado são os caminhos mais leves. A Cloudflare anunciou ainda um serviço de fine-tuning por aprendizagem por reforço, oferecido primeiro através dos seus engenheiros destacados junto dos clientes e mais tarde em regime de self-service; a publicação não divulga preços.
Segundo a publicação da Strands Labs de 1 de outubro e a sua ficha no Hugging Face, o Strands Decider 2B é um modelo de decisão com dois mil milhões de parâmetros, construído sobre o Qwen3.5-2B, ao qual foi retirada a cabeça de geração de texto, substituída por uma pequena cabeça de ponteiro, com pouco mais de um milhão de parâmetros, que pontua cada opção. O tronco é afinado com uma LoRA de ordem 16. O checkpoint publicado é a v19, após muitas iterações cujo histórico está no repositório.
A abertura é a manchete. O código está no GitHub, os pesos no Hugging Face e, segundo a Strands, também todos os dados de treino e scripts usados para construir o modelo, sob Apache 2.0. A ficha indica que voltar a treiná-lo demora cerca de 11 horas numa RTX 3090. Para um MSP que queira adaptar um modelo de decisão às suas próprias categorias de tickets, é essa reprodutibilidade que importa.
Os números são declarados pelo fornecedor. A Strands declara uma mediana de cerca de 115 ms para decisões locais numa RTX 3090, e a legenda do gráfico diz que essa medição foi feita na v18, não na v19. Declara cerca de 153 ms para tarefas pequenas num MacBook M3. A ficha declara 167 de 231 tarefas públicas do JevBench corretas e assinala esse resultado como «self-reported».
A Strands publica os seus próprios limites, e eles devem constar de qualquer nota de adoção. Os documentos longos e com vários passos são o ponto fraco. As perguntas são lidas com menos atenção do que os documentos. A calibração foi ajustada em tarefas curtas de classificação, pelo que a ficha aconselha a medir os limiares no seu próprio tráfego antes de confiar neles.
Uma linha operacional que um MSP não pode deixar escapar: segundo a ficha, o comando integrado strands-decider serve fica à escuta em 127.0.0.1 e não tem autenticação, e a ficha indica-o para experiências locais. Não o exponha tal como está numa rede partilhada.
O exemplo desenvolvido na publicação é uma verificação antes de uma chamada a uma ferramenta: os argumentos da ferramenta assentam no que o utilizador realmente disse, e é cedo demais para agir? A Strands chama-lhe uma ilustração e não uma recomendação, e é assim que deve ser lido.
Abaixo está o exemplo da Strands retirado da sua ficha de modelo, executado numa máquina local. A ficha observa que um novo treino dá números um pouco diferentes.
pip install strands-decider

strands-decider ask StrandsAgents/strands-decider-2B-hobson-v19 \
  --state "Help! My payouts have been failing for 3 days! " \
  --choice "Which team should handle this?=billing,sales,retail" \
  --noul "Does this convey urgency?"
Ambos os fornecedores apontam a mesma família de utilizações, e elas encaixam bem nas operações de agentes de um MSP: encaminhamento e urgência de tickets, encaminhamento de modelos (enviar um pedido para um modelo barato ou caro), escolha de ferramentas, verificações antes de uma chamada a uma ferramenta, classificação segundo políticas e triagem de alertas. São as decisões rotineiras em que um LLM genérico é lento, caro e mais difícil de auditar.
A Strands descreve claramente a forma híbrida: deixar ao LLM as decisões difíceis e ao modelo de decisão as rotineiras. Isso só reduz custos e latência se o medir na sua própria carga. Aqui não se apresenta qualquer número de poupança, porque, para a sua carga, não existe nenhum enquanto não o medir.
Controlos de adoção, do lado da defesa, cada um com a sua prova:
O que não fazer: não deixe que um modelo de decisão seja a única barreira antes de uma ação irreversível. Combine-o com uma política determinística ou com uma pessoa, como faz o próprio exemplo da Strands com as ações proceed, deny e confirm.
Quatro coisas que este artigo não é.
Não é uma análise do Jev, da Typesafe. Ambos os fornecedores apontam o Jev como o motivo dos seus lançamentos; este artigo não o testou e não cita nenhum número do Jev a não ser tal como aparece nas tabelas da Cloudflare.
Não é sobre o Laminar flow-1, um modelo pequeno que lê rastos de agentes para encontrar falhas. Isso é outra notícia.
Não é sobre o Reflection Beam, um grande modelo genérico anunciado cujos pesos ainda não foram disponibilizados.
Não é um artigo sobre preços do Workers AI. A publicação da Cloudflare não divulga nenhum preço para o Clef nem para o seu serviço de fine-tuning, e este artigo não inventa nenhum.
Os factos verificados: a 1 de outubro de 2026, a Cloudflare lançou o Clef, um modelo de decisão multimodal de 27B pós-treinado a partir do Qwen3.8-27B, e o Clef-flash, no Workers AI e no Hugging Face sob Apache 2.0, com um serviço de fine-tuning por aprendizagem por reforço a caminho. No mesmo dia, a Strands Labs lançou o Strands Decider 2B, construído sobre o Qwen3.5-2B com uma LoRA e uma cabeça de ponteiro, com pesos, código, dados de treino e scripts sob Apache 2.0.
Todos os valores de exatidão e latência deste artigo são declarados pelo fornecedor: a pontuação BFCL declarada de 98,47 e a mediana de 209 ms do Clef, a mediana declarada de 38,8 ms do Clef-flash e o valor de cerca de 115 ms numa RTX 3090 que a Strands declara para o Decider. As próprias tabelas da Cloudflare mostram o Clef atrás nos conjuntos de raciocínio mais difíceis.
O padrão é a notícia. Decisões delimitadas e calibradas dentro de um agente podem passar para modelos pequenos de pesos abertos que pode executar por si, com uma pessoa ou uma política determinística por trás de cada passo de baixa confiança ou irreversível. Meça no seu próprio tráfego antes de confiar em qualquer limiar.