





















01
Necessários Sempre ativo
Indispensáveis para o funcionamento do site (sessão, preferências, segurança). Sempre ativos.
Ao longo de dez dias de outubro de 2026, vários IDs de modelos alojados chegam à data de descontinuação: os snapshots legados da OpenAI a 23 de outubro, os IDs MaaS de modelos abertos da Google a 21 de outubro, o Gemini 2.5 no Google Cloud a 16 ou 20 de outubro e dois modelos Snowflake Cortex a 14 de outubro. Fixe os IDs, atribua um responsável a cada um e saiba que pesos abertos poderia executar por conta própria.
Comece pelo calendário. Ao longo de dez dias de outubro de 2026, vários IDs de modelos alojados chegam à data de descontinuação. A página de descontinuações da OpenAI lista um conjunto de snapshots legados e de linhas afinadas com data de desativação marcada para 23 de outubro de 2026. A tabela Model-as-a-Service de modelos abertos da Google fixa 21 de outubro como data de retirada dos IDs de DeepSeek, GLM, Qwen3, Llama 3.3, Kimi K2, MiniMax M2, gpt-oss-20b e dos embeddings E5, e indica como alternativa a implementação, por conta própria, dos mesmos pesos. As próprias páginas da Google não coincidem quanto ao Gemini 2.5 Pro, Flash e Flash-Lite: uma nota de versão de abril indica 16 de outubro, enquanto a tabela do ciclo de vida consultada a 6 de outubro indica 20 de outubro. O próprio aviso de descontinuação da Snowflake fixa 14 de outubro de 2026 como data de fim de vida de dois modelos Cortex, o claude-4-sonnet e o openai-gpt-4.1.
A tese cabe em duas frases. Um ID de modelo alojado é uma dependência com prazo de validade, por isso deve constar de um inventário com um responsável identificado pelo nome. Os pesos abertos que executa por conta própria não têm data de descontinuação imposta por um fornecedor, mas passam para si o ritmo das atualizações, o hardware e a aplicação de patches.
O que se segue: o calendário fornecedor a fornecedor, o que significa «descontinuado» na prática, seis hábitos para fixar IDs de modelos, os compromissos honestos do alojamento próprio e uma caixa sobre o Kolibri da Aleph Alpha, lançado a 3 de outubro com pesos abertos sob Apache 2.0. Todas as datas abaixo provêm da página de um fornecedor; essas páginas foram relidas a 6 de outubro de 2026, e a da Snowflake a 9 de outubro de 2026.
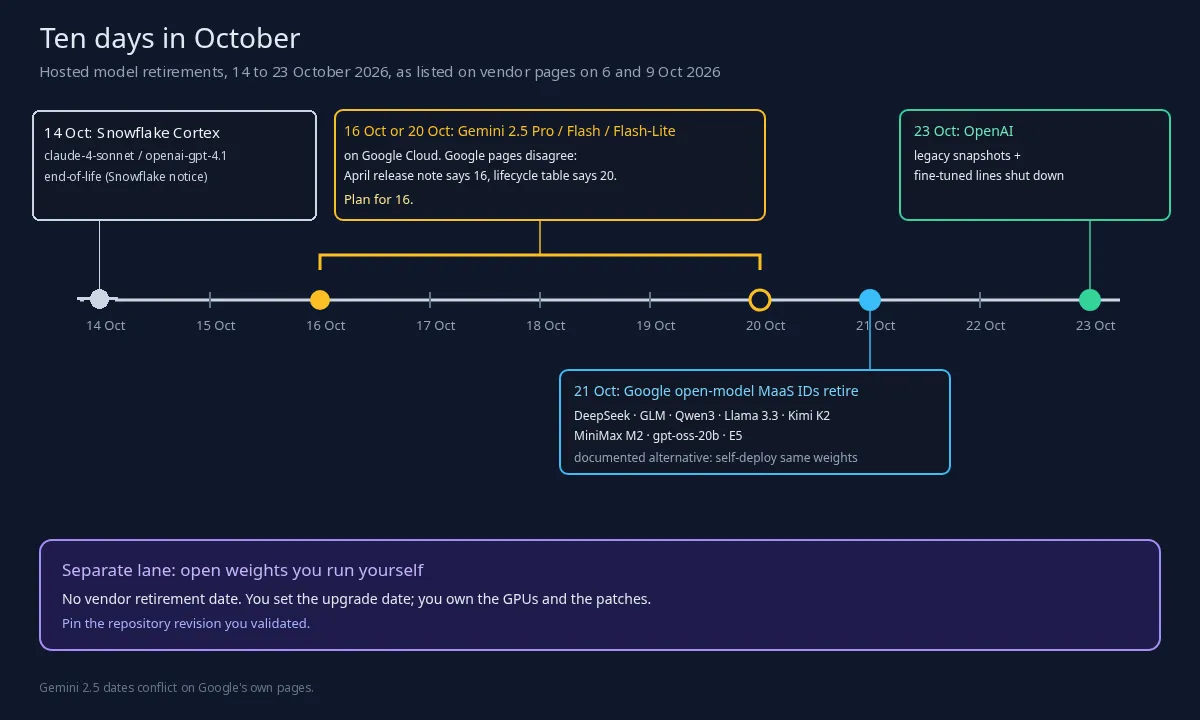
OpenAI, 23 de outubro. A secção da página de descontinuações da OpenAI datada de 22 de abril de 2026 lista estes snapshots para encerramento a 23 de outubro: gpt-3.5-turbo-0125, gpt-4-0613, gpt-4-turbo, gpt-4.1-nano, gpt-4o-2024-05-13, gpt-image-1, o1-2024-12-17, o1-pro-2025-03-19, o3-mini-2025-01-31, o4-mini-2025-04-16 e ft-o4-mini-2025-04-16, além de linhas afinadas sobre gpt-3.5-turbo, gpt-4, gpt-4.1-nano, babbage-002 e davinci-002. Os substitutos indicados pela OpenAI são a família gpt-5.6-sol, gpt-5.6-terra e gpt-5.6-luna, com gpt-image-2.5-sunburst ou gpt-image-2.5-flare em vez de gpt-image-1. Várias linhas indicam também nomes relacionados numa coluna à parte, e a tabela não diz claramente se esses nomes também deixam de funcionar. Quando uma linha indicar nomes relacionados, confirme na página cada nome que o seu código chama.
Modelos abertos da Google, 21 de outubro. A tabela de descontinuações MaaS de modelos abertos da Google lista DeepSeek (OCR, R1-0528, V3.1 e V3.2), GLM (5 e 4.7), gpt-oss-20b, Kimi K2 Thinking, Llama 3.3 70B Instruct, MiniMax M2, dois modelos de embedding E5 multilingues e quatro variantes do Qwen3: 16 IDs de modelo no total, com data de retirada a 21 de outubro. Todos foram descontinuados a 21 de julho, e cada linha indica como alternativa a implementação do modelo por conta própria no Model Garden.
Gemini 2.5 no Google Cloud, 16 ou 20 de outubro. Uma nota de versão de abril fixou 16 de outubro; a tabela do ciclo de vida da Google consultada a 6 de outubro mostra 20 de outubro. Planeie para a data mais próxima e verifique a página do ciclo de vida para o seu projeto. Em pormenor: uma nota de versão do Vertex AI de cerca de 2 de abril de 2026 diz que as datas de retirada do Gemini 2.5 Pro, Flash-Lite e Flash «foram atualizadas para 16 de outubro de 2026» (tradução nossa). A tabela de versões e ciclo de vida dos modelos atualmente publicada mostra 20 de outubro para os três, com substitutos como gemini-3.8-flash, gemini-3.5-flash, gemini-3.5-flash-lite e gemini-3.1-flash-lite. Não encontrámos nenhuma nota posterior que explique a diferença. A página de descontinuações da API Gemini da Google não anuncia data de encerramento para estes três modelos, pelo que o prazo depende de qual a superfície da Google que cada carga de trabalho chama.
Snowflake Cortex, 14 de outubro. O aviso da Snowflake sobre descontinuações de modelos Cortex indica 14 de outubro de 2026 como data de fim de vida do claude-4-sonnet e do openai-gpt-4.1, que passaram ao estado legacy a 12 de agosto de 2026. Após o fim de vida, as consultas e chamadas à API que indiquem qualquer um dos dois modelos falham.
ChatGPT e Codex, 14 de outubro. O registo de alterações oficial do ChatGPT e do Codex da OpenAI, numa entrada datada de 14 de setembro de 2026, fixa 14 de outubro de 2026 como a data em que o GPT-5.5 é retirado do ChatGPT, do ChatGPT Work e do Codex em todos os planos, incluindo Business, Enterprise e Edu. A mesma entrada indica que a retirada não se aplica à API da OpenAI, pelo que as chamadas à API para gpt-5.5 não são afetadas. No Codex, as predefinições do espaço de trabalho, as definições de modelo guardadas, os agentes personalizados, as tarefas agendadas e os scripts que ainda selecionam gpt-5.5 precisam de um modelo de substituição.
O calendário não para depois de outubro. As próximas datas da OpenAI já presentes na página são 1 de dezembro para os modelos GPT Image e 11 de dezembro para os snapshots datados do GPT-5 e do o3.
«Descontinuado» soa a formalidade administrativa. Em produção significa erros. A página da Google sobre modelos abertos define duas fases. Durante o período de descontinuação, o endpoint continua a funcionar para as cargas existentes, para que possa migrar, mas a nova utilização do endpoint pode ser restringida. Na data de retirada, o endpoint é desativado e os pedidos de API que chamam um ID de modelo retirado falham.
A formulação da OpenAI é mais curta: no encerramento, um modelo ou endpoint deixa de estar acessível. Uma regra da mesma página apanha muitas equipas desprevenidas. A inferência num modelo afinado para quando o seu modelo base é descontinuado, pelo que um modelo afinado só dura tanto quanto a base sobre a qual foi treinado. O cliente que pagou uma afinação no ano passado comprou algo que tem o prazo de validade do modelo base.
Os prazos de aviso variam consoante a fase. A página da OpenAI compromete-se com pelo menos seis meses para modelos em disponibilidade geral, pelo menos três meses para variantes especializadas e possivelmente apenas cerca de duas semanas para modelos com preview no nome. A Google mantém os modelos abertos em fase de pré-visualização disponíveis durante pelo menos 45 dias após o lançamento. A regra prática: os IDs preview não pertencem a um percurso crítico voltado para o cliente, a menos que o contrato permita uma migração rápida.
Existe uma saída de emergência, e é comercial. A OpenAI diz que alguns programadores poderão negociar com a sua equipa comercial capacidade dedicada para manter o acesso depois de uma data de encerramento. É uma negociação, não uma predefinição, e não deve ser o plano.
O que avaria no parque de um MSP raramente é a aplicação principal. É o resumidor esquecido numa integração de tickets, a tarefa de embeddings por trás de um índice de pesquisa ou o modelo afinado que um cliente pagou no ano passado. As descontinuações de modelos de embedding contam a dobrar: um novo modelo de embedding implica normalmente reindexar o corpus, e não apenas trocar um nome num ficheiro de configuração.
Uma linha do inventário precisa de um ID fixado, da data, de um substituto em teste e de um responsável identificado. O YAML ilustrativo abaixo mostra a estrutura; todos os nomes que contém são marcadores de posição.
# model-inventory.yaml: one row per call site, reviewed monthly
- call_site: ticket-summarizer
  provider: openai
  model_id: o4-mini-2025-04-16        # listed for shutdown 2026-10-23
  replacement_under_test: gpt-5.6-terra
  owner: platform-team
  eval_set: summaries-golden-v3
  cutover_ticket: CHG-0000
- call_site: kb-search-embeddings
  provider: google-maas
  model_id: multilingual-e5-large-instruct-maas   # retires 2026-10-21
  plan: self-deploy same weights OR switch model + re-index
  owner: search-team
Fixar IDs não é um produto. São seis hábitos, cada um com algo que conta como prova.
1. Em produção, chame snapshots datados, não nomes flutuantes. Um nome flutuante pode passar para um novo modelo sem que dê por isso. Um ID datado só muda quando é o próprio a mudá-lo. Prova: a configuração implementada mostra o ID datado. Não é prova: «usamos o mais recente».
2. Mantenha uma linha de inventário por ponto de chamada, com fornecedor, ID exato, responsável, data de retirada e o substituto em teste. Pesquise no código, na configuração da infraestrutura e nas automatizações low-code, não apenas na aplicação principal. Os pontos de chamada que causam problemas são normalmente os que foram construídos fora do repositório principal.
3. Subscreva a fonte oficial. Ou seja, as páginas de descontinuação dos fornecedores e os e-mails de conta que enviam. Uma newsletter de resumos é uma pista, não uma fonte. Este artigo demonstra-o: uma página da Google contradiz outra página da Google sobre o Gemini 2.5.
4. Teste o substituto com o seu próprio tráfego e um pequeno conjunto de referência antes da transição: formato da saída, recusas, latência e custo por tarefa. Nunca parta do princípio de que um «substituto recomendado» se comporta como o modelo que substitui.
5. Faça a transição antes da data, com uma janela de reversão que termine antes da data. Voltar a um ID retirado não é uma reversão. Se a data plausível mais próxima for 16 de outubro, a janela de reversão fecha antes de 16 de outubro.
6. Trate as alterações de predefinições como lançamentos. Quando um fornecedor muda o modelo para o qual aponta um nome predefinido, a fatura e o comportamento podem mudar sem qualquer alteração de preço. É a fixação que transforma isso numa alteração planeada, com um ticket, um teste e um responsável.
A prova mais clara de que o acesso alojado e o próprio modelo são coisas diferentes vem da Google. Para cada modelo aberto com data de retirada a 21 de outubro, a própria tabela da Google documenta a alternativa: implementar por conta própria os mesmos pesos no Model Garden. O endpoint desaparece; os pesos não.
O que se ganha é concreto. Os pesos que descarrega e serve não desaparecem porque um fornecedor retira um endpoint. É o próprio a decidir quando atualizar, e pode manter exatamente a revisão que validou. Fixe a revisão do repositório que testou, e não apenas o nome do modelo, porque um repositório de modelos pode mudar depois da primeira transferência.
O que se assume é igualmente concreto: GPUs ou capacidade reservada, uma stack de serviço e as respetivas atualizações, monitorização, avaliação própria antes de cada atualização e os patches de segurança de tudo o que rodeia o modelo. É um custo operacional real. O valor depende da sua carga de trabalho e dos seus contratos, pelo que este artigo não o quantifica.
As licenças diferem. Alguns modelos abertos são publicados sob Apache 2.0; outros usam licenças próprias, com condições próprias de utilização, atribuição ou escala. Leia a licença do repositório exato antes de um cliente depender dele e guarde uma cópia junto à linha do inventário.
Onde é que isto encaixa para um MSP? Cargas estáveis e bem definidas, como classificação, extração e pesquisa sobre os documentos do próprio cliente, são boas candidatas. O raciocínio de fronteira com procura irregular muitas vezes não é. O modelo híbrido é normal: modelos alojados para os casos difíceis e pesos fixados em alojamento próprio para o núcleo previsível. Trata-se de um padrão geral, não de uma recomendação de qualquer produto de alojamento em particular.
Caixa: Kolibri, pesos abertos lançados a 3 de outubro. A Aleph Alpha anunciou o Kolibri a partir de Heidelberg a 5 de outubro de 2026, num comunicado de imprensa. O modelo está disponível desde 3 de outubro e suporta alemão e inglês. A empresa diz que foi concebido para ser implementado em infraestrutura controlada pelos clientes, com proveniência de dados e decisões de conceção documentadas. Suporta fluxos agênticos, geração aumentada por recuperação (RAG) e chamada nativa de ferramentas, e, segundo a Aleph Alpha, foi treinado para se abster quando os documentos fornecidos não contêm provas.
A estrutura, segundo a ficha do modelo no Hugging Face: um modelo mixture-of-experts com 78 mil milhões de parâmetros no total e cerca de 3,46 mil milhões ativos por token (o comunicado arredonda para cerca de 3 mil milhões). O contexto nativo é de 262 144 tokens; a ficha diz que a qualidade foi validada até cerca de um milhão de tokens, mas recomenda ficar nos 262 144 ou abaixo para eficiência de serviço.
A licença, verificada na ficha a 6 de outubro, é Apache 2.0 para os pesos e os ficheiros de configuração publicados nesse repositório. A ficha diz também o que a licença não abrange: código subjacente, arquitetura do modelo, definições de parâmetros ou qualquer método de treino. «Pesos abertos sob Apache 2.0» é a descrição correta. Chamar código aberto a toda a stack vai além do que a ficha afirma.
A realidade do hardware, também segundo a ficha: pesos FP8 com uma ocupação de memória de cerca de 78 GB e um mínimo indicado de duas A100 de 80 GB, duas H100 SXM5 ou uma H200, B200 ou B300. O serviço usa o pacote aleph-alpha-inference da Aleph Alpha, um plugin do vLLM, ou a respetiva imagem de contentor, e a ficha mostra uma API compatível com a OpenAI quando o modelo é servido dessa forma. Poucos parâmetros ativos reduzem a computação por token. Não reduzem a memória: o modelo inteiro continua a ter de caber.
Porque é que pertence aqui: nenhuma data de descontinuação de fornecedor se aplica aos pesos que aloja por conta própria, e o Kolibri é um exemplo atual e datado dessa opção para trabalho em alemão e inglês. Há três elementos de contexto importantes. A ficha diz que o modelo se destina a fluxos em que uma pessoa revê o resultado antes de se agir com base nele. O acordo da Aleph Alpha com a Cohere continua sujeito a aprovação regulatória, e a empresa continua a operar de forma independente até à conclusão. E «soberano», no comunicado da Aleph Alpha, é a palavra da empresa para controlo pelo cliente e liberdade de escolha. Não é uma certificação, e este artigo não reivindica nenhuma.
O calendário verificado, num parágrafo: a data de desativação dos snapshots legados e das linhas afinadas da OpenAI é 23 de outubro. A data de retirada dos IDs MaaS de modelos abertos da Google é 21 de outubro, com a implementação própria dos mesmos pesos como alternativa documentada pela própria Google. Para o Gemini 2.5 Pro, Flash e Flash-Lite no Google Cloud, a data de retirada é 16 ou 20 de outubro, consoante a página da Google que se leia, por isso planeie para 16. Na Snowflake Cortex, a data de fim de vida do claude-4-sonnet e do openai-gpt-4.1 é 14 de outubro.
A regra operacional não muda com o fornecedor. Um ID de modelo alojado é uma dependência com prazo de validade: fixe-o, inventarie-o, atribua-lhe um responsável e teste o substituto com o seu próprio tráfego antes da data. Os pesos abertos que executa não têm data de descontinuação imposta por um fornecedor, mas o ritmo das atualizações, o hardware e os patches passam a ser seus. O Kolibri é um exemplo datado de pesos abertos sob Apache 2.0, com uma licença que a respetiva ficha limita aos pesos e aos ficheiros de configuração do repositório.
Todas as páginas de fornecedores aqui citadas foram relidas a 6 de outubro de 2026, e o aviso da Snowflake a 9 de outubro de 2026. Se um fornecedor alterar uma data, este artigo será corrigido.