





















01
Necessari Sempre attivo
Indispensabili per il funzionamento del sito (login, preferenze, sicurezza). Sempre attivi.
Il 1° ottobre 2026 Cloudflare ha rilasciato i decision model Clef e Clef-flash e Strands Labs ha rilasciato Strands Decider 2B, tutti a pesi aperti sotto Apache 2.0. Ecco dove si inseriscono negli agenti di un MSP i decision model piccoli e calibrati, e dove si fermano.
Il 1° ottobre 2026 due aziende hanno pubblicato la stessa idea nello stesso giorno. Cloudflare ha rilasciato due decision model, Clef e Clef-flash, ospitati su Workers AI e pubblicati su Hugging Face sotto Apache 2.0. Lo stesso giorno Strands Labs ha rilasciato Strands Decider 2B, un decision model da due miliardi di parametri con pesi, dati di addestramento e script aperti sotto Apache 2.0.
Un decision model non scrive testo. Legge una situazione, lo «stato», e una serie di domande tipizzate, e restituisce una probabilità per ogni risposta ammessa, così il tuo codice può instradare un ticket, approvare o fermare una chiamata a uno strumento, o passare la mano a una persona. Entrambi i fornitori presentano il rilascio come risposta all'attenzione per il decision model Jev di Typesafe AI, ed entrambi dichiarano che i loro modelli sono compatibili con la sua API.
Una cornice vale per tutto ciò che segue: ogni numero di accuratezza e latenza in questo articolo è dichiarato dal fornitore. Questo include i 209 ms di mediana per Clef e i 39 ms per Clef-flash dichiarati da Cloudflare, e i circa 115 ms dichiarati da Strands su una RTX 3090 locale.
Per un MSP la parte interessante non è chi guida una classifica. È che le decisioni piccole, strutturate e ripetitive dentro un agente possono passare da un grande modello generalista a qualcosa di economico, calibrato ed eseguibile sul proprio hardware. L'articolo spiega cos'è un decision model, cosa ha rilasciato ciascun fornitore, dove si inserisce lo schema e dove si ferma.
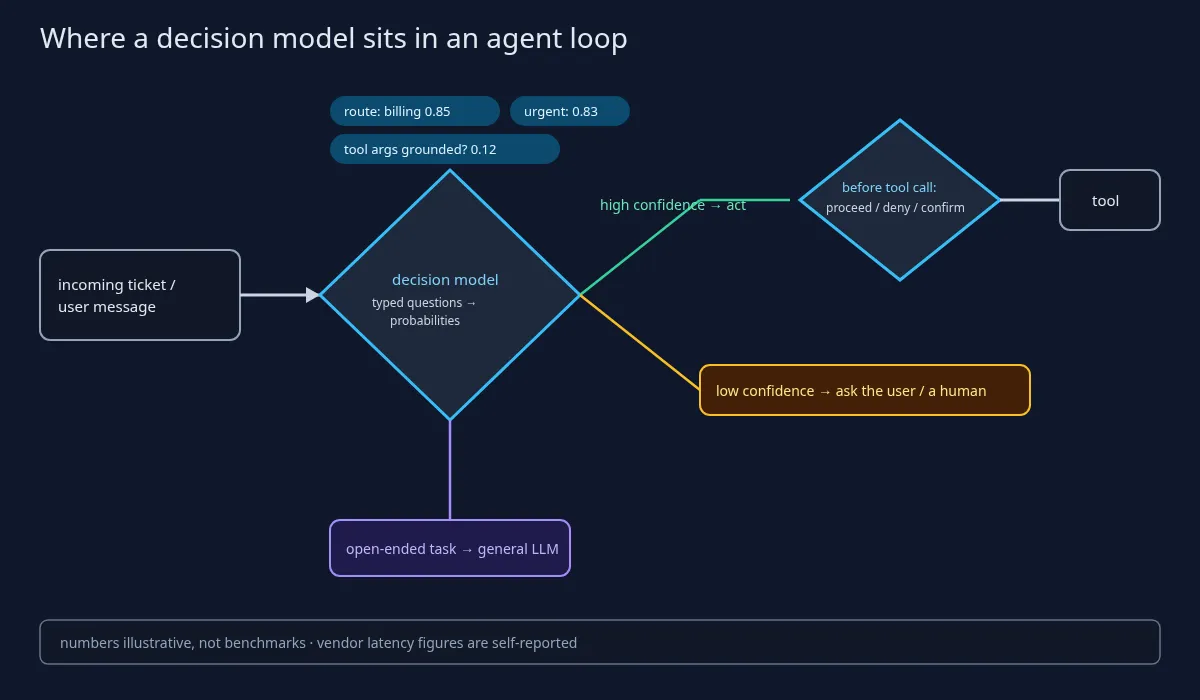
Entrambi i post descrivono la stessa interfaccia. Si passano uno stato, che può essere testo o JSON e, per Clef, immagini, e una serie di domande tipizzate. In entrambe le API la domanda sì/no si chiama noul, quella a scelta singola choice e la scala ordinata score. Il modello restituisce una probabilità per ogni opzione ammessa e risponde sempre tra le opzioni che gli sono state date.
È utile per due motivi. Una risposta da un insieme chiuso non richiede parsing dell'output e non può inventare una categoria nuova. E una probabilità permette al codice di fissare una soglia: sopra si agisce, sotto si chiede a una persona. Strands sottolinea che porre più domande sullo stesso input costa poco, quindi un solo passaggio può restituire il team di destinazione, un indicatore di urgenza e una verifica di fondatezza.
I fornitori descrivono la differenza rispetto a un modello linguistico in base a come viene prodotta la risposta. La decisione avviene in un unico passaggio parallelo sull'input invece che token per token, ed è da lì che vengono le promesse di velocità.
Conta altrettanto cosa un decision model non è. Per ammissione di Strands, il suo modello è molto più debole dei modelli di ragionamento sui problemi complessi, ed è inutile per codice, chat o riassunti perché non genera testo. È forte sulle scelte piccole e ripetute, non su quelle difficili.
I classificatori esistono da anni, e un lettore scettico lo farà notare. La proposta, come la inquadra il post di Cloudflare, è un solo modello che accetta categorie nuove al momento della richiesta senza riaddestramento: si cambia la domanda, non il modello.
Secondo il post di Cloudflare del 1° ottobre e la sua card su Hugging Face, i modelli rilasciati sono due: Clef e Clef-flash, ospitati su Workers AI e scaricabili sotto Apache 2.0. La card descrive Clef come un modello multimodale da 27B post-addestrato da Qwen3.8-27B, che legge testo, JSON, immagini o video e risponde in un solo passaggio in avanti, senza generazione libera. Il post dice che Clef-flash congela una base Qwen3.5-9B. Entrambi aggiungono una piccola testa di instradamento e adattatori low-rank di rango 256, addestrati con funzioni di perdita per la calibrazione.
Cloudflare indica due elementi che secondo l'azienda distinguono Clef: un encoder visivo, così le immagini possono far parte dello stato, e una finestra di contesto da 64k token, che contrappone ai 32k di Jev.
I numeri vengono da un'esecuzione interna della suite Decision Index condotta da Cloudflare stessa, e sono tutti dichiarati dal fornitore. Cloudflare dichiara un'accuratezza BFCL case-exact di 98,47 per Clef e di 98,76 per Clef-flash. Dichiara una latenza mediana di 209,3 ms per Clef e di 38,8 ms per Clef-flash, con un p95 dichiarato rispettivamente di 238,6 ms e 122,4 ms.
Le stesse tabelle mostrano anche il lato più debole. I dati dichiarati da Cloudflare stessa mostrano Clef dietro a Jev su insiemi di ragionamento più difficili come GPQA Diamond, MMLU-Pro e BBH. È coerente con lo schema: i decision model sono fatti per scelte chiuse, non per il ragionamento difficile.
Altre due affermazioni del fornitore, indicate come tali. In un aneddoto, Cloudflare dichiara che un flusso di classificazione di domini ha richiesto 2,2 secondi con Clef contro 4,7 secondi con gpt-oss-120b. Come promessa, Cloudflare dice di non leggere, conservare né usare per l'addestramento richieste e risposte, a meno che il cliente aderisca al suo servizio di fine-tuning.
Il self-hosting è possibile ma non leggero. L'esempio di riferimento della card è stato provato su una singola H200; Clef è un modello da 27B, non da portatile. Clef-flash e l'endpoint in hosting sono le strade più leggere. Cloudflare ha anche annunciato un servizio di fine-tuning con apprendimento per rinforzo, offerto prima tramite i suoi ingegneri forward-deployed e poi in self-service; il post non pubblica prezzi.
Secondo il post di Strands Labs del 1° ottobre e la sua card su Hugging Face, Strands Decider 2B è un decision model da due miliardi di parametri basato su Qwen3.5-2B, con la testa di generazione del testo rimossa e sostituita da una piccola testa a puntatore, poco più di un milione di parametri, che dà un punteggio a ogni opzione. Il tronco è affinato con una LoRA di rango 16. Il checkpoint rilasciato è la v19, dopo molte iterazioni la cui storia è nel repository.
L'apertura è la notizia. Il codice è su GitHub, i pesi sono su Hugging Face e, secondo Strands, lo sono anche tutti i dati e gli script usati per costruire il modello, sotto Apache 2.0. La card indica circa 11 ore per riaddestrarlo su una RTX 3090. Per un MSP che vuole adattare un decision model alle proprie categorie di ticket, questa riproducibilità è il punto.
I numeri sono dichiarati dal fornitore. Strands dichiara una mediana di circa 115 ms per decisioni locali su una RTX 3090, e la didascalia del grafico dice che la misura è stata presa sulla v18, non sulla v19. Dichiara circa 153 ms per compiti brevi su un MacBook M3. La card dichiara 167 compiti corretti su 231 nel set pubblico JevBench e marca quel risultato come «self-reported».
Strands pubblica i propri limiti, e vanno in ogni nota di adozione. I documenti lunghi e a più passaggi sono il punto debole. Le domande vengono lette con meno attenzione dei documenti. La calibrazione è stata stimata su compiti di classificazione brevi, quindi la card consiglia di misurare le soglie sul proprio traffico prima di fidarsene.
Una riga operativa che un MSP non deve perdere: secondo la card, il comando integrato strands-decider serve si lega a 127.0.0.1 e non ha autenticazione, e la card dice di usarlo per esperimenti locali. Così com'è, non va esposto su una rete condivisa.
L'esempio sviluppato nel post è un controllo prima della chiamata a uno strumento: gli argomenti dello strumento derivano da ciò che l'utente ha detto davvero, ed è troppo presto per agire? Strands lo definisce un'illustrazione e non una raccomandazione, e va letto così.
Qui sotto l'esempio di Strands tratto dalla sua model card, eseguito su una macchina locale. La card avverte che un riaddestramento dà numeri un po' diversi.
pip install strands-decider

strands-decider ask StrandsAgents/strands-decider-2B-hobson-v19 \
  --state "Help! My payouts have been failing for 3 days! " \
  --choice "Which team should handle this?=billing,sales,retail" \
  --noul "Does this convey urgency?"
Entrambi i fornitori indicano la stessa famiglia di impieghi, che si adatta bene alle operazioni degli agenti in un MSP: instradamento e urgenza dei ticket, instradamento tra modelli (mandare una richiesta a un modello economico o a uno costoso), scelta degli strumenti, controlli prima di una chiamata a uno strumento, classificazione di policy e triage degli alert. Sono le decisioni di routine in cui un LLM generalista è lento, costoso e più difficile da verificare.
Strands descrive chiaramente la forma ibrida: le decisioni difficili all'LLM, quelle di routine al decision model. Riduce costi e latenza solo se lo misuri sul tuo carico di lavoro. Qui non si offre alcuna cifra di risparmio, perché per il tuo carico non esiste finché non la misuri.
Controlli di adozione, dal lato di chi difende, ciascuno con la sua prova:
Cosa non fare: un decision model non deve essere l'unico cancello prima di un'azione irreversibile. Va affiancato da una policy deterministica o da una persona, come fa l'esempio stesso di Strands con le azioni proceed, deny e confirm.
Quattro cose che questo articolo non è.
Non è una recensione di Jev di Typesafe. Entrambi i fornitori citano Jev come innesco dei loro rilasci; l'articolo non l'ha provato e non riporta numeri di Jev se non come compaiono nelle tabelle di Cloudflare.
Non parla di Laminar flow-1, un piccolo modello che legge le tracce degli agenti per trovare errori. È un'altra notizia.
Non parla di Reflection Beam, un grande modello generalista annunciato con i pesi ancora in arrivo.
Non è un pezzo sui prezzi di Workers AI. Il post di Cloudflare non pubblica prezzi per Clef né per il servizio di fine-tuning, e l'articolo non ne inventa.
I fatti verificati: il 1° ottobre 2026 Cloudflare ha rilasciato Clef, un decision model multimodale da 27B post-addestrato da Qwen3.8-27B, e Clef-flash, su Workers AI e su Hugging Face sotto Apache 2.0, con un servizio di fine-tuning con apprendimento per rinforzo in arrivo. Lo stesso giorno Strands Labs ha rilasciato Strands Decider 2B, basato su Qwen3.5-2B con una LoRA e una testa a puntatore, con pesi, codice, dati di addestramento e script sotto Apache 2.0.
Ogni dato di accuratezza e latenza in questo articolo è dichiarato dal fornitore: il punteggio BFCL di 98,47 e la mediana di 209 ms dichiarati per Clef, la mediana di 38,8 ms dichiarata per Clef-flash, e il valore di circa 115 ms su RTX 3090 dichiarato da Strands per Decider. Le tabelle di Cloudflare stessa mostrano Clef indietro sui set di ragionamento più difficili.
La notizia è lo schema. Le decisioni chiuse e calibrate dentro un agente possono passare a piccoli modelli a pesi aperti eseguibili in proprio, con una persona o una policy deterministica dietro ogni passaggio a bassa confidenza o irreversibile. Misura sul tuo traffico prima di fidarti di qualunque soglia.