





















01
Necessari Sempre attivo
Indispensabili per il funzionamento del sito (login, preferenze, sicurezza). Sempre attivi.
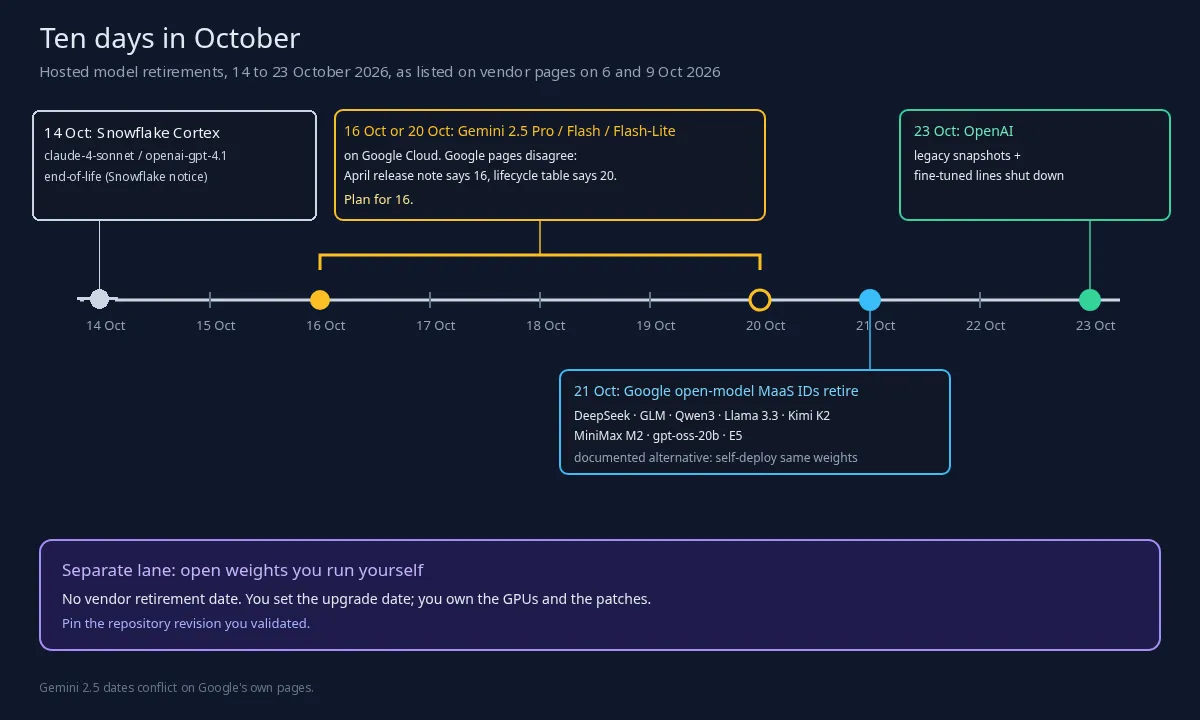
In dieci giorni di ottobre 2026 diversi ID di modelli in hosting arrivano alla data di ritiro: gli snapshot legacy di OpenAI il 23 ottobre, gli ID MaaS dei modelli aperti di Google il 21 ottobre, Gemini 2.5 su Google Cloud il 16 o il 20 ottobre e due modelli Snowflake Cortex il 14 ottobre. Fissa gli ID, assegna a ciascuno un responsabile e sappi quali pesi aperti potresti far girare in casa.
Si parte dal calendario. In dieci giorni di ottobre 2026 diversi ID di modelli in hosting arrivano alla data di ritiro. La pagina delle deprecazioni di OpenAI elenca un blocco di snapshot legacy e di linee fine-tuned con data di spegnimento fissata al 23 ottobre 2026. La tabella Model-as-a-Service dei modelli aperti di Google fissa al 21 ottobre la data di ritiro degli ID di DeepSeek, GLM, Qwen3, Llama 3.3, Kimi K2, MiniMax M2, gpt-oss-20b e degli embedding E5, e indica come alternativa il self-deploy degli stessi pesi. Su Gemini 2.5 Pro, Flash e Flash-Lite le pagine di Google non concordano: una release note di aprile dice 16 ottobre, mentre la tabella del ciclo di vita letta il 6 ottobre dice 20 ottobre. L'avviso di deprecazione di Snowflake fissa al 14 ottobre 2026 la fine del ciclo di vita di due modelli Cortex, claude-4-sonnet e openai-gpt-4.1.
La tesi sta in due frasi. Un ID di modello in hosting è una dipendenza con una data di scadenza, quindi va in un inventario con un responsabile con nome e cognome. I pesi aperti che fai girare tu non hanno una data di ritiro del fornitore, ma spostano su di te il calendario degli aggiornamenti, l'hardware e le patch.
Di seguito: il calendario fornitore per fornitore, cosa significa «ritirato» in pratica, sei abitudini per fissare gli ID dei modelli, i compromessi onesti del self-hosting e un riquadro su Kolibri di Aleph Alpha, rilasciato il 3 ottobre con pesi aperti sotto Apache 2.0. Ogni data qui sotto proviene dalla pagina di un fornitore: le pagine sono state rilette il 6 ottobre 2026, quella di Snowflake il 9 ottobre 2026.
OpenAI, 23 ottobre. La sezione del 22 aprile 2026 nella pagina delle deprecazioni di OpenAI elenca questi snapshot in spegnimento il 23 ottobre: gpt-3.5-turbo-0125, gpt-4-0613, gpt-4-turbo, gpt-4.1-nano, gpt-4o-2024-05-13, gpt-image-1, o1-2024-12-17, o1-pro-2025-03-19, o3-mini-2025-01-31, o4-mini-2025-04-16 e ft-o4-mini-2025-04-16, più le linee fine-tuned su gpt-3.5-turbo, gpt-4, gpt-4.1-nano, babbage-002 e davinci-002. I sostituti indicati da OpenAI sono la famiglia gpt-5.6-sol, gpt-5.6-terra e gpt-5.6-luna, con gpt-image-2.5-sunburst o gpt-image-2.5-flare al posto di gpt-image-1. Diverse righe riportano anche nomi correlati in una colonna separata, e la tabella non dice chiaramente se anche quei nomi smettono di funzionare. Quando una riga riporta nomi correlati, confronta con la pagina ogni nome che il tuo codice richiama.
Modelli aperti Google, 21 ottobre. La tabella delle deprecazioni MaaS dei modelli aperti di Google elenca DeepSeek (OCR, R1-0528, V3.1 e V3.2), GLM (5 e 4.7), gpt-oss-20b, Kimi K2 Thinking, Llama 3.3 70B Instruct, MiniMax M2, due modelli di embedding E5 multilingue e quattro varianti Qwen3: 16 ID di modello in tutto, con data di ritiro il 21 ottobre. Tutti sono stati deprecati il 21 luglio, e ogni riga indica come alternativa il self-deploy del modello su Model Garden.
Gemini 2.5 su Google Cloud, 16 o 20 ottobre. Una release note di aprile indicava il 16 ottobre; la tabella del ciclo di vita di Google letta il 6 ottobre mostra il 20 ottobre. Pianifica sulla data più vicina e controlla la pagina del ciclo di vita per il tuo progetto. Nel dettaglio: una release note di Vertex AI di circa il 2 aprile 2026 dice che le date di ritiro di Gemini 2.5 Pro, Flash-Lite e Flash «sono state aggiornate al 16 ottobre 2026» (traduzione nostra). La tabella delle versioni e del ciclo di vita pubblicata online indica il 20 ottobre per tutti e tre, con sostituti come gemini-3.8-flash, gemini-3.5-flash, gemini-3.5-flash-lite e gemini-3.1-flash-lite. Non abbiamo trovato una nota successiva che spieghi la differenza. La pagina delle deprecazioni della Gemini API di Google non annuncia alcuna data di spegnimento per questi tre modelli: la scadenza dipende quindi da quale superficie Google chiama il carico di lavoro.
Snowflake Cortex, 14 ottobre. L'avviso di Snowflake sulle deprecazioni dei modelli Cortex indica il 14 ottobre 2026 come data di fine del ciclo di vita (end-of-life) di claude-4-sonnet e openai-gpt-4.1, passati allo stato legacy il 12 agosto 2026. Dopo questa data, le query e le chiamate API che indicano uno dei due modelli non vanno a buon fine.
ChatGPT e Codex, 14 ottobre. Il changelog ufficiale di ChatGPT e Codex di OpenAI, in una voce datata 14 settembre 2026, fissa al 14 ottobre 2026 la data in cui GPT-5.5 viene ritirato da ChatGPT, ChatGPT Work e Codex su tutti i piani, compresi Business, Enterprise ed Edu. La stessa voce precisa che il ritiro non riguarda l'API di OpenAI, quindi le chiamate API a gpt-5.5 non ne sono toccate. In Codex, le impostazioni predefinite dei workspace, le impostazioni di modello salvate, gli agenti personalizzati, le attività pianificate e gli script che selezionano ancora gpt-5.5 devono passare a un modello sostitutivo.
Il calendario non si ferma a ottobre. Le prossime date OpenAI già presenti sulla pagina sono il 1° dicembre per i modelli GPT Image e l'11 dicembre per gli snapshot datati di GPT-5 e o3.
«Ritirato» suona come una formalità. In produzione significa errori. La pagina di Google sui modelli aperti definisce due fasi. Durante il periodo di deprecazione l'endpoint continua a funzionare per i carichi esistenti, così si può migrare, ma il nuovo utilizzo dell'endpoint può essere limitato. Alla data di ritiro l'endpoint viene disattivato e le richieste API che chiamano un ID ritirato falliscono.
La formulazione di OpenAI è più breve: allo spegnimento il modello o l'endpoint non è più accessibile. Una regola della stessa pagina coglie spesso di sorpresa i team. L'inferenza su un modello fine-tuned si ferma quando viene deprecato il modello base, quindi un fine-tune dura quanto la base su cui è stato addestrato. Il cliente che l'anno scorso ha pagato un fine-tune ha comprato qualcosa che porta la data di scadenza del modello base.
I preavvisi cambiano a seconda della fase. La pagina di OpenAI garantisce almeno sei mesi per i modelli in disponibilità generale, almeno tre mesi per le varianti specializzate e anche solo circa due settimane per i modelli con preview nel nome. Google mantiene disponibili i modelli aperti in fase Preview per almeno 45 giorni dal rilascio. La regola pratica: gli ID preview non stanno su un percorso critico verso il cliente, a meno che il contratto preveda una migrazione rapida.
Esiste una via d'uscita, ed è commerciale. OpenAI scrive che alcuni sviluppatori possono concordare con il suo team commerciale capacità dedicata per continuare ad accedere dopo la data di spegnimento. È una trattativa, non un'impostazione predefinita, e non dovrebbe essere il piano.
In un parco MSP raramente si rompe l'app di punta. Si rompe il riassuntore dimenticato in un'integrazione di ticketing, il job di embedding dietro un indice di ricerca, il fine-tune che un cliente ha pagato l'anno scorso. Il ritiro di un modello di embedding pesa doppio: un nuovo modello di embedding di solito significa reindicizzare il corpus, non solo cambiare un nome in un file di configurazione.
Una riga d'inventario richiede un ID fissato, la data, un sostituto in prova e un responsabile con nome. Lo YAML illustrativo qui sotto mostra la forma; ogni nome è un segnaposto.
# model-inventory.yaml: one row per call site, reviewed monthly
- call_site: ticket-summarizer
  provider: openai
  model_id: o4-mini-2025-04-16        # listed for shutdown 2026-10-23
  replacement_under_test: gpt-5.6-terra
  owner: platform-team
  eval_set: summaries-golden-v3
  cutover_ticket: CHG-0000
- call_site: kb-search-embeddings
  provider: google-maas
  model_id: multilingual-e5-large-instruct-maas   # retires 2026-10-21
  plan: self-deploy same weights OR switch model + re-index
  owner: search-team
Fissare gli ID non è un prodotto. Sono sei abitudini, ciascuna con qualcosa che vale come prova.
1. In produzione chiama snapshot datati, non nomi flottanti. Un nome flottante può passare a un nuovo modello a tua insaputa. Un ID datato cambia solo quando lo cambi tu. Prova: la configurazione in esercizio mostra l'ID datato. Non è una prova: «usiamo l'ultimo».
2. Una riga d'inventario per ogni punto di chiamata, con fornitore, ID esatto, responsabile, data di ritiro e sostituto in prova. Cerca nel codice, nella configurazione dell'infrastruttura e nelle automazioni low-code, non solo nell'applicazione principale. I punti di chiamata che fanno male sono di solito quelli costruiti fuori dal repository principale.
3. Iscriviti alla fonte ufficiale. Cioè le pagine di deprecazione dei fornitori e le email dell'account che inviano. Una newsletter di rassegna è una segnalazione, non una fonte. Questo articolo lo dimostra: una pagina Google contraddice un'altra pagina Google su Gemini 2.5.
4. Prova il sostituto sul tuo traffico con un piccolo set di riferimento prima del passaggio: formato dell'output, rifiuti, latenza e costo per attività. Mai dare per scontato che il «sostituto consigliato» si comporti come il modello che sostituisce.
5. Passa al nuovo modello prima della data, con una finestra di rollback che finisce prima della data. Tornare a un ID ritirato non è un rollback. Se la data plausibile più vicina è il 16 ottobre, la finestra di rollback si chiude prima del 16 ottobre.
6. Tratta i cambi di default come rilasci. Quando un fornitore cambia il modello a cui punta un nome predefinito, fattura e comportamento possono muoversi senza che cambi alcun prezzo. Fissare l'ID trasforma quel cambio in una modifica pianificata, con un ticket, un test e un responsabile.
La prova più netta che l'accesso in hosting e il modello sono due cose diverse arriva da Google. Per ogni modello aperto con data di ritiro il 21 ottobre, la tabella di Google stessa documenta l'alternativa: installare in proprio gli stessi pesi su Model Garden. L'endpoint sparisce, i pesi no.
Cosa si guadagna è preciso. I pesi che scarichi e servi non spariscono perché un fornitore ritira un endpoint. Decidi tu quando aggiornare e puoi mantenere la revisione esatta che hai validato. Fissa la revisione del repository che hai provato, non solo il nome del modello, perché un repository di modelli può cambiare dopo il tuo primo download.
Cosa ti prendi in carico è altrettanto preciso: GPU o capacità riservata, uno stack di serving e i suoi aggiornamenti, monitoraggio, la tua valutazione prima di ogni aggiornamento e le patch di sicurezza di tutto ciò che sta intorno al modello. È un costo operativo reale. La cifra dipende dal tuo carico di lavoro e dai tuoi contratti, quindi questo articolo non la quantifica.
Le licenze cambiano. Alcuni modelli aperti escono sotto Apache 2.0, altri con licenze personalizzate e condizioni proprie su uso, attribuzione o scala. Leggi la licenza del repository esatto prima che un cliente ne dipenda e conservane una copia accanto alla riga d'inventario.
Dove ha senso per un MSP? Carichi stabili e ben definiti, come classificazione, estrazione e ricerca sui documenti del cliente, sono buoni candidati. Il ragionamento di frontiera con domanda a picchi spesso no. L'ibrido è normale: modelli in hosting per la coda difficile, pesi in casa fissati per il nucleo prevedibile. È uno schema generale, non la raccomandazione di un prodotto di hosting specifico.
Riquadro: Kolibri, pesi aperti rilasciati il 3 ottobre. Aleph Alpha ha annunciato Kolibri da Heidelberg il 5 ottobre 2026 con un comunicato stampa. Il modello è disponibile dal 3 ottobre e supporta tedesco e inglese. L'azienda dice che è pensato per girare su infrastruttura controllata dal cliente, con provenienza dei dati e scelte progettuali documentate. Supporta flussi agentici, generazione aumentata dal recupero (RAG) e chiamata nativa di strumenti, e secondo Aleph Alpha è stato addestrato ad astenersi quando i documenti forniti non contengono prove sufficienti.
La forma, dalla model card su Hugging Face: un modello mixture-of-experts con 78 miliardi di parametri totali e circa 3,46 miliardi attivi per token (il comunicato arrotonda a circa 3 miliardi). Il contesto nativo è di 262.144 token; la card dice che la qualità è stata validata fino a circa un milione di token, ma consiglia di restare entro 262.144 per efficienza di servizio.
La licenza, verificata sulla card il 6 ottobre, è Apache 2.0 per i pesi e i file di configurazione pubblicati in quel repository. La card dice anche a cosa la concessione non si estende: codice sottostante, architettura del modello, impostazioni dei parametri e qualsiasi metodo di addestramento. «Pesi aperti sotto Apache 2.0» è la descrizione corretta. Definire open source l'intero stack va oltre ciò che la card afferma.
L'hardware reale, sempre dalla card: pesi FP8 con un ingombro di memoria di circa 78 GB e un minimo indicato di due A100 da 80 GB, due H100 SXM5, oppure una H200, B200 o B300. Per servirlo si usa il pacchetto aleph-alpha-inference di Aleph Alpha, un plugin di vLLM, o la sua immagine container, e la card mostra un'API compatibile OpenAI una volta che il modello è servito in quel modo. Pochi parametri attivi abbassano il calcolo per token. Non riducono la memoria: il modello intero deve comunque starci.
Perché sta in questo articolo: sui pesi che ospiti in proprio non pesa alcuna data di ritiro del fornitore, e Kolibri è un esempio attuale e datato di questa opzione per il lavoro in tedesco e in inglese. Contano tre righe di contesto. La card dice che il modello è pensato per flussi in cui una persona rivede l'output prima che venga usato. L'accordo tra Aleph Alpha e Cohere è ancora soggetto ad approvazione regolatoria, e l'azienda continua a operare in modo indipendente fino al closing. E «sovrano», nel comunicato di Aleph Alpha, è la parola dell'azienda per controllo del cliente e libertà di scelta. Non è una certificazione, e questo articolo non ne rivendica alcuna.
Il calendario verificato, in un paragrafo: per snapshot legacy e linee fine-tuned di OpenAI la data di spegnimento è il 23 ottobre. Per gli ID MaaS dei modelli aperti di Google la data di ritiro è il 21 ottobre, con il self-deploy degli stessi pesi come alternativa documentata da Google stessa. Per Gemini 2.5 Pro, Flash e Flash-Lite su Google Cloud la data di ritiro è il 16 o il 20 ottobre a seconda della pagina Google che si legge, quindi pianifica sul 16. Per claude-4-sonnet e openai-gpt-4.1 su Snowflake Cortex la data di fine del ciclo di vita è il 14 ottobre.
La regola operativa non cambia con il fornitore. Un ID di modello in hosting è una dipendenza con una scadenza: va fissato, inventariato, affidato a un responsabile, e il sostituto va provato sul proprio traffico prima della data. I pesi aperti che fai girare non hanno data di ritiro del fornitore, ma calendario degli aggiornamenti, hardware e patch diventano tuoi. Kolibri è un esempio datato di pesi aperti sotto Apache 2.0, con una licenza che la sua model card limita ai pesi e ai file di configurazione del repository.
Tutte le pagine dei fornitori citate sono state rilette il 6 ottobre 2026, l'avviso di Snowflake il 9 ottobre 2026. Se un fornitore sposta una data, questo articolo sarà corretto.