





















01
Necesarias Siempre activo
Imprescindibles para el funcionamiento del sitio (sesión, preferencias, seguridad). Siempre activas.
En diez días de octubre de 2026, varios IDs de modelos alojados llegan a su fecha de retirada: las instantáneas heredadas de OpenAI el 23 de octubre, los IDs de MaaS de modelos abiertos de Google el 21 de octubre, Gemini 2.5 en Google Cloud el 16 o el 20 de octubre y dos modelos de Snowflake Cortex el 14 de octubre. Fija los IDs, asigna un responsable a cada uno y averigua qué pesos abiertos podrías ejecutar tú mismo.
Empieza por el calendario. A lo largo de diez días de octubre de 2026, varios IDs de modelos alojados llegan a su fecha de retirada. La página de descontinuaciones de OpenAI enumera un bloque de instantáneas heredadas y líneas afinadas cuya fecha de cierre es el 23 de octubre de 2026. La tabla de Model-as-a-Service de modelos abiertos de Google fija el 21 de octubre como fecha de retirada de los IDs de DeepSeek, GLM, Qwen3, Llama 3.3, Kimi K2, MiniMax M2, gpt-oss-20b y los embeddings E5, y señala como alternativa desplegar uno mismo los mismos pesos. Las propias páginas de Google no coinciden sobre Gemini 2.5 Pro, Flash y Flash-Lite: una nota de versión de abril dice 16 de octubre, mientras que la tabla del ciclo de vida consultada el 6 de octubre dice 20 de octubre. El aviso de descontinuación de la propia Snowflake fija el 14 de octubre de 2026 como fecha de fin de vida de dos modelos de Cortex, claude-4-sonnet y openai-gpt-4.1.
La tesis cabe en dos frases. Un ID de modelo alojado es una dependencia con fecha de caducidad, así que debe figurar en un inventario con un responsable con nombre y apellidos. Los pesos abiertos que ejecutas tú mismo no tienen fecha de retirada de un proveedor, pero trasladan a ti el ritmo de actualizaciones, el hardware y los parches.
Lo que sigue: el calendario proveedor por proveedor, qué significa «retirado» en la práctica, seis hábitos para fijar los IDs de modelos, las contrapartidas honestas de autoalojar y un recuadro sobre Kolibri de Aleph Alpha, publicado el 3 de octubre con pesos abiertos bajo Apache 2.0. Cada fecha de las siguientes procede de la página de un proveedor; esas páginas se volvieron a consultar el 6 de octubre de 2026, y la de Snowflake, el 9 de octubre de 2026.
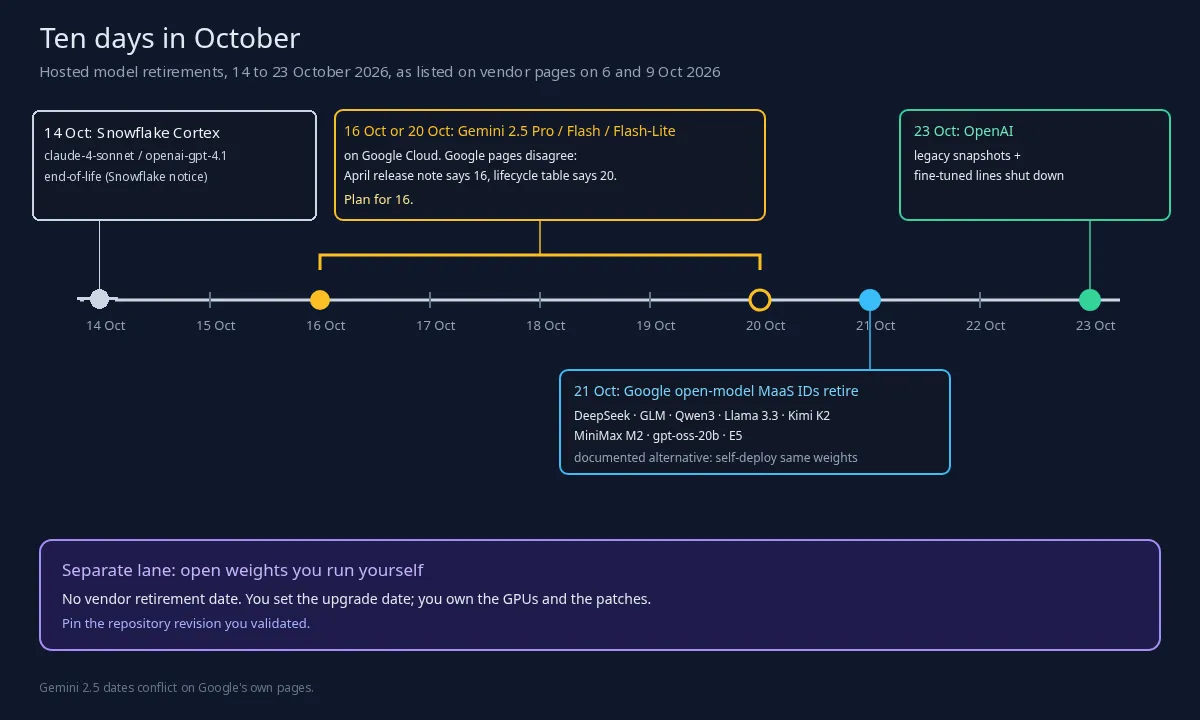
OpenAI, 23 de octubre. La sección de la página de descontinuaciones de OpenAI fechada el 22 de abril de 2026 enumera estas instantáneas para su apagado el 23 de octubre: gpt-3.5-turbo-0125, gpt-4-0613, gpt-4-turbo, gpt-4.1-nano, gpt-4o-2024-05-13, gpt-image-1, o1-2024-12-17, o1-pro-2025-03-19, o3-mini-2025-01-31, o4-mini-2025-04-16 y ft-o4-mini-2025-04-16, además de líneas afinadas sobre gpt-3.5-turbo, gpt-4, gpt-4.1-nano, babbage-002 y davinci-002. Los sustitutos que indica OpenAI son la familia gpt-5.6-sol, gpt-5.6-terra y gpt-5.6-luna, con gpt-image-2.5-sunburst o gpt-image-2.5-flare en lugar de gpt-image-1. Varias filas incluyen también nombres relacionados en una columna aparte, y la tabla no aclara si esos nombres también dejan de funcionar. Cuando una fila incluya nombres relacionados, comprueba en la página cada nombre al que llama tu código.
Modelos abiertos de Google, 21 de octubre. La tabla de descontinuaciones de MaaS de modelos abiertos de Google enumera DeepSeek (OCR, R1-0528, V3.1 y V3.2), GLM (5 y 4.7), gpt-oss-20b, Kimi K2 Thinking, Llama 3.3 70B Instruct, MiniMax M2, dos modelos de embedding E5 multilingües y cuatro variantes de Qwen3: 16 IDs de modelo en total, con fecha de retirada el 21 de octubre. Todos quedaron obsoletos el 21 de julio, y cada fila señala como alternativa desplegar uno mismo el modelo en Model Garden.
Gemini 2.5 en Google Cloud, 16 o 20 de octubre. Una nota de versión de abril fijó el 16 de octubre; la tabla del ciclo de vida de Google consultada el 6 de octubre muestra el 20 de octubre. Planifica para la fecha más temprana y revisa la página del ciclo de vida de tu proyecto. En detalle: una nota de versión de Vertex AI de alrededor del 2 de abril de 2026 dice que las fechas de retirada de Gemini 2.5 Pro, Flash-Lite y Flash «se han actualizado al 16 de octubre de 2026» (traducción nuestra). La tabla de versiones y ciclo de vida de los modelos publicada actualmente muestra el 20 de octubre para los tres, con sustitutos como gemini-3.8-flash, gemini-3.5-flash, gemini-3.5-flash-lite y gemini-3.1-flash-lite. No encontramos ninguna nota posterior que explique la diferencia. La página de descontinuaciones de la API de Gemini de Google no anuncia fecha de apagado para estos tres modelos, así que el plazo depende de qué superficie de Google llame cada carga de trabajo.
Snowflake Cortex, 14 de octubre. El aviso de Snowflake sobre descontinuaciones de modelos de Cortex indica el 14 de octubre de 2026 como fecha de fin de vida de claude-4-sonnet y openai-gpt-4.1, que pasaron al estado heredado (legacy) el 12 de agosto de 2026. Tras el fin de vida, las consultas y llamadas a la API que nombran cualquiera de los dos modelos fallan.
ChatGPT y Codex, 14 de octubre. El registro de cambios oficial de ChatGPT y Codex de OpenAI, en una entrada fechada el 14 de septiembre de 2026, fija el 14 de octubre de 2026 como la fecha en que GPT-5.5 se retira de ChatGPT, ChatGPT Work y Codex en todos los planes, incluidos Business, Enterprise y Edu. La misma entrada indica que la retirada no se aplica a la API de OpenAI, por lo que las llamadas a la API que usan gpt-5.5 no se ven afectadas. En Codex, los valores predeterminados del espacio de trabajo, los ajustes de modelo guardados, los agentes personalizados, las tareas programadas y los scripts que aún seleccionan gpt-5.5 necesitan un modelo de sustitución.
El calendario no se detiene en octubre. Las siguientes fechas de OpenAI que ya figuran en la página son el 1 de diciembre para los modelos GPT Image y el 11 de diciembre para las instantáneas fechadas de GPT-5 y o3.
«Retirado» suena a trámite administrativo. En producción significa errores. La página de Google sobre modelos abiertos define dos etapas. Durante el periodo de descontinuación, el endpoint sigue funcionando para las cargas existentes para que puedas migrar, pero el uso nuevo del endpoint puede restringirse. En la fecha de retirada, el endpoint se desactiva y las solicitudes de API que llaman a un ID retirado fallan.
La formulación de OpenAI es más breve: en el apagado, un modelo o endpoint deja de estar accesible. Una regla de la misma página pilla por sorpresa a muchos equipos. La inferencia sobre un modelo afinado se detiene cuando su modelo base queda obsoleto, así que un modelo afinado solo dura lo que dure la base sobre la que se entrenó. El cliente que pagó un afinado el año pasado compró algo que lleva la fecha de caducidad del modelo base.
Los plazos de aviso varían según la etapa. La página de OpenAI se compromete a al menos seis meses para los modelos de disponibilidad general, al menos tres meses para las variantes especializadas y, posiblemente, apenas unas dos semanas para los modelos con preview en el nombre. Google mantiene disponibles los modelos abiertos en fase preliminar durante al menos 45 días desde su lanzamiento. La regla práctica: los IDs preview no deben estar en una ruta crítica de cara al cliente, salvo que el contrato permita una migración rápida.
Existe una vía de escape, y es comercial. OpenAI dice que algunos desarrolladores pueden acordar con su equipo de ventas capacidad dedicada para seguir accediendo tras una fecha de apagado. Es una negociación, no lo predeterminado, y no debería ser el plan.
Lo que se rompe en el parque de un MSP rara vez es la aplicación estrella. Es el resumidor olvidado en una integración de ticketing, el trabajo de embeddings detrás de un índice de búsqueda o el modelo afinado que un cliente pagó el año pasado. Las retiradas de modelos de embedding cuentan doble: un nuevo modelo de embedding suele implicar reindexar el corpus, no solo cambiar un nombre en un archivo de configuración.
Una fila del inventario necesita un ID fijado, la fecha, un sustituto en pruebas y un responsable con nombre. El YAML ilustrativo de abajo muestra la forma; todos los nombres que contiene son marcadores de posición.
# model-inventory.yaml: one row per call site, reviewed monthly
- call_site: ticket-summarizer
  provider: openai
  model_id: o4-mini-2025-04-16        # listed for shutdown 2026-10-23
  replacement_under_test: gpt-5.6-terra
  owner: platform-team
  eval_set: summaries-golden-v3
  cutover_ticket: CHG-0000
- call_site: kb-search-embeddings
  provider: google-maas
  model_id: multilingual-e5-large-instruct-maas   # retires 2026-10-21
  plan: self-deploy same weights OR switch model + re-index
  owner: search-team
Fijar IDs no es un producto. Son seis hábitos, cada uno con algo que cuenta como prueba.
1. En producción, llama a instantáneas fechadas, no a nombres flotantes. Un nombre flotante puede pasar a otro modelo sin que te enteres. Un ID fechado solo cambia cuando tú lo cambias. Prueba: la configuración desplegada muestra el ID fechado. No es prueba: «usamos el último».
2. Mantén una fila de inventario por cada punto de llamada, con proveedor, ID exacto, responsable, fecha de retirada y sustituto en pruebas. Busca en el código, en la configuración de infraestructura y en las automatizaciones low-code, no solo en la aplicación principal. Los puntos de llamada que hacen daño suelen ser los construidos fuera del repositorio principal.
3. Suscríbete a la fuente oficial. Es decir, las páginas de descontinuación de los proveedores y los correos de cuenta que envían. Un boletín recopilatorio es una pista, no una fuente. Este artículo lo demuestra: una página de Google contradice a otra página de Google sobre Gemini 2.5.
4. Prueba el sustituto con tu propio tráfico y un pequeño conjunto de referencia antes del cambio: formato de salida, rechazos, latencia y coste por tarea. Nunca des por hecho que un «sustituto recomendado» se comporta igual que el modelo al que sustituye.
5. Haz el cambio antes de la fecha, con una ventana de reversión que termine antes de la fecha. Volver a un ID retirado no es una reversión. Si la fecha plausible más temprana es el 16 de octubre, la ventana de reversión se cierra antes del 16 de octubre.
6. Trata los cambios de valores predeterminados como lanzamientos. Cuando un proveedor cambia el modelo al que apunta un nombre predeterminado, la factura y el comportamiento pueden variar sin ningún cambio de precio. Fijar el ID es lo que convierte eso en un cambio planificado, con un ticket, una prueba y un responsable.
La prueba más clara de que el acceso alojado y el propio modelo son cosas distintas viene de Google. Para cada modelo abierto con fecha de retirada el 21 de octubre, la propia tabla de Google documenta la alternativa: desplegar tú mismo los mismos pesos en Model Garden. El endpoint desaparece; los pesos no.
Lo que ganas es concreto. Los pesos que descargas y sirves no desaparecen porque un proveedor retire un endpoint. Tú eliges cuándo actualizar y puedes conservar la revisión exacta que validaste. Fija la revisión del repositorio que probaste, no solo el nombre del modelo, porque un repositorio de modelos puede cambiar después de tu primera descarga.
Lo que asumes es igual de concreto: GPU o capacidad reservada, una pila de servicio y sus actualizaciones, monitorización, tu propia evaluación antes de cada actualización y los parches de seguridad de todo lo que rodea al modelo. Es un coste operativo real. La cifra depende de tu carga de trabajo y de tus contratos, así que este artículo no la cuantifica.
Las licencias difieren. Algunos modelos abiertos se publican bajo Apache 2.0; otros usan licencias propias con sus propias condiciones de uso, atribución o escala. Lee la licencia del repositorio exacto antes de que un cliente dependa de él y guarda una copia junto a la fila del inventario.
¿Dónde encaja para un MSP? Las cargas estables y bien definidas, como clasificación, extracción y búsqueda sobre los propios documentos de un cliente, son buenas candidatas. El razonamiento de frontera con demanda a picos a menudo no lo es. Lo híbrido es lo normal: modelos alojados para los casos difíciles y pesos autoalojados y fijados para el núcleo previsible. Es un patrón general, no una recomendación de ningún producto de alojamiento concreto.
Recuadro: Kolibri, pesos abiertos publicados el 3 de octubre. Aleph Alpha anunció Kolibri desde Heidelberg el 5 de octubre de 2026 en un comunicado de prensa. El modelo está disponible desde el 3 de octubre y admite alemán e inglés. La empresa dice que está diseñado para desplegarse en infraestructura que controlan los clientes, con procedencia de datos y decisiones de diseño documentadas. Admite flujos agénticos, generación aumentada por recuperación (RAG) y llamada nativa a herramientas, y según Aleph Alpha se entrenó para abstenerse cuando los documentos proporcionados no contienen pruebas.
Su forma, según la ficha del modelo en Hugging Face: un modelo mixture-of-experts con 78.000 millones de parámetros en total y unos 3460 millones activos por token (el comunicado lo redondea a unos 3000 millones). El contexto nativo es de 262.144 tokens; la ficha dice que la calidad se validó hasta aproximadamente un millón de tokens, pero recomienda no superar los 262.144 por eficiencia de servicio.
La licencia, verificada en la ficha el 6 de octubre, es Apache 2.0 para los pesos y los archivos de configuración publicados en ese repositorio. La ficha también indica a qué no se extiende la licencia: el código subyacente, la arquitectura del modelo, la configuración de parámetros ni ningún método de entrenamiento. «Pesos abiertos bajo Apache 2.0» es la descripción correcta. Llamar código abierto a toda la pila va más allá de lo que afirma la ficha.
La realidad del hardware, de nuevo según la ficha: pesos FP8 con una huella de memoria de unos 78 GB y un mínimo indicado de dos A100 de 80 GB, dos H100 SXM5 o una H200, B200 o B300. Para servirlo se usa el paquete aleph-alpha-inference de Aleph Alpha, un plugin de vLLM, o su imagen de contenedor, y la ficha muestra una API compatible con OpenAI una vez servido así. Pocos parámetros activos reducen el cómputo por token. No reducen la memoria: el modelo completo tiene que caber igualmente.
Por qué encaja aquí: a los pesos que alojas tú mismo no se les aplica ninguna fecha de retirada de un proveedor, y Kolibri es un ejemplo actual y fechado de esa opción para trabajo en alemán e inglés. Importan tres datos de contexto. La ficha dice que el modelo está pensado para flujos en los que una persona revisa el resultado antes de actuar en consecuencia. El acuerdo de Aleph Alpha con Cohere sigue sujeto a aprobación regulatoria, y la empresa continúa operando de forma independiente hasta el cierre. Y «soberano», en el comunicado de Aleph Alpha, es la palabra de la empresa para el control del cliente y la libertad de elección. No es una certificación, y este artículo no reivindica ninguna.
El calendario verificado, en un párrafo: la fecha de cierre de las instantáneas heredadas y las líneas afinadas de OpenAI es el 23 de octubre. La fecha de retirada de los IDs de MaaS de modelos abiertos de Google es el 21 de octubre, con el despliegue propio de los mismos pesos como alternativa documentada por la propia Google. Para Gemini 2.5 Pro, Flash y Flash-Lite en Google Cloud, la fecha de retirada es el 16 o el 20 de octubre según la página de Google que se lea, así que planifica para el 16. En Snowflake Cortex, la fecha de fin de vida de claude-4-sonnet y openai-gpt-4.1 es el 14 de octubre.
La regla operativa no cambia con el proveedor. Un ID de modelo alojado es una dependencia con fecha de caducidad: fíjalo, inventárialo, asígnale un responsable y prueba el sustituto con tu propio tráfico antes de la fecha. Los pesos abiertos que ejecutas no tienen fecha de retirada de un proveedor, pero el ritmo de actualizaciones, el hardware y los parches pasan a ser cosa tuya. Kolibri es un ejemplo fechado de pesos abiertos bajo Apache 2.0, con una licencia que su ficha limita a los pesos y archivos de configuración del repositorio.
Todas las páginas de proveedores citadas aquí se volvieron a consultar el 6 de octubre de 2026, y el aviso de Snowflake, el 9 de octubre de 2026. Si un proveedor cambia una fecha, este artículo se corregirá.