





















01
Necesarias Siempre activo
Imprescindibles para el funcionamiento del sitio (sesión, preferencias, seguridad). Siempre activas.
El 1 de octubre de 2026, Cloudflare lanzó los modelos de decisión Clef y Clef-flash y Strands Labs lanzó Strands Decider 2B, todos de pesos abiertos bajo Apache 2.0. Aquí se explica dónde encajan los modelos de decisión pequeños y calibrados en los agentes de un MSP, y dónde se detienen.
El 1 de octubre de 2026, dos empresas publicaron la misma idea el mismo día. Cloudflare lanzó dos modelos de decisión, Clef y Clef-flash, alojados en Workers AI y publicados en Hugging Face con licencia Apache 2.0. Ese mismo día, Strands Labs lanzó Strands Decider 2B, un modelo de decisión de dos mil millones de parámetros cuyos pesos, datos de entrenamiento y scripts son abiertos bajo Apache 2.0.
Un modelo de decisión no escribe texto. Lee una situación, el «estado», y una serie de preguntas tipadas, y devuelve una probabilidad para cada respuesta permitida, de modo que tu código pueda enrutar un ticket, aprobar o retener una llamada a una herramienta o pasar el caso a una persona. Ambos proveedores presentan su lanzamiento como respuesta a la atención en torno a Jev, el modelo de decisión de Typesafe AI, y ambos dicen que sus modelos son compatibles con su API.
Un marco se aplica a todo lo que sigue: cada cifra de precisión y latencia de este artículo la declara el proveedor. Eso incluye la mediana de 209 ms que Cloudflare declara para Clef y de 39 ms para Clef-flash, y los unos 115 ms que Strands declara en una RTX 3090 local.
Para un MSP, lo interesante no es quién encabeza una clasificación. Es que las decisiones pequeñas, estructuradas y repetibles dentro de un agente pueden pasar de un modelo general grande a algo barato, calibrado y ejecutable en tu propio hardware. Este artículo explica qué es un modelo de decisión, qué ha lanzado cada proveedor, dónde encaja el patrón y dónde se detiene.
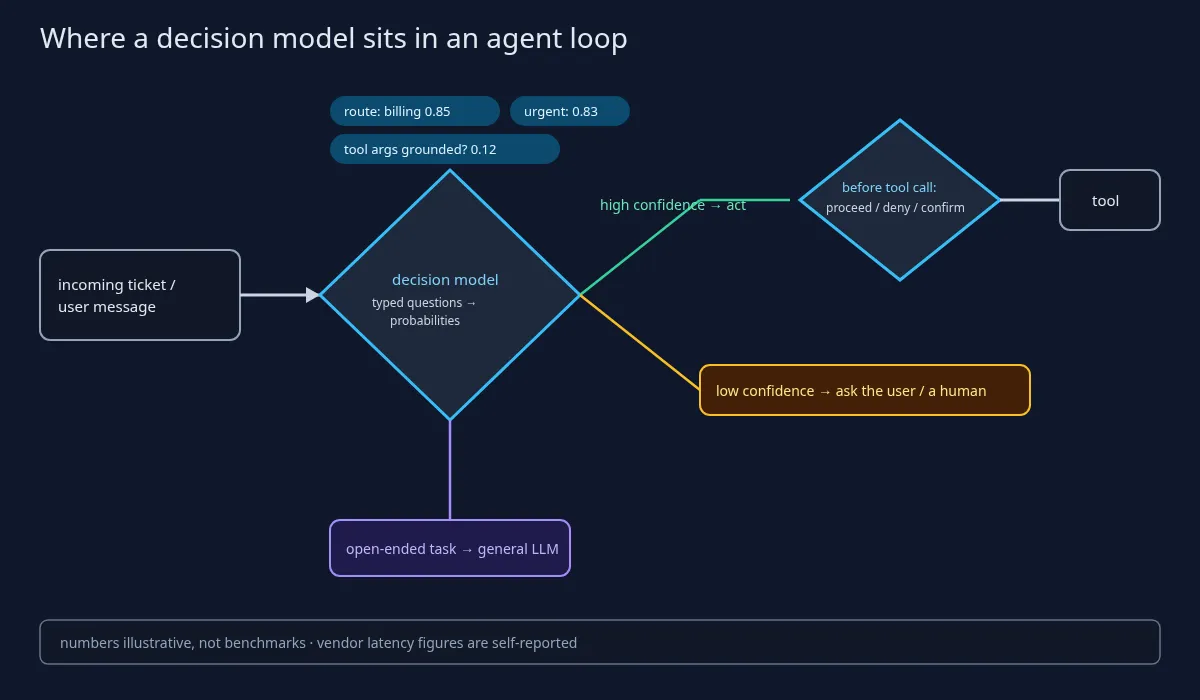
Ambas entradas describen la misma interfaz. Se pasa un estado, que puede ser texto o JSON y, en el caso de Clef, imágenes, junto con preguntas tipadas. Una pregunta de sí o no se llama noul en ambas API, una pregunta de elección única es un choice y una escala ordenada es un score. El modelo devuelve una probabilidad para cada opción permitida y siempre responde a partir de las opciones que le diste.
Esto es útil por dos razones. Una respuesta de un conjunto cerrado no necesita análisis de la salida y no puede inventar una categoría nueva. Y una probabilidad permite al código fijar un umbral: actuar por encima y preguntar a una persona por debajo. Strands subraya que varias preguntas sobre la misma entrada cuestan poco si se hacen juntas, de modo que una sola pasada puede devolver un equipo de destino, un indicador de urgencia y una comprobación de fundamento.
Los proveedores plantean la diferencia con un modelo de lenguaje en función de cómo se produce la respuesta. La decisión se toma en una sola pasada paralela sobre la entrada y no token a token, y de ahí salen las promesas de velocidad.
Lo que un modelo de decisión no es importa igual. Según la propia Strands, su modelo es mucho más débil que los modelos de razonamiento en problemas complejos, e inútil para programar, conversar o resumir, porque no puede generar texto. Su fuerte son las elecciones pequeñas y repetidas, no las difíciles.
Los clasificadores existen desde hace años, y un lector escéptico lo dirá. La propuesta, tal como la plantea la entrada de Cloudflare, es un único modelo que acepta categorías nuevas en el momento de la solicitud sin reentrenamiento: cambias la pregunta, no el modelo.
Según la entrada de Cloudflare del 1 de octubre y su ficha en Hugging Face, se lanzaron dos modelos: Clef y Clef-flash, alojados en Workers AI y descargables bajo Apache 2.0. La ficha describe Clef como un modelo multimodal de 27B posentrenado a partir de Qwen3.8-27B, que lee texto, JSON, imágenes o vídeo y responde en una sola pasada hacia delante, sin generación libre. Según la entrada, Clef-flash congela una base Qwen3.5-9B. Ambos añaden una pequeña cabeza de enrutamiento y adaptadores de bajo rango de rango 256, entrenados con pérdidas de calibración.
Cloudflare menciona dos cosas que, según dice, distinguen a Clef: un codificador de visión, para que las imágenes puedan formar parte del estado, y una ventana de contexto de 64k tokens, que contrapone a los 32k de Jev.
Las cifras proceden de una ejecución interna de Cloudflare de la suite Decision Index, y todas las declara el proveedor. Cloudflare declara una precisión BFCL case-exact de 98,47 para Clef y de 98,76 para Clef-flash. Declara una latencia mediana de 209,3 ms para Clef y de 38,8 ms para Clef-flash, con una latencia p95 declarada de 238,6 ms y 122,4 ms respectivamente.
Las mismas tablas muestran también el lado más débil. Las cifras declaradas por la propia Cloudflare sitúan a Clef por detrás de Jev en conjuntos de razonamiento más difíciles como GPQA Diamond, MMLU-Pro y BBH. Encaja con el patrón: los modelos de decisión están hechos para elecciones acotadas, no para el razonamiento difícil.
Dos afirmaciones más del proveedor, señaladas como tales. En una anécdota, Cloudflare cuenta que un flujo de clasificación de dominios tardó 2,2 segundos con Clef frente a 4,7 segundos con gpt-oss-120b. Como compromiso, Cloudflare dice que no lee ni almacena las solicitudes y respuestas ni entrena con ellas, salvo que el cliente se adhiera a su servicio de fine-tuning.
El autoalojamiento es posible, pero no ligero. El ejemplo de referencia de la ficha se probó en una sola H200; Clef es un modelo de 27B, no un modelo para portátil. Clef-flash y el endpoint alojado son las vías más ligeras. Cloudflare anunció también un servicio de fine-tuning por aprendizaje por refuerzo, ofrecido primero a través de sus ingenieros desplegados con los clientes y más adelante en autoservicio; la entrada no publica precios.
Según la entrada de Strands Labs del 1 de octubre y su ficha en Hugging Face, Strands Decider 2B es un modelo de decisión de dos mil millones de parámetros construido sobre Qwen3.5-2B, al que se le ha quitado la cabeza de generación de texto y se ha sustituido por una pequeña cabeza de puntero, de algo más de un millón de parámetros, que puntúa cada opción. El tronco se ajusta con una LoRA de rango 16. El checkpoint publicado es la v19, tras muchas iteraciones cuyo historial está en el repositorio.
La apertura es el titular. El código está en GitHub, los pesos en Hugging Face y, según Strands, también todos los datos de entrenamiento y scripts usados para construir el modelo, bajo Apache 2.0. La ficha dice que reentrenarlo lleva unas 11 horas en una RTX 3090. Para un MSP que quiera adaptar un modelo de decisión a sus propias categorías de tickets, esa reproducibilidad es lo importante.
Las cifras las declara el proveedor. Strands declara una mediana de unos 115 ms para decisiones locales en una RTX 3090, y el pie del gráfico indica que esa medición se hizo con la v18, no con la v19. Declara unos 153 ms para tareas pequeñas en un MacBook M3. La ficha declara 167 de 231 tareas públicas de JevBench correctas y marca ese resultado como «self-reported».
Strands publica sus propios límites, y deben figurar en cualquier nota de adopción. Los documentos largos de varios pasos son el punto débil. Las preguntas se leen con menos atención que los documentos. La calibración se ajustó con tareas cortas de clasificación, así que la ficha aconseja medir los umbrales con tu propio tráfico antes de fiarte de ellos.
Una línea operativa que un MSP no debe pasar por alto: según la ficha, el comando integrado strands-decider serve escucha en 127.0.0.1 y no tiene autenticación, y la ficha lo indica para experimentos locales. No lo expongas tal cual en una red compartida.
El ejemplo desarrollado de la entrada es una comprobación antes de una llamada a una herramienta: ¿los argumentos de la herramienta se basan en lo que el usuario dijo realmente, y es demasiado pronto para actuar? Strands lo llama una ilustración y no una recomendación, y así hay que leerlo.
A continuación, el ejemplo de Strands tomado de su ficha de modelo, ejecutado en una máquina local. La ficha advierte de que un reentrenamiento da cifras algo distintas.
pip install strands-decider

strands-decider ask StrandsAgents/strands-decider-2B-hobson-v19 \
  --state "Help! My payouts have been failing for 3 days! " \
  --choice "Which team should handle this?=billing,sales,retail" \
  --noul "Does this convey urgency?"
Ambos proveedores citan la misma familia de usos, y encajan bien con las operaciones de agentes de un MSP: enrutamiento y urgencia de tickets, enrutamiento de modelos (enviar una solicitud a un modelo barato o a uno caro), selección de herramientas, comprobaciones antes de una llamada a una herramienta, clasificación según políticas y triaje de alertas. Son las decisiones rutinarias en las que un LLM general es lento, caro y más difícil de auditar.
Strands describe claramente la forma híbrida: que el LLM tome las decisiones difíciles y el modelo de decisión las rutinarias. Eso reduce el coste y la latencia solo si lo mides con tu propia carga. Aquí no se ofrece ninguna cifra de ahorro, porque para tu carga no existe hasta que la midas.
Controles de adopción, desde el lado de la defensa, cada uno con su prueba:
Qué no hacer: no dejes que un modelo de decisión sea la única barrera ante una acción irreversible. Combínalo con una política determinista o con una persona, como hace el propio ejemplo de Strands con sus acciones proceed, deny y confirm.
Cuatro cosas que este artículo no es.
No es un análisis de Jev, de Typesafe. Ambos proveedores citan Jev como detonante de sus lanzamientos; este artículo no lo ha probado y no cita ninguna cifra de Jev salvo tal como aparece en las tablas de Cloudflare.
No trata de Laminar flow-1, un modelo pequeño que lee trazas de agentes para encontrar fallos. Esa es otra noticia.
No trata de Reflection Beam, un gran modelo general anunciado cuyos pesos siguen pendientes.
No es un artículo sobre los precios de Workers AI. La entrada de Cloudflare no publica ningún precio para Clef ni para su servicio de fine-tuning, y este artículo no se inventa ninguno.
Los hechos verificados: el 1 de octubre de 2026, Cloudflare lanzó Clef, un modelo de decisión multimodal de 27B posentrenado a partir de Qwen3.8-27B, y Clef-flash, en Workers AI y en Hugging Face bajo Apache 2.0, con un servicio de fine-tuning por aprendizaje por refuerzo por llegar. Ese mismo día, Strands Labs lanzó Strands Decider 2B, construido sobre Qwen3.5-2B con una LoRA y una cabeza de puntero, con pesos, código, datos de entrenamiento y scripts bajo Apache 2.0.
Cada cifra de precisión y latencia de este artículo la declara el proveedor: la puntuación BFCL declarada de 98,47 y la mediana de 209 ms de Clef, la mediana declarada de 38,8 ms de Clef-flash y la cifra de unos 115 ms en una RTX 3090 que Strands declara para el Decider. Las propias tablas de Cloudflare muestran a Clef por detrás en los conjuntos de razonamiento más difíciles.
El patrón es la noticia. Las decisiones acotadas y calibradas dentro de un agente pueden pasar a modelos pequeños de pesos abiertos que puedes ejecutar tú mismo, con una persona o una política determinista detrás de cada paso de baja confianza o irreversible. Mide con tu propio tráfico antes de fiarte de cualquier umbral.