





















01
Necessari Sempre attivo
Indispensabili per il funzionamento del sito (login, preferenze, sicurezza). Sempre attivi.
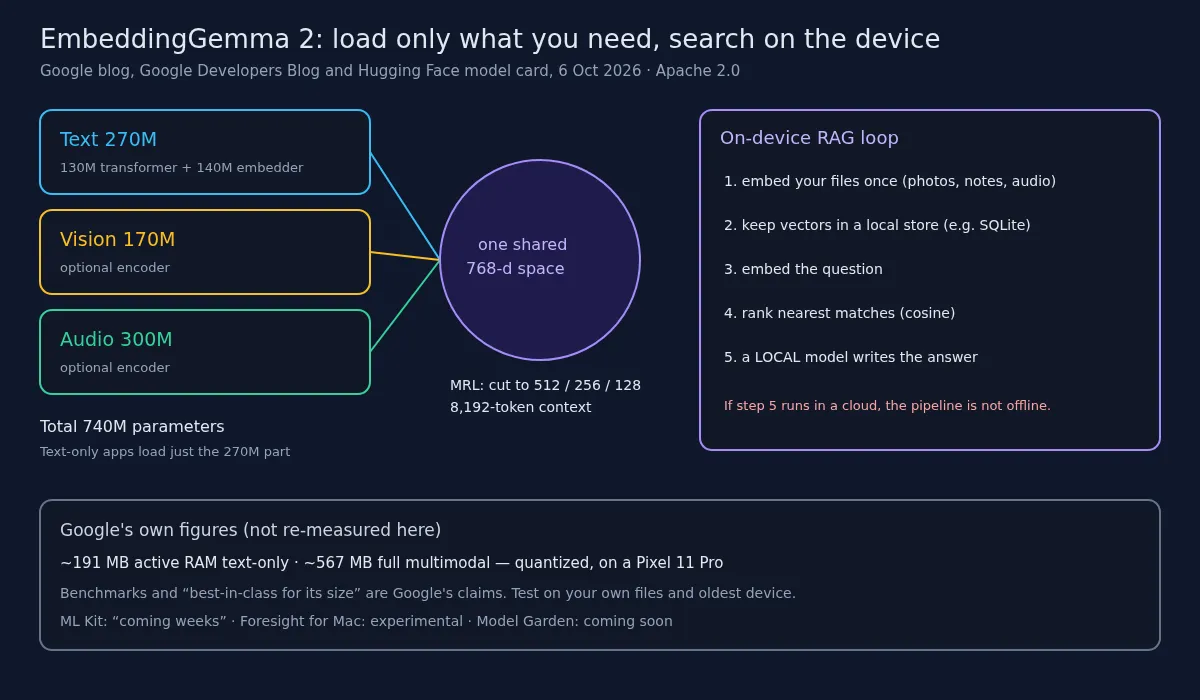
Il 6 ottobre 2026 Google DeepMind ha rilasciato EmbeddingGemma 2 , un modello di embedding aperto con licenza Apache 2.0 che porta testo (codice incluso), immagini, video e audio in un unico spazio a 768 dimensioni . Ha 740 milioni di parametri, divisi tra un modello testuale da 270M e due encoder opzionali, visione.
Il 6 ottobre 2026 Google DeepMind ha rilasciato EmbeddingGemma 2, un modello di embedding aperto con licenza Apache 2.0 che porta testo (codice incluso), immagini, video e audio in un unico spazio a 768 dimensioni. Ha 740 milioni di parametri, divisi tra un modello testuale da 270M e due encoder opzionali, visione da 170M e audio da 300M: un'app solo testo carica soltanto la parte da 270M. Secondo Google, quantizzato su un Pixel 11 Pro richiede circa 191 MB di RAM attiva per i soli pesi testuali e circa 567 MB per il modello multimodale completo. La finestra di contesto è di 8.192 token.
Un modello di embedding è la metà «ricerca» della retrieval-augmented generation. Se capisce note vocali, scansioni e clip video direttamente sul dispositivo, diventa possibile una ricerca privata tra i propri file senza mandarli nel cloud di nessuno. Questa è la storia pratica; quella dei benchmark è di Google, e la trattiamo come tale.
Di seguito: le specifiche verificate, come appare una RAG multimodale sul dispositivo con le app demo di Google, un esempio minimo di codice, le affermazioni di Google messe a confronto con quello che conviene testare, e una checklist per chi gestisce file dei clienti. Abbiamo letto il post sul blog di Google, quello sul Google Developers Blog e la model card su Hugging Face l'8 ottobre 2026.
Licenza e accesso. Apache 2.0, secondo il blog di Google, la model card e il tag di licenza su Hugging Face. Il repository su Hugging Face non richiede approvazione per il download. I pesi sono su Hugging Face e Kaggle; Google dice che la disponibilità nel suo Model Garden è «in arrivo».
Dimensione, modulare. 740M in totale: un modello testuale da 270M (un transformer da 130M più un embedder da 140M, secondo la card), un encoder per la visione da 170M e uno per l'audio da 300M. La card indica le dimensioni effettive disattivando gli encoder: 270M solo testo, 440M testo e immagini, 570M testo e audio.
Uno spazio per tutto. Testo, codice, immagini, video e audio finiscono nello stesso spazio a 768 dimensioni: una domanda a voce può trovare una foto e una domanda scritta può trovare un momento in un video.
Vettori più piccoli su richiesta. La Matryoshka Representation Learning permette di tagliare i vettori a 512, 256 o 128 dimensioni. Il blog di Google e la card parlano di uno spazio di archiviazione fino a 6 volte inferiore; il Developers Blog dice fino a 8 volte per archiviazione e indici. La card aggiunge due regole da tenere: rinormalizzare i vettori dopo il taglio, e non confrontare mai una query con un archivio di dimensione diversa.
Contesto. 8.192 token, che secondo Google bastano per circa 5,5 minuti di audio, 29 immagini o 58 fotogrammi video, anche combinati tra loro.
Memoria, dati di Google. Circa 191 MB di RAM attiva per i soli pesi testuali e circa 567 MB per il modello completo, quantizzato, su un Pixel 11 Pro.
Lingue e parentela. La card indica oltre 100 lingue. Il modello è basato su Gemma 4 e ne condivide il tokenizer testuale e l'encoder audio; secondo Google questo riduce la memoria complessiva quando i due girano nella stessa pipeline.
La RAG in una riga. Si calcolano gli embedding dei file una volta, si calcola quello della domanda, si recuperano i risultati più vicini e li si passa a un modello generativo che scrive la risposta. Con EmbeddingGemma 2 cambia che il passaggio di embedding può coprire note vocali, pagine scansionate, foto e clip video, e può girare sul dispositivo.
Le demo di Google. Sul Developers Blog Google descrive Instant Media Search nell'app Google AI Edge Gallery per Android e iOS: domanda e contenuti vengono trasformati in vettori sul telefono, i vettori dei contenuti stanno in un database SQLite locale, i risultati sono ordinati per similarità del coseno e non serve alcuna connessione internet. Video Moments Finder trova momenti in registrazioni video locali senza trascrivere l'audio né generare didascalie testuali intermedie. Google AI Edge Foresight per Mac, che Google definisce «un'app sperimentale», abbina EmbeddingGemma 2 a Gemma 4 come assistente per le riunioni che cerca in locale tra trascrizioni e file personali.
I mattoni per chi sviluppa. Google dice che MediaPipe Tasks sta aggiungendo il supporto a EmbeddingGemma 2: un task Universal Embedder che gestisce ridimensionamento delle immagini, normalizzazione e tokenizzazione e restituisce vettori a 768 dimensioni o ridotti, e un task Semantic Retriever che indicizza gli embedding sul dispositivo ed esegue una ricerca approssimata dei vicini più prossimi. Sotto c'è LiteRT, per chi vuole un controllo più fine, e secondo Google l'addestramento consapevole della quantizzazione comprime i pesi a INT4 e INT8. Il suo esempio di latenza è un embedding visivo in appena 37,3 ms sulla GPU di un MacBook M5 Pro; è un singolo dispositivo, misurato da Google.
Dove potrebbe servire. Sono possibilità, non risultati testati: un tecnico che cerca tra le foto di cantiere descrivendo il guasto; un consulente che ritrova il momento di una call registrata in cui il cliente ha accettato una scadenza; un piccolo ufficio che cerca tra contratti scansionati senza caricarli da nessuna parte.
Il limite onesto. «Offline» significa che embedding e ricerca girano in locale. Anche il modello generativo che scrive la risposta deve girare in locale perché l'intera pipeline resti sul dispositivo. L'esempio che segue è solo testo e usa l'ID del modello, i nomi dei prompt e le opzioni documentati nella card di Hugging Face; per immagini, audio e video conviene copiare il formato degli input dalla card invece di indovinarlo.
# pip install -U sentence-transformers transformers
from sentence_transformers import SentenceTransformer

# Text-only: skip the vision and audio encoders ("Selective Encoder Loading" on the model card)
model = SentenceTransformer(
    "google/embeddinggemma-2",
    config_kwargs={"vision_config": None, "audio_config": None},
)

docs = [
    "Invoice 2026-114: boiler service, paid 3 October",
    "Site visit notes: pressure valve replaced on floor 2",
]
query = "when was the pressure valve replaced?"

# Prompt names, truncate_dim and normalize_embeddings as documented on the model card
doc_vecs = model.encode(docs, prompt_name="Document", truncate_dim=256, normalize_embeddings=True)
query_vec = model.encode(query, prompt_name="SearchQuery", truncate_dim=256, normalize_embeddings=True)
print(model.similarity(query_vec, doc_vecs))  # higher = closer match
Le affermazioni di Google, attribuite. Google definisce EmbeddingGemma 2 «il migliore della sua categoria per dimensione», con «punteggi al vertice tra gli embedder multimodali sotto il miliardo di parametri» su MTEB Code e MAEB, «pari o superiore a molti modelli più grandi». Riporta un MTEB Code salito da 68,76 a 78,68 rispetto al primo EmbeddingGemma, e la model card parla di un miglioramento di circa il 14% sui compiti di codice. La card dice anche che la qualità resta quasi invariata fino a 256 dimensioni, mentre a 128 la qualità multimodale peggiora in modo sostanziale e va verificata sul proprio carico di lavoro. Non abbiamo rieseguito alcun benchmark, e le classifiche pubbliche misurano dataset pubblici, non le tue scansioni e registrazioni.
Un piano di test da fare in casa.
Una checklist per MSP e team che gestiscono file dei clienti.
A che punto siamo all'8 ottobre 2026. Google DeepMind ha rilasciato EmbeddingGemma 2 il 6 ottobre con licenza Apache 2.0: 740M parametri divisi tra testo da 270M, visione da 170M e audio da 300M; un unico spazio a 768 dimensioni per testo, codice, immagini, video e audio; riduzione Matryoshka a 512, 256 o 128; contesto da 8.192 token; e, secondo i dati di Google, circa 191 MB solo testo o 567 MB per il modello completo, quantizzato, su un Pixel 11 Pro. Le app demo sono in Google AI Edge Gallery e nella versione sperimentale di Foresight per Mac, mentre il supporto ML Kit è atteso nelle prossime settimane. Ogni benchmark e confronto citato qui è un'affermazione di Google. La RAG multimodale sul dispositivo sui propri file è il vantaggio pratico, a patto che anche il modello che risponde sia locale.