





















01
Nécessaires Toujours actif
Indispensables au fonctionnement du site (session, préférences, sécurité). Toujours actifs.
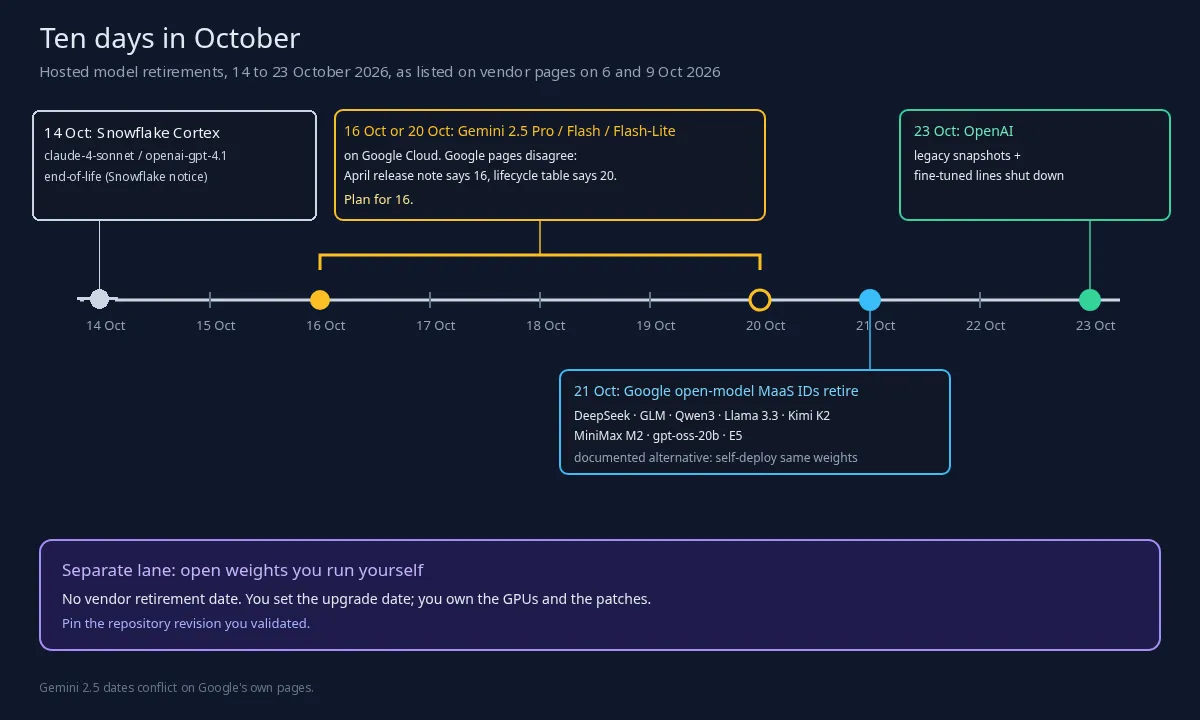
En dix jours d'octobre 2026, plusieurs identifiants de modèles hébergés atteignent leur date de retrait : les anciens snapshots d'OpenAI le 23 octobre, les identifiants MaaS des modèles ouverts de Google le 21 octobre, Gemini 2.5 sur Google Cloud le 16 ou le 20 octobre et deux modèles Snowflake Cortex le 14 octobre. Épinglez les identifiants, donnez un responsable à chacun et sachez quels poids ouverts vous pourriez exécuter vous-même.
Commencez par le calendrier. En l'espace de dix jours en octobre 2026, plusieurs identifiants de modèles hébergés atteignent leur date de retrait. La page des dépréciations d'OpenAI recense un ensemble d'anciens snapshots et de gammes de modèles affinés dont la date d'arrêt est fixée au 23 octobre 2026. Le tableau Model-as-a-Service des modèles ouverts de Google fixe au 21 octobre la date de retrait des identifiants DeepSeek, GLM, Qwen3, Llama 3.3, Kimi K2, MiniMax M2, gpt-oss-20b et des embeddings E5, et indique comme alternative le déploiement autonome des mêmes poids. Les propres pages de Google se contredisent sur Gemini 2.5 Pro, Flash et Flash-Lite : une note de version d'avril indique le 16 octobre, tandis que le tableau du cycle de vie consulté le 6 octobre indique le 20 octobre. L'avis de dépréciation de Snowflake fixe au 14 octobre 2026 la fin de vie de deux modèles Cortex, claude-4-sonnet et openai-gpt-4.1.
La thèse tient en deux phrases. Un identifiant de modèle hébergé est une dépendance avec une date d'expiration : il a sa place dans un inventaire, avec un responsable nommément désigné. Les poids ouverts que vous exécutez vous-même n'ont pas de date de retrait imposée par un fournisseur, mais ils vous transfèrent le rythme des mises à niveau, le matériel et les correctifs.
Au programme : le calendrier fournisseur par fournisseur, ce que « retiré » signifie en pratique, six habitudes pour épingler les identifiants de modèles, les compromis honnêtes de l'auto-hébergement et un encadré sur Kolibri d'Aleph Alpha, publié le 3 octobre avec des poids ouverts sous Apache 2.0. Chaque date ci-dessous provient d'une page fournisseur ; ces pages ont été relues le 6 octobre 2026, celle de Snowflake le 9 octobre 2026.
OpenAI, 23 octobre. La section de la page des dépréciations d'OpenAI datée du 22 avril 2026 annonce l'arrêt de ces snapshots le 23 octobre : gpt-3.5-turbo-0125, gpt-4-0613, gpt-4-turbo, gpt-4.1-nano, gpt-4o-2024-05-13, gpt-image-1, o1-2024-12-17, o1-pro-2025-03-19, o3-mini-2025-01-31, o4-mini-2025-04-16 et ft-o4-mini-2025-04-16, ainsi que des gammes affinées sur gpt-3.5-turbo, gpt-4, gpt-4.1-nano, babbage-002 et davinci-002. Les remplaçants désignés par OpenAI sont la famille gpt-5.6-sol, gpt-5.6-terra et gpt-5.6-luna, avec gpt-image-2.5-sunburst ou gpt-image-2.5-flare pour gpt-image-1. Plusieurs lignes mentionnent aussi des noms apparentés dans une colonne distincte, et le tableau ne dit pas clairement si ces noms s'arrêtent également. Lorsqu'une ligne mentionne des noms apparentés, vérifiez sur la page chaque nom appelé par votre code.
Modèles ouverts de Google, 21 octobre. Le tableau des dépréciations MaaS des modèles ouverts de Google recense DeepSeek (OCR, R1-0528, V3.1 et V3.2), GLM (5 et 4.7), gpt-oss-20b, Kimi K2 Thinking, Llama 3.3 70B Instruct, MiniMax M2, deux modèles d'embedding E5 multilingues et quatre variantes de Qwen3 : 16 identifiants de modèles au total, dont la date de retrait est le 21 octobre. Tous ont été dépréciés le 21 juillet, et chaque ligne indique comme alternative le déploiement autonome du modèle sur Model Garden.
Gemini 2.5 sur Google Cloud, 16 ou 20 octobre. Une note de version d'avril fixait le 16 octobre ; le tableau du cycle de vie de Google consulté le 6 octobre indique le 20 octobre. Prévoyez la date la plus proche et vérifiez la page du cycle de vie pour votre projet. En détail : une note de version de Vertex AI datée d'environ le 2 avril 2026 indique que les dates de retrait de Gemini 2.5 Pro, Flash-Lite et Flash « ont été mises à jour au 16 octobre 2026 » (notre traduction). Le tableau des versions et du cycle de vie des modèles actuellement en ligne indique le 20 octobre pour les trois, avec des remplaçants tels que gemini-3.8-flash, gemini-3.5-flash, gemini-3.5-flash-lite et gemini-3.1-flash-lite. Nous n'avons trouvé aucune note ultérieure expliquant cet écart. La page des dépréciations de l'API Gemini de Google n'annonce aucune date d'arrêt pour ces trois modèles : l'échéance dépend donc de la surface Google qu'appelle une charge de travail.
Snowflake Cortex, 14 octobre. L'avis de Snowflake sur les dépréciations de modèles Cortex indique le 14 octobre 2026 comme date de fin de vie de claude-4-sonnet et openai-gpt-4.1, passés au statut legacy le 12 août 2026. Après la fin de vie, les requêtes et appels d'API qui désignent l'un de ces deux modèles échouent.
ChatGPT et Codex, 14 octobre. Le journal des modifications officiel de ChatGPT et Codex d'OpenAI, dans une entrée datée du 14 septembre 2026, fixe au 14 octobre 2026 la date à laquelle GPT-5.5 est retiré de ChatGPT, ChatGPT Work et Codex pour toutes les offres, y compris Business, Enterprise et Edu. La même entrée précise que ce retrait ne s'applique pas à l'API d'OpenAI : les appels API à gpt-5.5 n'en sont donc pas affectés. Dans Codex, les paramètres par défaut des espaces de travail, les réglages de modèle enregistrés, les agents personnalisés, les tâches planifiées et les scripts qui sélectionnent encore gpt-5.5 doivent passer à un modèle de remplacement.
Le calendrier ne s'arrête pas après octobre. Les prochaines dates d'OpenAI déjà inscrites sur la page sont le 1er décembre pour les modèles GPT Image et le 11 décembre pour les snapshots datés de GPT-5 et o3.
« Retiré » sonne comme une formalité administrative. En production, cela signifie des erreurs. La page de Google sur les modèles ouverts définit deux étapes. Pendant la période de dépréciation, le point de terminaison continue de fonctionner pour les charges existantes afin de permettre la migration, mais toute nouvelle utilisation peut être restreinte. À la date de retrait, le point de terminaison est désactivé et les requêtes API qui appellent un identifiant retiré échouent.
La formulation d'OpenAI est plus brève : à l'arrêt, un modèle ou un point de terminaison n'est plus accessible. Une règle de la même page prend souvent les équipes au dépourvu. L'inférence sur un modèle affiné s'arrête lorsque son modèle de base est déprécié : un modèle affiné ne dure donc pas plus longtemps que la base sur laquelle il a été entraîné. Le client qui a payé un affinage l'an dernier a acheté quelque chose qui porte la date d'expiration du modèle de base.
Les préavis varient selon l'étape. La page d'OpenAI s'engage sur au moins six mois pour les modèles en disponibilité générale, au moins trois mois pour les variantes spécialisées, et parfois seulement deux semaines environ pour les modèles dont le nom contient preview. Google maintient les modèles ouverts en préversion disponibles pendant au moins 45 jours après leur sortie. La règle pratique : les identifiants preview n'ont pas leur place sur un chemin critique exposé au client, sauf si le contrat permet une migration rapide.
Il existe une porte de sortie, et elle est commerciale. OpenAI indique que certains développeurs peuvent, via son équipe commerciale, obtenir une capacité dédiée pour continuer à accéder à un modèle après sa date d'arrêt. C'est une négociation, pas un comportement par défaut, et cela ne doit pas être le plan.
Ce qui casse dans un parc MSP, c'est rarement l'application phare. C'est le résumeur oublié dans une intégration de ticketing, la tâche d'embedding derrière un index de recherche, ou l'affinage qu'un client a payé l'an dernier. Les retraits de modèles d'embedding comptent double : un nouveau modèle d'embedding implique généralement de réindexer le corpus, pas seulement de changer un nom dans un fichier de configuration.
Une ligne d'inventaire doit comporter un identifiant épinglé, la date, un remplaçant en test et un responsable nommé. Le YAML illustratif ci-dessous en montre la forme ; tous les noms qu'il contient sont fictifs.
# model-inventory.yaml: one row per call site, reviewed monthly
- call_site: ticket-summarizer
  provider: openai
  model_id: o4-mini-2025-04-16        # listed for shutdown 2026-10-23
  replacement_under_test: gpt-5.6-terra
  owner: platform-team
  eval_set: summaries-golden-v3
  cutover_ticket: CHG-0000
- call_site: kb-search-embeddings
  provider: google-maas
  model_id: multilingual-e5-large-instruct-maas   # retires 2026-10-21
  plan: self-deploy same weights OR switch model + re-index
  owner: search-team
Épingler n'est pas un produit. Ce sont six habitudes, chacune assortie de ce qui compte comme preuve.
1. En production, appelez des snapshots datés, pas des noms flottants. Un nom flottant peut basculer vers un nouveau modèle à votre insu. Un identifiant daté ne change que lorsque vous le changez. Preuve : la configuration déployée affiche l'identifiant daté. Pas une preuve : « nous utilisons la dernière version ».
2. Tenez une ligne d'inventaire par point d'appel, avec le fournisseur, l'identifiant exact, le responsable, la date de retrait et le remplaçant en test. Cherchez dans le code, la configuration d'infrastructure et les automatisations low-code, pas seulement dans l'application principale. Les points d'appel qui font mal sont généralement ceux construits hors du dépôt principal.
3. Abonnez-vous à la source qui fait foi. C'est-à-dire les pages de dépréciation des fournisseurs et les e-mails de compte qu'ils envoient. Une newsletter de synthèse est une piste, pas une source. Cet article le démontre : une page Google contredit une autre page Google sur Gemini 2.5.
4. Testez le remplaçant sur votre propre trafic avec un petit jeu de référence avant la bascule : format de sortie, refus, latence et coût par tâche. Ne supposez jamais qu'un « remplaçant recommandé » se comporte comme le modèle qu'il remplace.
5. Basculez avant la date, avec une fenêtre de retour arrière qui se termine avant la date. Revenir à un identifiant retiré n'est pas un retour arrière. Si la date plausible la plus proche est le 16 octobre, la fenêtre de retour arrière se ferme avant le 16 octobre.
6. Traitez les changements de valeur par défaut comme des mises en production. Lorsqu'un fournisseur change le modèle vers lequel pointe un nom par défaut, la facture et le comportement peuvent évoluer sans le moindre changement de prix. C'est l'épinglage qui en fait un changement planifié, avec un ticket, un test et un responsable.
La preuve la plus nette que l'accès hébergé et le modèle lui-même sont deux choses différentes vient de Google. Pour chaque modèle ouvert dont la date de retrait est le 21 octobre, le tableau de Google documente lui-même l'alternative : déployer soi-même les mêmes poids sur Model Garden. Le point de terminaison disparaît, les poids restent.
Ce que vous y gagnez est précis. Les poids que vous téléchargez et servez ne disparaissent pas parce qu'un fournisseur retire un point de terminaison. Vous choisissez quand mettre à niveau et pouvez conserver la révision exacte que vous avez validée. Épinglez la révision du dépôt que vous avez testée, pas seulement le nom du modèle, car un dépôt de modèles peut changer après votre premier téléchargement.
Ce que vous prenez en charge est tout aussi précis : des GPU ou de la capacité réservée, une pile de service et ses mises à jour, la supervision, votre propre évaluation avant chaque mise à niveau et les correctifs de sécurité de tout ce qui entoure le modèle. C'est un coût d'exploitation réel. Son montant dépend de votre charge de travail et de vos contrats ; cet article n'avance donc aucun chiffre.
Les licences diffèrent. Certains modèles ouverts sont publiés sous Apache 2.0 ; d'autres utilisent des licences spécifiques, avec leurs propres conditions d'utilisation, d'attribution ou d'échelle. Lisez la licence du dépôt exact avant qu'un client n'en dépende, et conservez-en une copie à côté de la ligne d'inventaire.
Où cela a-t-il sa place pour un MSP ? Les charges stables et bien définies, comme la classification, l'extraction et la recherche dans les documents propres d'un client, sont de bonnes candidates. Le raisonnement de pointe sur une demande en dents de scie l'est souvent moins. L'hybride est normal : des modèles hébergés pour les cas difficiles, des poids auto-hébergés épinglés pour le cœur prévisible. Il s'agit d'un schéma général, pas d'une recommandation pour un produit d'hébergement particulier.
Encadré : Kolibri, poids ouverts publiés le 3 octobre. Aleph Alpha a annoncé Kolibri depuis Heidelberg le 5 octobre 2026 dans un communiqué de presse. Le modèle est disponible depuis le 3 octobre et prend en charge l'allemand et l'anglais. L'entreprise indique qu'il est conçu pour être déployé sur une infrastructure contrôlée par le client, avec une provenance des données et des choix de conception documentés. Il prend en charge les workflows agentiques, la génération augmentée par récupération (RAG) et l'appel d'outils natif, et selon Aleph Alpha, il a été entraîné à s'abstenir lorsque les documents fournis ne contiennent pas d'éléments probants.
Ses caractéristiques, d'après la fiche du modèle sur Hugging Face : un modèle mixture-of-experts de 78 milliards de paramètres au total, dont environ 3,46 milliards actifs par token (le communiqué arrondit à environ 3 milliards). Le contexte natif est de 262 144 tokens ; la fiche indique que la qualité a été validée jusqu'à environ un million de tokens, mais recommande de rester à 262 144 ou moins pour l'efficacité du service.
La licence, vérifiée sur la fiche le 6 octobre, est Apache 2.0 pour les poids et les fichiers de configuration publiés dans ce dépôt. La fiche précise aussi ce que cette licence ne couvre pas : le code sous-jacent, l'architecture du modèle, les réglages des paramètres ni aucune méthode d'entraînement. « Poids ouverts sous Apache 2.0 » est la description exacte. Qualifier toute la pile d'open source va au-delà de ce qu'affirme la fiche.
Côté matériel, toujours d'après la fiche : des poids FP8 occupant environ 78 Go de mémoire, et un minimum indiqué de deux A100 80 Go, deux H100 SXM5, ou une H200, B200 ou B300. Le service s'appuie sur le paquet aleph-alpha-inference d'Aleph Alpha, un plugin vLLM, ou son image de conteneur, et la fiche montre une API compatible OpenAI une fois le modèle servi de cette façon. Peu de paramètres actifs réduisent le calcul par token. Ils ne réduisent pas la mémoire : le modèle entier doit toujours tenir.
Pourquoi il a sa place ici : aucune date de retrait de fournisseur ne s'applique aux poids que vous hébergez vous-même, et Kolibri est un exemple actuel et daté de cette option pour le travail en allemand et en anglais. Trois éléments de contexte comptent. La fiche indique que le modèle est destiné à des workflows où une personne relit la sortie avant qu'on y donne suite. L'accord entre Aleph Alpha et Cohere reste soumis à l'approbation des autorités, et l'entreprise continue d'opérer de manière indépendante jusqu'à la finalisation. Enfin, « souverain », dans le communiqué d'Aleph Alpha, est le mot de l'entreprise pour désigner le contrôle par le client et la liberté de choix. Ce n'est pas une certification, et cet article n'en revendique aucune.
Le calendrier vérifié, en un paragraphe : la date d'arrêt des anciens snapshots et des gammes affinées d'OpenAI est le 23 octobre. La date de retrait des identifiants MaaS des modèles ouverts de Google est le 21 octobre, avec le déploiement autonome des mêmes poids comme alternative documentée par Google lui-même. Pour Gemini 2.5 Pro, Flash et Flash-Lite sur Google Cloud, la date de retrait est le 16 ou le 20 octobre selon la page Google consultée ; prévoyez donc le 16. Chez Snowflake Cortex, la date de fin de vie de claude-4-sonnet et openai-gpt-4.1 est le 14 octobre.
La règle d'exploitation ne change pas avec le fournisseur. Un identifiant de modèle hébergé est une dépendance avec une date d'expiration : épinglez-le, inventoriez-le, attribuez-lui un responsable et testez le remplaçant sur votre propre trafic avant la date. Les poids ouverts que vous exécutez n'ont pas de date de retrait imposée par un fournisseur, mais le rythme des mises à niveau, le matériel et les correctifs deviennent les vôtres. Kolibri est un exemple daté de poids ouverts sous Apache 2.0, avec une licence que sa fiche limite aux poids et aux fichiers de configuration du dépôt.
Toutes les pages de fournisseurs citées ici ont été relues le 6 octobre 2026, et l'avis de Snowflake le 9 octobre 2026. Si un fournisseur déplace une date, cet article sera corrigé.