





















01
Nécessaires Toujours actif
Indispensables au fonctionnement du site (session, préférences, sécurité). Toujours actifs.
Le 1er octobre 2026, Cloudflare a publié les modèles de décision Clef et Clef-flash et Strands Labs a publié Strands Decider 2B, tous à poids ouverts sous Apache 2.0. Voici où de petits modèles de décision calibrés trouvent leur place dans les agents d’un MSP, et où ils s’arrêtent.
Le 1er octobre 2026, deux entreprises ont publié la même idée le même jour. Cloudflare a sorti deux modèles de décision, Clef et Clef-flash, hébergés sur Workers AI et publiés sur Hugging Face sous licence Apache 2.0. Le même jour, Strands Labs a publié Strands Decider 2B, un modèle de décision de deux milliards de paramètres dont les poids, les données d’entraînement et les scripts sont ouverts sous Apache 2.0.
Un modèle de décision n’écrit pas de texte. Il lit une situation, l’« état », et une série de questions typées, puis renvoie une probabilité pour chaque réponse autorisée, afin que votre code puisse router un ticket, autoriser ou suspendre un appel d’outil, ou passer la main à un humain. Les deux fournisseurs présentent leur sortie comme une réponse à l’attention suscitée par Jev, le modèle de décision de Typesafe AI, et tous deux affirment que leurs modèles sont compatibles avec son API.
Un cadre s’applique à tout ce qui suit : chaque chiffre de précision et de latence de cet article est déclaré par le fournisseur. Cela inclut la médiane de 209 ms annoncée par Cloudflare pour Clef et de 39 ms pour Clef-flash, ainsi que les quelque 115 ms que Strands annonce sur une RTX 3090 locale.
Pour un MSP, l’intérêt n’est pas de savoir qui mène un classement. C’est que les petites décisions structurées et répétitives à l’intérieur d’un agent peuvent passer d’un grand modèle généraliste à quelque chose de peu coûteux, calibré et exécutable sur votre propre matériel. Cet article explique ce qu’est un modèle de décision, ce que chaque fournisseur a publié, où le schéma s’applique et où il s’arrête.
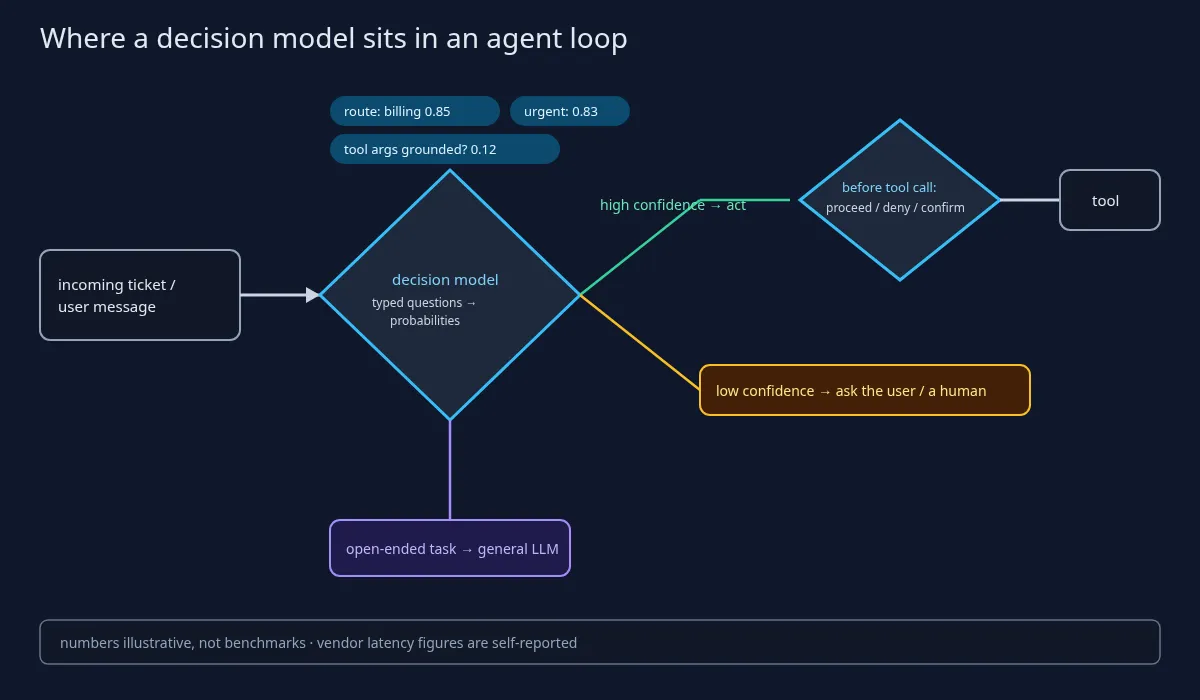
Les deux billets décrivent la même interface. On transmet un état, qui peut être du texte ou du JSON et, pour Clef, des images, ainsi que des questions typées. Une question oui/non s’appelle noul dans les deux API, une question à choix unique est un choice et une échelle ordonnée un score. Le modèle renvoie une probabilité pour chaque option autorisée et répond toujours à partir des options fournies.
C’est utile pour deux raisons. Une réponse issue d’un ensemble fermé ne demande aucune analyse de sortie et ne peut pas inventer de nouvelle catégorie. Et une probabilité permet au code de fixer un seuil : agir au-dessus, demander à un humain en dessous. Strands souligne que plusieurs questions sur la même entrée coûtent peu à poser ensemble, si bien qu’un seul passage peut renvoyer une équipe de destination, un indicateur d’urgence et une vérification de fondement.
Les fournisseurs présentent la différence avec un modèle de langage sous l’angle de la production de la réponse. La décision est prise en un seul passage parallèle sur l’entrée plutôt que jeton par jeton, et c’est de là que viennent les promesses de vitesse.
Ce qu’un modèle de décision n’est pas compte tout autant. De l’aveu même de Strands, son modèle est bien plus faible que les modèles de raisonnement sur des problèmes complexes, et inutile pour coder, discuter ou résumer, car il ne peut pas générer de texte. Sa force, ce sont les petits choix répétés, pas les choix difficiles.
Les classificateurs existent depuis des années, et un lecteur sceptique le fera remarquer. La promesse, telle que la présente le billet de Cloudflare, est un modèle unique qui accepte de nouvelles catégories au moment de la requête sans réentraînement : on change la question, pas le modèle.
Selon le billet de Cloudflare du 1er octobre et sa fiche Hugging Face, deux modèles sont sortis : Clef et Clef-flash, hébergés sur Workers AI et téléchargeables sous Apache 2.0. La fiche décrit Clef comme un modèle multimodal de 27B, post-entraîné à partir de Qwen3.8-27B, qui lit du texte, du JSON, des images ou de la vidéo et répond en une seule passe avant, sans génération libre. Selon le billet, Clef-flash gèle une base Qwen3.5-9B. Les deux ajoutent une petite tête de routage et des adaptateurs de rang faible de rang 256, entraînés avec des pertes de calibration.
Cloudflare cite deux éléments qui, selon lui, distinguent Clef : un encodeur visuel, pour que les images puissent faire partie de l’état, et une fenêtre de contexte de 64k jetons, qu’il oppose aux 32k de Jev.
Les chiffres proviennent d’une exécution interne, par Cloudflare, de la suite Decision Index, et tous sont déclarés par le fournisseur. Cloudflare annonce une précision BFCL case-exact de 98,47 pour Clef et de 98,76 pour Clef-flash. Il annonce une latence médiane de 209,3 ms pour Clef et de 38,8 ms pour Clef-flash, avec une latence p95 annoncée de 238,6 ms et 122,4 ms respectivement.
Les mêmes tableaux montrent aussi le côté le plus faible. Les chiffres annoncés par Cloudflare lui-même placent Clef derrière Jev sur des jeux de raisonnement plus difficiles comme GPQA Diamond, MMLU-Pro et BBH. C’est cohérent avec le schéma : les modèles de décision sont conçus pour des choix bornés, pas pour le raisonnement difficile.
Deux autres déclarations du fournisseur, signalées comme telles. Dans une anecdote, Cloudflare indique qu’un flux de classification de domaines a pris 2,2 secondes avec Clef contre 4,7 secondes avec gpt-oss-120b. À titre d’engagement, Cloudflare affirme ne pas lire ni stocker les requêtes et les réponses, ni s’en servir pour l’entraînement, sauf si le client adhère à son service de fine-tuning.
L’auto-hébergement est possible mais pas léger. L’exemple de référence de la fiche a été testé sur une seule H200 ; Clef est un modèle de 27B, pas un modèle pour ordinateur portable. Clef-flash et le point de terminaison hébergé sont les options plus légères. Cloudflare a aussi annoncé un service de fine-tuning par apprentissage par renforcement, proposé d’abord via ses ingénieurs déployés chez les clients, puis en libre-service ; le billet ne publie aucun tarif.
Selon le billet de Strands Labs du 1er octobre et sa fiche Hugging Face, Strands Decider 2B est un modèle de décision de deux milliards de paramètres construit sur Qwen3.5-2B, dont la tête de génération de texte a été retirée et remplacée par une petite tête de pointage, d’un peu plus d’un million de paramètres, qui note chaque option. Le tronc est affiné avec une LoRA de rang 16. Le point de contrôle publié est la v19, après de nombreuses itérations dont l’historique figure dans le dépôt.
L’ouverture est le titre. Le code est sur GitHub, les poids sont sur Hugging Face et, selon Strands, toutes les données d’entraînement et tous les scripts utilisés pour construire le modèle aussi, sous Apache 2.0. La fiche indique qu’un réentraînement prend environ 11 heures sur une RTX 3090. Pour un MSP qui veut adapter un modèle de décision à ses propres catégories de tickets, c’est cette reproductibilité qui compte.
Les chiffres sont déclarés par le fournisseur. Strands annonce une médiane d’environ 115 ms pour des décisions locales sur une RTX 3090, et la légende du graphique précise que cette mesure a été faite sur la v18, pas sur la v19. Il annonce environ 153 ms pour de petites tâches sur un MacBook M3. La fiche fait état de 167 tâches JevBench publiques réussies sur 231 et marque ce résultat comme « self-reported ».
Strands publie ses propres limites, et elles ont leur place dans toute note d’adoption. Les longs documents en plusieurs étapes sont le point faible. Les questions sont lues moins attentivement que les documents. La calibration a été ajustée sur de courtes tâches de classification ; la fiche conseille donc de mesurer les seuils sur votre propre trafic avant de leur faire confiance.
Une ligne opérationnelle qu’un MSP ne doit pas manquer : selon la fiche, la commande intégrée strands-decider serve écoute sur 127.0.0.1 et n’a aucune authentification, et la fiche la réserve aux expériences locales. Ne l’exposez pas telle quelle sur un réseau partagé.
L’exemple détaillé du billet est une vérification avant un appel d’outil : les arguments de l’outil reposent-ils sur ce que l’utilisateur a réellement dit, et est-il trop tôt pour agir ? Strands parle d’une illustration et non d’une recommandation, et c’est ainsi qu’il faut le lire.
Ci-dessous, l’exemple de Strands tiré de sa fiche de modèle, exécuté sur une machine locale. La fiche note qu’un réentraînement donne des chiffres un peu différents.
pip install strands-decider

strands-decider ask StrandsAgents/strands-decider-2B-hobson-v19 \
  --state "Help! My payouts have been failing for 3 days! " \
  --choice "Which team should handle this?=billing,sales,retail" \
  --noul "Does this convey urgency?"
Les deux fournisseurs citent la même famille d’usages, et elle correspond bien aux opérations d’agents d’un MSP : routage et urgence des tickets, routage de modèles (envoyer une requête vers un modèle bon marché ou coûteux), choix d’outil, vérifications avant un appel d’outil, classification selon une politique et tri des alertes. Ce sont les décisions routinières pour lesquelles un LLM généraliste est lent, coûteux et plus difficile à auditer.
Strands décrit clairement la forme hybride : laisser au LLM les décisions difficiles et au modèle de décision les décisions courantes. Cela réduit le coût et la latence seulement si vous le mesurez sur votre propre charge. Aucun chiffre d’économies n’est avancé ici, car il n’en existe pas pour votre charge tant que vous ne l’avez pas mesuré.
Contrôles d’adoption, côté défense, chacun avec sa preuve :
Ce qu’il ne faut pas faire : ne laissez pas un modèle de décision être le seul verrou avant une action irréversible. Associez-le à une politique déterministe ou à une personne, comme le fait l’exemple de Strands lui-même avec ses actions proceed, deny et confirm.
Quatre choses que cet article n’est pas.
Ce n’est pas une critique de Jev, de Typesafe. Les deux fournisseurs citent Jev comme déclencheur de leurs sorties ; cet article ne l’a pas testé et ne cite aucun chiffre de Jev, sauf tel qu’il apparaît dans les tableaux de Cloudflare.
Il ne traite pas de Laminar flow-1, un petit modèle qui lit les traces d’agents pour repérer les défaillances. C’est un autre sujet.
Il ne traite pas de Reflection Beam, un grand modèle généraliste annoncé dont les poids sont toujours attendus.
Ce n’est pas un article sur les tarifs de Workers AI. Le billet de Cloudflare ne publie aucun prix pour Clef ni pour son service de fine-tuning, et cet article n’en invente aucun.
Les faits vérifiés : le 1er octobre 2026, Cloudflare a publié Clef, un modèle de décision multimodal de 27B post-entraîné à partir de Qwen3.8-27B, et Clef-flash, sur Workers AI et sur Hugging Face sous Apache 2.0, avec un service de fine-tuning par apprentissage par renforcement à venir. Le même jour, Strands Labs a publié Strands Decider 2B, construit sur Qwen3.5-2B avec une LoRA et une tête de pointage, avec poids, code, données d’entraînement et scripts sous Apache 2.0.
Chaque chiffre de précision et de latence de cet article est déclaré par le fournisseur : le score BFCL annoncé de 98,47 et la médiane de 209 ms pour Clef, la médiane annoncée de 38,8 ms pour Clef-flash, et le chiffre d’environ 115 ms sur une RTX 3090 que Strands annonce pour le Decider. Les propres tableaux de Cloudflare montrent Clef en retrait sur les jeux de raisonnement plus difficiles.
Le schéma est la vraie histoire. Des décisions bornées et calibrées au sein d’un agent peuvent passer à de petits modèles à poids ouverts que vous pouvez exécuter vous-même, avec une personne ou une politique déterministe derrière chaque étape peu sûre ou irréversible. Mesurez sur votre propre trafic avant de faire confiance à un seuil.