





















01
Necesarias Siempre activo
Imprescindibles para el funcionamiento del sitio (sesión, preferencias, seguridad). Siempre activas.
Runware dice que su producto Serverless ya está disponible: los clientes pueden ejecutar su propio código, modelos y contenedores en sus GPU. Los $0,63 por hora de GPU del titular son una tarifa reservada con compromiso; bajo demanda, el precio arranca en $1,60 por hora de GPU en L40S.
Runware anunció el 2 de octubre de 2026, en una entrada de lanzamiento firmada por Ryan Kerry (runware.ai/blog/runware-serverless-now-available), que su producto Serverless ya está disponible. Los clientes pueden ejecutar su propio código, modelos y contenedores en la infraestructura de GPU que hay detrás de sus Model APIs, con workers que bajan a cero cuando están inactivos. Una salvedad de entrada: el titular dice «desde $0,63 por hora de GPU» (traducción nuestra), pero esa tarifa corresponde a capacidad reservada en RTX PRO 6000, con tarifa y compromiso acordados para cada despliegue. Bajo demanda, el precio arranca en $1,60 por hora de GPU en L40S, facturado por segundos sobre capacidad compartida.
La entrada también afirma ofrecer «cómputo a la mitad del coste de una neocloud» (traducción nuestra), algo que no justifica y que no hemos verificado. El anuncio no dice dónde se ejecutan las cargas de trabajo ni qué condiciones de residencia de datos se aplican. Para un proveedor que aloja fine-tunes o modelos privados de clientes, el escalado a cero puede ganar a una GPU siempre encendida en coste en reposo. Pero la cuestión contractual es la capacidad, no la tarifa del titular, porque la propia Runware dice que un worker caliente no es una reserva.
El resto del artículo explica qué se ha lanzado, cómo funciona la facturación, qué significa capacidad, las preguntas sobre residencia de datos y qué no es esta noticia.
Todo lo que aparece en esta sección procede de la entrada de Runware del 2 de octubre de 2026. El producto permite a los clientes ejecutar su propio código, modelos o contenedores en el pool de GPU que sirve las Model APIs de Runware. Runware se encarga de la planificación, el ciclo de vida de los workers, el escalado, la ejecución y la medición del consumo; el cliente controla el código, las dependencias y los requisitos de cómputo.
Hay dos formas de entrar: una base de código Python que Runware empaqueta y compila, o un contenedor del cliente cuando el entorno de ejecución y las dependencias deben quedar fijados (la entrada menciona mantener versiones de CUDA y bibliotecas). El modelo de trabajos es asíncrono: se envía un trabajo, se planifica en el pool de workers de la aplicación y se recupera el resultado. Runware no lo describe como un endpoint síncrono de baja latencia.
Los workers tienen 1, 2, 4 u 8 GPU cada uno, cuando el tipo de GPU y la capacidad lo permiten. La carga de trabajo tiene que repartirse ella misma entre las GPU; la entrada dice claramente que elegir cuatro GPU no hace que un código pensado para una sola GPU vaya cuatro veces más rápido. Según Runware, sus Sonic Pods albergan unas 1.200 GPU en un contenedor de 20 pies con refrigeración líquida, y la empresa los construye ella misma para abaratar su coste de suministrar cómputo. No hemos inspeccionado ninguno.
La observabilidad incluye un panel con despliegues, estado de los workers, asignación de GPU, profundidad de la cola, solicitudes, errores, registros y costes, además de SDK, CLI y API. La captura de la consola que aparece en la página está marcada como datos simulados. La gama de productos en una línea: Model APIs para los modelos del catálogo, Serverless para tu propia carga en una plataforma gestionada y Runware Compute para acceso directo a máquinas.
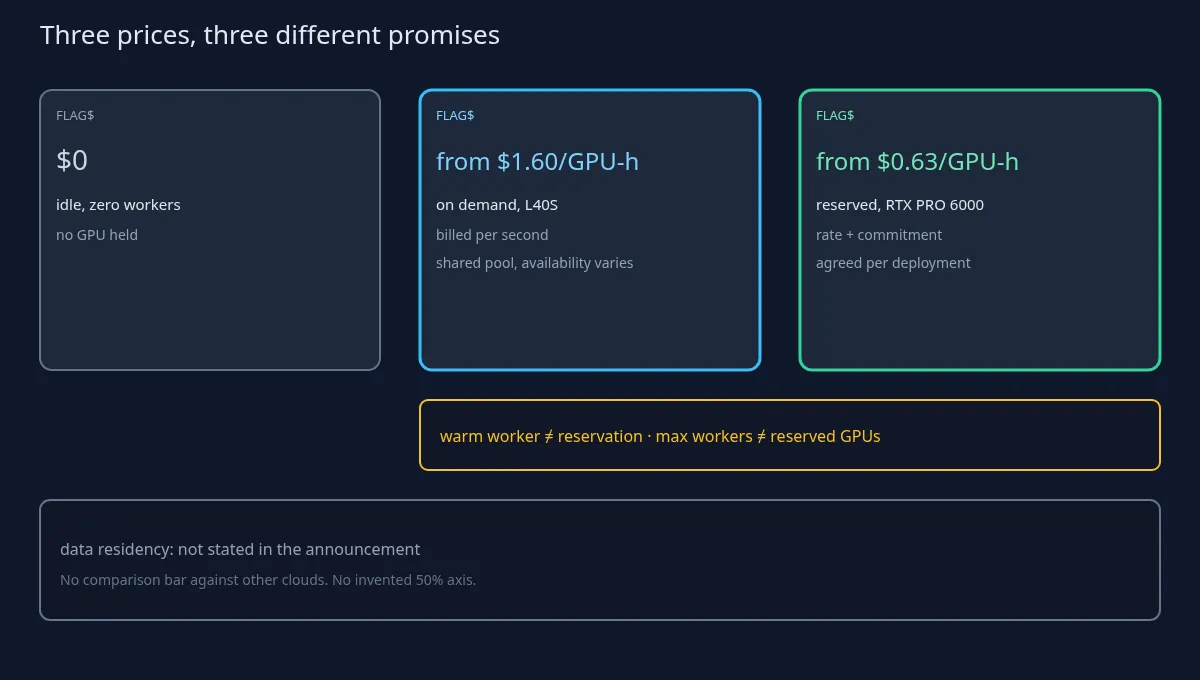
Pon en fila las tres cifras y no las mezcles. Las tres son precios de lista del proveedor. $0 de cómputo en reposo con cero workers. Desde $1,60/hora de GPU bajo demanda (L40S), facturación por segundos, sin compromiso a largo plazo, capacidad compartida. Desde $0,63/hora de GPU reservada (RTX PRO 6000), tarifa y compromiso acordados por despliegue. «Desde» indica un mínimo para un tipo de GPU; las tarifas varían según el hardware.
El problema del titular en una frase: el título de la página y su primera línea destacan $0,63, que es el mínimo con reserva. Quien solo vea el título calculará una carga bajo demanda a menos de la mitad de su tarifa de partida real.
«La mitad del coste de una neocloud» es una afirmación del proveedor. La entrada no da ninguna base para la comparación: qué neocloud, qué GPU, qué nivel de uso, qué periodo. No la hemos verificado, y este artículo no calcula un porcentaje propio.
Detalles de facturación que merecen la atención de un MSP, todos de la entrada: bajo demanda se paga desde que un worker ocupa una GPU hasta que la libera, incluida la carga del modelo tras la asignación y el tiempo en reposo con el worker caliente entre trabajos. No se factura: la espera de capacidad, la descarga de la imagen antes de la asignación ni la recuperación por parte de Runware tras un fallo de la plataforma. Los workers multi-GPU se facturan por cada GPU asignada. Sobre el rendimiento, la entrada sostiene que la tarifa por hora por sí sola no muestra lo que cuesta una carga, porque el trabajo realizado por hora de GPU varía. Es cierto en general, y también significa que ninguno de estos precios puede convertirse en un coste por solicitud. La entrada no incluye tabla de TCO, ni cifras de ahorro de clientes, ni comparaciones con hiperescaladores concretos.
La idea de la propia Runware, parafraseada: mantener un worker caliente cuesta dinero y no constituye una reserva de capacidad. Los workers calientes ayudan a la latencia; una reserva asegura una cantidad acordada de capacidad de GPU. Son promesas distintas, y confundirlas es la manera en que un SLA acaba redactado sobre el control equivocado.
El ajuste del número máximo de workers, también según la entrada, limita la cantidad de workers y no reserva esas GPU en el pool compartido. El escalado bajo demanda se produce «según la disponibilidad de GPU» (traducción nuestra), y los trabajos esperan en la cola cuando no hay capacidad. Los workers multi-GPU necesitan varias GPU libres a la vez y pueden tardar más en colocarse cuando el pool está ocupado. El remedio que propone la propia entrada es reservar una capacidad base.
Arranques en frío: Runware dice que ha creado optimizaciones de arranque y volúmenes persistentes para pesos y cachés, y que los tiempos de arranque siguen variando según el tamaño del modelo, el entorno de ejecución, la disponibilidad y la configuración. No hay cifras publicadas de arranque en frío, y este artículo no estima ninguna.
Para un MSP, eso significa: si un contrato con un cliente promete un tiempo de respuesta, el pool bajo demanda más un worker caliente no es, según la propia descripción del proveedor, una garantía de capacidad. La garantía es la capacidad base reservada, con precio y compromiso por despliegue. Es una cuestión contractual, no una crítica. Preguntas para el formulario de pedido: tamaño y tipo de GPU de la capacidad base reservada; qué pasa con los trabajos en cola cuando la demanda supera la reserva; y si la recuperación tras un fallo de la plataforma incluye algún crédito de servicio (la entrada dice que la recuperación no se cobra; no menciona créditos ni SLA).
Primero, la laguna: la entrada de lanzamiento no menciona regiones, residencia de datos, condiciones de tratamiento de datos, subencargados ni plazos de conservación de registros y datos de los trabajos. No rellenamos ninguno de esos huecos, y la descripción de los Sonic Pods tampoco revela una región.
Por qué le importa a un MSP que aloja el fine-tune o el modelo privado de un cliente: los pesos, las entradas de los trabajos, las salidas y los registros que muestra el panel son datos del cliente o derivan de ellos. Traer tu propio contenedor mantiene el control del entorno de ejecución; por sí solo no dice dónde están las GPU ni quién puede ver los volúmenes.
Preguntas para Runware antes de poner encima una carga de un cliente, como preguntas y no como acusaciones: dónde se ejecutan físicamente los workers y los volúmenes persistentes; si un despliegue puede fijarse a una región; cuánto tiempo se conservan los datos de los trabajos, los resultados y los registros; quiénes son los subencargados; cómo se pasan los secretos a los contenedores; qué ocurre con los volúmenes cuando se elimina una aplicación.
Trata las claves de API y las credenciales del registro de modelos de esta plataforma como cualquier otro secreto de producción: almacén de secretos, rotación, mínimo privilegio. La página no hace afirmaciones sobre nube soberana, certificaciones ni jurisdicción, y este artículo tampoco.
Esto no es Prime Inference, otra oferta de inferencia, y aquí no hay tabla comparativa. Tampoco es Nebius e Inferize, una adquisición orientada a los arranques en frío dentro de Nebius Token Factory; esa operación es otra noticia.
Esto no es Cloudflare Web Search: es un producto de búsqueda, no cómputo de GPU. No es el lanzamiento de un modelo ni una noticia de chips: Runware Serverless es una capa de cómputo para tus propias cargas. Sin benchmarks de modelos ni hojas de ruta de aceleradores.
En resumen, los únicos precios que respalda la página, todos ellos precios de lista del proveedor: $0 de cómputo en reposo con cero workers; bajo demanda desde $1,60/hora de GPU en L40S, con facturación por segundos sobre capacidad compartida; reservado desde $0,63/hora de GPU en RTX PRO 6000, con compromiso acordado por despliegue. «La mitad del coste de una neocloud» es una afirmación del proveedor no verificada. Las afirmaciones sobre arranques en frío y rendimiento no tienen benchmarks públicos. El anuncio no indica la residencia de datos.
Antes de firmar, consigue por escrito la capacidad base reservada, el comportamiento de la cola por encima de ella y las respuestas sobre residencia de datos. Hasta entonces, presupuesta con la tarifa bajo demanda, no con la del titular.