





















01
Notwendig Immer aktiv
Erforderlich für den Betrieb der Seite (Login, Einstellungen, Sicherheit). Immer aktiv.
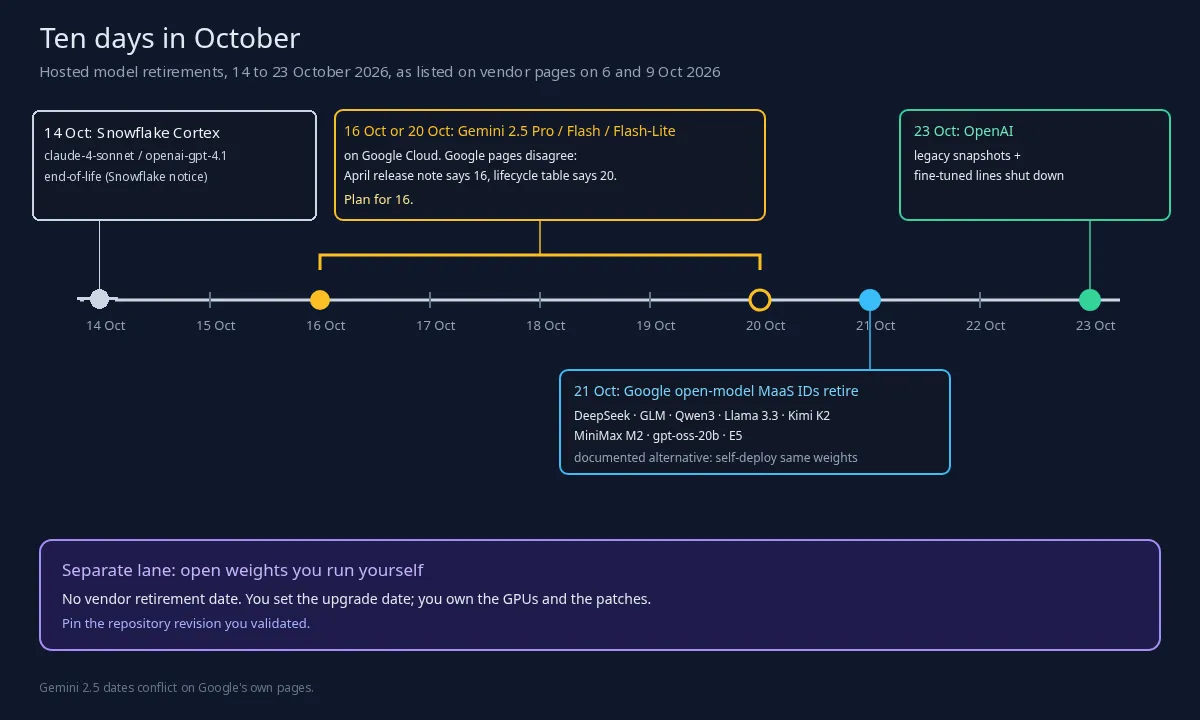
Innerhalb von zehn Tagen im Oktober 2026 erreichen mehrere gehostete Modell-IDs ihr Einstellungsdatum: OpenAI-Legacy-Snapshots am 23. Oktober, Googles MaaS-IDs für offene Modelle am 21. Oktober, Gemini 2.5 auf Google Cloud am 16. oder 20. Oktober und zwei Snowflake-Cortex-Modelle am 14. Oktober. Pinnen Sie Modell-IDs, geben Sie jeder eine verantwortliche Person und wissen Sie, welche Open Weights Sie selbst betreiben könnten.
Beginnen Sie mit dem Kalender. Innerhalb von zehn Tagen im Oktober 2026 erreichen mehrere gehostete Modell-IDs ihr Einstellungsdatum. Die Deprecations-Seite von OpenAI listet einen Block von Legacy-Snapshots und feinabgestimmten Modelllinien auf, deren Abschaltdatum der 23. Oktober 2026 ist. Googles Model-as-a-Service-Tabelle für offene Modelle nennt den 21. Oktober als Einstellungsdatum für die IDs von DeepSeek, GLM, Qwen3, Llama 3.3, Kimi K2, MiniMax M2, gpt-oss-20b und E5-Embeddings und als Alternative, dieselben Gewichte selbst bereitzustellen. Bei Gemini 2.5 Pro, Flash und Flash-Lite widersprechen sich Googles eigene Seiten: Eine Release Note aus dem April nennt den 16. Oktober, die am 6. Oktober gelesene Lifecycle-Tabelle den 20. Oktober. Snowflakes eigene Deprecation-Mitteilung nennt den 14. Oktober 2026 als End-of-Life-Datum für zwei Cortex-Modelle, claude-4-sonnet und openai-gpt-4.1.
Die These passt in zwei Sätze. Eine gehostete Modell-ID ist eine Abhängigkeit mit Ablaufdatum und gehört deshalb in ein Inventar mit einer namentlich benannten verantwortlichen Person. Open Weights, die Sie selbst betreiben, haben kein Abschaltdatum eines Anbieters, verlagern aber den Upgrade-Takt, die Hardware und das Patchen zu Ihnen.
Was folgt: der Kalender nach Anbietern, was „eingestellt“ in der Praxis bedeutet, sechs Gewohnheiten zum Pinnen von Modell-IDs, die ehrlichen Zielkonflikte beim Self-Hosting und ein Kasten zu Kolibri von Aleph Alpha, veröffentlicht am 3. Oktober mit Open Weights unter Apache 2.0. Jedes Datum unten stammt von einer Anbieterseite; diese Seiten wurden am 6. Oktober 2026 erneut geprüft, die von Snowflake am 9. Oktober 2026.
OpenAI, 23. Oktober. Der auf den 22. April 2026 datierte Abschnitt der Deprecations-Seite von OpenAI listet diese Snapshots zur Abschaltung am 23. Oktober: gpt-3.5-turbo-0125, gpt-4-0613, gpt-4-turbo, gpt-4.1-nano, gpt-4o-2024-05-13, gpt-image-1, o1-2024-12-17, o1-pro-2025-03-19, o3-mini-2025-01-31, o4-mini-2025-04-16 und ft-o4-mini-2025-04-16, dazu feinabgestimmte Linien auf gpt-3.5-turbo, gpt-4, gpt-4.1-nano, babbage-002 und davinci-002. Als Ersatz nennt OpenAI die Familie gpt-5.6-sol, gpt-5.6-terra und gpt-5.6-luna, für gpt-image-1 außerdem gpt-image-2.5-sunburst oder gpt-image-2.5-flare. Mehrere Zeilen führen in einer separaten Spalte auch verwandte Namen auf, und die Tabelle sagt nicht eindeutig, ob auch diese Namen abgeschaltet werden. Wo eine Zeile verwandte Namen aufführt, gleichen Sie jeden Namen, den Ihr Code aufruft, mit der Seite ab.
Offene Modelle bei Google, 21. Oktober. Googles Deprecations-Tabelle für offene Modelle im MaaS-Angebot listet DeepSeek (OCR, R1-0528, V3.1 und V3.2), GLM (5 und 4.7), gpt-oss-20b, Kimi K2 Thinking, Llama 3.3 70B Instruct, MiniMax M2, zwei mehrsprachige E5-Embedding-Modelle und vier Qwen3-Varianten auf: insgesamt 16 Modell-IDs mit dem Einstellungsdatum 21. Oktober. Alle wurden am 21. Juli als veraltet markiert, und jede Zeile nennt als Alternative, das Modell selbst über Model Garden bereitzustellen.
Gemini 2.5 auf Google Cloud, 16. oder 20. Oktober. Eine Release Note aus dem April nannte den 16. Oktober; Googles am 6. Oktober gelesene Lifecycle-Tabelle zeigt den 20. Oktober. Planen Sie mit dem früheren Datum und prüfen Sie die Lifecycle-Seite für Ihr Projekt. Im Detail: Eine Release Note zu Vertex AI von etwa dem 2. April 2026 besagt, dass die Einstellungsdaten für Gemini 2.5 Pro, Flash-Lite und Flash „auf den 16. Oktober 2026 aktualisiert wurden“ (unsere Übersetzung). Die aktuelle Tabelle zu Modellversionen und Lifecycle zeigt für alle drei den 20. Oktober, mit Ersatzmodellen wie gemini-3.8-flash, gemini-3.5-flash, gemini-3.5-flash-lite und gemini-3.1-flash-lite. Eine spätere Notiz, die den Unterschied erklärt, haben wir nicht gefunden. Googles Deprecations-Seite für die Gemini API nennt für diese drei Modelle kein Abschaltdatum; der Termin hängt also davon ab, welche Google-Oberfläche ein Workload aufruft.
Snowflake Cortex, 14. Oktober. Snowflakes Mitteilung zu Deprecations von Cortex-Modellen nennt den 14. Oktober 2026 als End-of-Life-Datum für claude-4-sonnet und openai-gpt-4.1, die am 12. August 2026 in den Legacy-Status übergingen. Nach dem End-of-Life-Datum schlagen Abfragen und API-Aufrufe fehl, die eines der beiden Modelle nennen.
ChatGPT und Codex, 14. Oktober. OpenAIs offizielles Changelog für ChatGPT und Codex legt in einem Eintrag vom 14. September 2026 den 14. Oktober 2026 als Datum fest, an dem GPT-5.5 in ChatGPT, ChatGPT Work und Codex für alle Tarife eingestellt wird, einschließlich Business, Enterprise und Edu. Laut demselben Eintrag gilt die Einstellung nicht für die OpenAI-API; API-Aufrufe an gpt-5.5 sind davon also nicht betroffen. In Codex brauchen Workspace-Standards, gespeicherte Modelleinstellungen, eigene Agenten, geplante Aufgaben und Skripte, die noch gpt-5.5 auswählen, ein Ersatzmodell.
Der Kalender endet nicht mit dem Oktober. Die nächsten OpenAI-Termine, die bereits auf der Seite stehen, sind der 1. Dezember für GPT-Image-Modelle und der 11. Dezember für datierte GPT-5- und o3-Snapshots.
„Eingestellt“ klingt nach Verwaltungsakt. In der Produktion bedeutet es Fehler. Googles Seite zu offenen Modellen definiert zwei Phasen. Während der Deprecation-Phase funktioniert der Endpunkt für bestehende Workloads weiter, damit Sie migrieren können, neue Nutzung des Endpunkts kann aber eingeschränkt werden. Am Einstellungsdatum wird der Endpunkt deaktiviert, und API-Anfragen, die eine eingestellte Modell-ID aufrufen, schlagen fehl.
OpenAI formuliert es kürzer: Bei der Abschaltung ist ein Modell oder Endpunkt nicht mehr erreichbar. Eine Regel auf derselben Seite überrascht viele Teams. Die Inferenz auf einem feinabgestimmten Modell endet, wenn sein Basismodell als veraltet markiert wird; ein Fine-Tune ist also nur so langlebig wie die Basis, auf der er trainiert wurde. Der Kunde, der letztes Jahr für einen Fine-Tune bezahlt hat, hat etwas gekauft, das das Ablaufdatum des Basismodells trägt.
Die Vorlaufzeiten hängen von der Phase ab. Die OpenAI-Seite sagt mindestens sechs Monate für allgemein verfügbare Modelle zu, mindestens drei Monate für spezialisierte Varianten und möglicherweise nur etwa zwei Wochen für Modelle mit preview im Namen. Google hält offene Modelle in der Preview-Phase mindestens 45 Tage ab Veröffentlichung verfügbar. Die praktische Regel: Preview-IDs gehören nicht auf einen kritischen Pfad mit Kundenbezug, es sei denn, der Vertrag erlaubt eine schnelle Migration.
Es gibt einen Notausgang, und der ist kommerziell. OpenAI schreibt, dass manche Entwickler über das Vertriebsteam dedizierte Kapazität für den weiteren Zugriff nach einem Abschaltdatum vereinbaren können. Das ist eine Verhandlung, kein Standard, und es sollte nicht der Plan sein.
Was in einer MSP-Umgebung bricht, ist selten die Vorzeige-App. Es ist der vergessene Zusammenfasser in einer Ticketing-Integration, der Embedding-Job hinter einem Suchindex oder der Fine-Tune, den ein Kunde letztes Jahr bezahlt hat. Einstellungen von Embedding-Modellen zählen doppelt: Ein neues Embedding-Modell bedeutet meist, den Korpus neu zu indexieren, nicht nur einen Namen in einer Konfigurationsdatei zu tauschen.
Eine Inventarzeile braucht eine gepinnte ID, das Datum, einen Ersatz im Test und eine namentlich benannte verantwortliche Person. Das illustrative YAML unten zeigt die Form; jeder Name darin ist ein Platzhalter.
# model-inventory.yaml: one row per call site, reviewed monthly
- call_site: ticket-summarizer
  provider: openai
  model_id: o4-mini-2025-04-16        # listed for shutdown 2026-10-23
  replacement_under_test: gpt-5.6-terra
  owner: platform-team
  eval_set: summaries-golden-v3
  cutover_ticket: CHG-0000
- call_site: kb-search-embeddings
  provider: google-maas
  model_id: multilingual-e5-large-instruct-maas   # retires 2026-10-21
  plan: self-deploy same weights OR switch model + re-index
  owner: search-team
Pinnen ist kein Produkt. Es sind sechs Gewohnheiten, jede mit etwas, das als Nachweis zählt.
1. Rufen Sie in der Produktion datierte Snapshots auf, keine gleitenden Namen. Ein gleitender Name kann unbemerkt auf ein neues Modell wechseln. Eine datierte ID ändert sich nur, wenn Sie sie ändern. Nachweis: Die ausgerollte Konfiguration zeigt die datierte ID. Kein Nachweis: „Wir nutzen das neueste.“
2. Führen Sie eine Inventarzeile pro Aufrufstelle, mit Anbieter, exakter ID, verantwortlicher Person, Einstellungsdatum und dem Ersatz im Test. Durchsuchen Sie Code, Infrastrukturkonfiguration und Low-Code-Automatisierungen, nicht nur die Hauptanwendung. Die Aufrufstellen, die wehtun, sind meist die außerhalb des Haupt-Repositorys gebauten.
3. Abonnieren Sie die maßgebliche Quelle. Das sind die Deprecations-Seiten der Anbieter und die Konto-E-Mails, die sie verschicken. Ein Sammel-Newsletter ist ein Hinweis, keine Quelle. Dieser Artikel belegt das: Bei Gemini 2.5 widerspricht eine Google-Seite einer anderen Google-Seite.
4. Testen Sie den Ersatz mit Ihrem eigenen Traffic und einem kleinen Golden Set vor der Umstellung: Ausgabeformat, Verweigerungen, Latenz und Kosten pro Aufgabe. Gehen Sie nie davon aus, dass sich ein „empfohlener Ersatz“ genauso verhält wie das Modell, das er ersetzt.
5. Stellen Sie vor dem Datum um, mit einem Rollback-Fenster, das vor dem Datum endet. Ein Rollback auf eine eingestellte ID ist kein Rollback. Wenn das früheste plausible Datum der 16. Oktober ist, schließt das Rollback-Fenster vor dem 16. Oktober.
6. Behandeln Sie geänderte Standardwerte wie Releases. Wenn ein Anbieter ändert, auf welches Modell ein Standardname zeigt, können sich Rechnung und Verhalten ohne jede Preisänderung verschieben. Erst das Pinnen macht daraus eine geplante Änderung mit Ticket, Test und verantwortlicher Person.
Den klarsten Beleg dafür, dass gehosteter Zugang und das Modell selbst zwei verschiedene Dinge sind, liefert Google. Für jedes offene Modell mit dem Einstellungsdatum 21. Oktober dokumentiert Googles eigene Tabelle die Alternative: dieselben Gewichte selbst über Model Garden bereitstellen. Der Endpunkt verschwindet, die Gewichte nicht.
Was Sie gewinnen, ist konkret. Gewichte, die Sie herunterladen und selbst ausliefern, verschwinden nicht, weil ein Anbieter einen Endpunkt einstellt. Sie entscheiden, wann Sie aktualisieren, und können genau die Revision behalten, die Sie validiert haben. Pinnen Sie die getestete Repository-Revision, nicht nur den Modellnamen, denn ein Modell-Repository kann sich nach Ihrem ersten Download ändern.
Was Sie übernehmen, ist ebenso konkret: GPUs oder reservierte Kapazität, einen Serving-Stack und dessen Updates, Monitoring, Ihre eigene Evaluierung vor jedem Upgrade und das Sicherheits-Patching von allem rund um das Modell. Das sind echte Betriebskosten. Die Höhe hängt von Ihrem Workload und Ihren Verträgen ab, daher nennt dieser Artikel keine Zahl.
Lizenzen unterscheiden sich. Manche offenen Modelle erscheinen unter Apache 2.0, andere unter eigenen Lizenzen mit eigenen Bedingungen zu Nutzung, Namensnennung oder Größenordnung. Lesen Sie die Lizenz genau des Repositorys, bevor ein Kunde davon abhängt, und legen Sie eine Kopie neben die Inventarzeile.
Wo passt das für einen MSP? Gleichmäßige, klar umrissene Workloads wie Klassifikation, Extraktion und Retrieval über die eigenen Dokumente eines Kunden sind gute Kandidaten. Reasoning auf Frontier-Niveau bei sprunghafter Nachfrage ist es oft nicht. Ein hybrider Ansatz ist normal: gehostete Modelle für die schwierigen Fälle, gepinnte selbst gehostete Gewichte für den planbaren Kern. Das ist ein allgemeines Muster, keine Empfehlung für ein bestimmtes Hosting-Produkt.
Kasten: Kolibri, Open Weights veröffentlicht am 3. Oktober. Aleph Alpha hat Kolibri am 5. Oktober 2026 aus Heidelberg in einer Pressemitteilung angekündigt. Das Modell ist seit dem 3. Oktober verfügbar und unterstützt Deutsch und Englisch. Laut Unternehmen ist es für den Betrieb auf Infrastruktur ausgelegt, die die Kunden selbst kontrollieren, mit dokumentierter Datenherkunft und dokumentierten Designentscheidungen. Es unterstützt agentische Workflows, Retrieval-Augmented Generation und natives Tool-Calling, und laut Aleph Alpha wurde es darauf trainiert, sich zu enthalten, wenn die bereitgestellten Dokumente keine Belege enthalten.
Der Aufbau laut Model Card auf Hugging Face: ein Mixture-of-Experts-Modell mit insgesamt 78 Milliarden Parametern und etwa 3,46 Milliarden aktiven Parametern pro Token (die Pressemitteilung rundet auf rund 3 Milliarden). Der native Kontext beträgt 262.144 Token; laut Card wurde die Qualität bis etwa eine Million Token validiert, für effizientes Serving wird aber empfohlen, bei höchstens 262.144 zu bleiben.
Die Lizenz, am 6. Oktober auf der Card geprüft, ist Apache 2.0 für die in diesem Repository veröffentlichten Gewichte und Konfigurationsdateien. Die Card sagt auch, worauf sich die Lizenz nicht erstreckt: zugrunde liegenden Code, Modellarchitektur, Parametereinstellungen oder Trainingsmethoden. „Open Weights unter Apache 2.0“ ist die zutreffende Beschreibung. Den gesamten Stack Open Source zu nennen, geht über das hinaus, was die Card behauptet.
Die Hardware-Realität, ebenfalls laut Card: FP8-Gewichte mit einem Speicherbedarf von etwa 78 GB und als Minimum zwei A100 80 GB, zwei H100 SXM5 oder eine H200, B200 oder B300. Für das Serving nutzt man Aleph Alphas Paket aleph-alpha-inference, ein vLLM-Plugin, oder das zugehörige Container-Image, und die Card zeigt eine OpenAI-kompatible API, sobald das Modell so ausgeliefert wird. Wenige aktive Parameter senken die Rechenlast pro Token. Den Speicherbedarf senken sie nicht: Das ganze Modell muss trotzdem hineinpassen.
Warum es hierher gehört: Für selbst gehostete Gewichte gilt kein Abschaltdatum eines Anbieters, und Kolibri ist ein aktuelles, datiertes Beispiel für diese Option bei deutsch- und englischsprachiger Arbeit. Drei Punkte zum Kontext sind wichtig. Laut Card ist das Modell für Workflows gedacht, in denen ein Mensch die Ausgabe prüft, bevor danach gehandelt wird. Die Vereinbarung zwischen Aleph Alpha und Cohere steht noch unter regulatorischem Vorbehalt, und das Unternehmen arbeitet bis zum Abschluss unabhängig weiter. Und „souverän“ ist in der Mitteilung von Aleph Alpha das Wort des Unternehmens für Kundenkontrolle und Wahlfreiheit. Es ist keine Zertifizierung, und dieser Artikel beansprucht keine.
Der geprüfte Kalender in einem Absatz: Das Abschaltdatum der Legacy-Snapshots und feinabgestimmten Linien von OpenAI ist der 23. Oktober. Das Einstellungsdatum von Googles MaaS-IDs für offene Modelle ist der 21. Oktober, mit der Selbstbereitstellung derselben Gewichte als von Google selbst dokumentierter Alternative. Für Gemini 2.5 Pro, Flash und Flash-Lite auf Google Cloud ist das Einstellungsdatum der 16. oder 20. Oktober, je nachdem, welche Google-Seite man liest; planen Sie also mit dem 16. Snowflakes End-of-Life-Datum für claude-4-sonnet und openai-gpt-4.1 in Cortex ist der 14. Oktober.
Die Betriebsregel ändert sich nicht mit dem Anbieter. Eine gehostete Modell-ID ist eine Abhängigkeit mit Ablaufdatum: pinnen, inventarisieren, einer verantwortlichen Person zuordnen und den Ersatz vor dem Datum mit eigenem Traffic testen. Open Weights, die Sie selbst betreiben, haben kein Abschaltdatum eines Anbieters, aber Upgrade-Takt, Hardware und Patching liegen dann bei Ihnen. Kolibri ist ein datiertes Beispiel für Open Weights unter Apache 2.0, mit einer Lizenz, die laut Model Card auf die Gewichte und Konfigurationsdateien im Repository beschränkt ist.
Alle hier zitierten Anbieterseiten wurden am 6. Oktober 2026 erneut gelesen, die Mitteilung von Snowflake am 9. Oktober 2026. Wenn ein Anbieter ein Datum verschiebt, wird dieser Artikel korrigiert.