





















01
Notwendig Immer aktiv
Erforderlich für den Betrieb der Seite (Login, Einstellungen, Sicherheit). Immer aktiv.
Am 1. Oktober 2026 veröffentlichte Cloudflare die Entscheidungsmodelle Clef und Clef-flash und Strands Labs Strands Decider 2B, alle mit offenen Gewichten unter Apache 2.0. Hier steht, wo kleine, kalibrierte Entscheidungsmodelle in die Agenten eines MSP passen und wo sie enden.
Am 1. Oktober 2026 veröffentlichten zwei Unternehmen am selben Tag dieselbe Idee. Cloudflare brachte zwei Entscheidungsmodelle heraus, Clef und Clef-flash, gehostet auf Workers AI und auf Hugging Face unter Apache 2.0 veröffentlicht. Am selben Tag veröffentlichte Strands Labs Strands Decider 2B, ein Entscheidungsmodell mit zwei Milliarden Parametern, dessen Gewichte, Trainingsdaten und Skripte offen unter Apache 2.0 stehen.
Ein Entscheidungsmodell schreibt keinen Text. Es liest eine Situation, den „State“, und eine Reihe typisierter Fragen und gibt für jede zulässige Antwort eine Wahrscheinlichkeit zurück, sodass Ihr Code ein Ticket weiterleiten, einen Tool-Aufruf freigeben oder anhalten oder an einen Menschen übergeben kann. Beide Anbieter stellen ihre Veröffentlichung als Antwort auf die Aufmerksamkeit rund um das Entscheidungsmodell Jev von Typesafe AI dar, und beide sagen, ihre Modelle seien mit dessen API kompatibel.
Für alles Folgende gilt ein Rahmen: Jede Genauigkeits- und Latenzzahl in diesem Artikel stammt vom Anbieter. Das gilt für den von Cloudflare gemeldeten Median von 209 ms für Clef und 39 ms für Clef-flash ebenso wie für die rund 115 ms, die Strands auf einer lokalen RTX 3090 meldet.
Für einen MSP ist nicht interessant, wer eine Rangliste anführt. Interessant ist, dass die kleinen, strukturierten, wiederkehrenden Entscheidungen in einem Agenten von einem großen Allzweckmodell auf etwas Günstiges, Kalibriertes und auf eigener Hardware Lauffähiges wandern können. Dieser Artikel erklärt, was ein Entscheidungsmodell ist, was jeder Anbieter geliefert hat, wo das Muster passt und wo es endet.
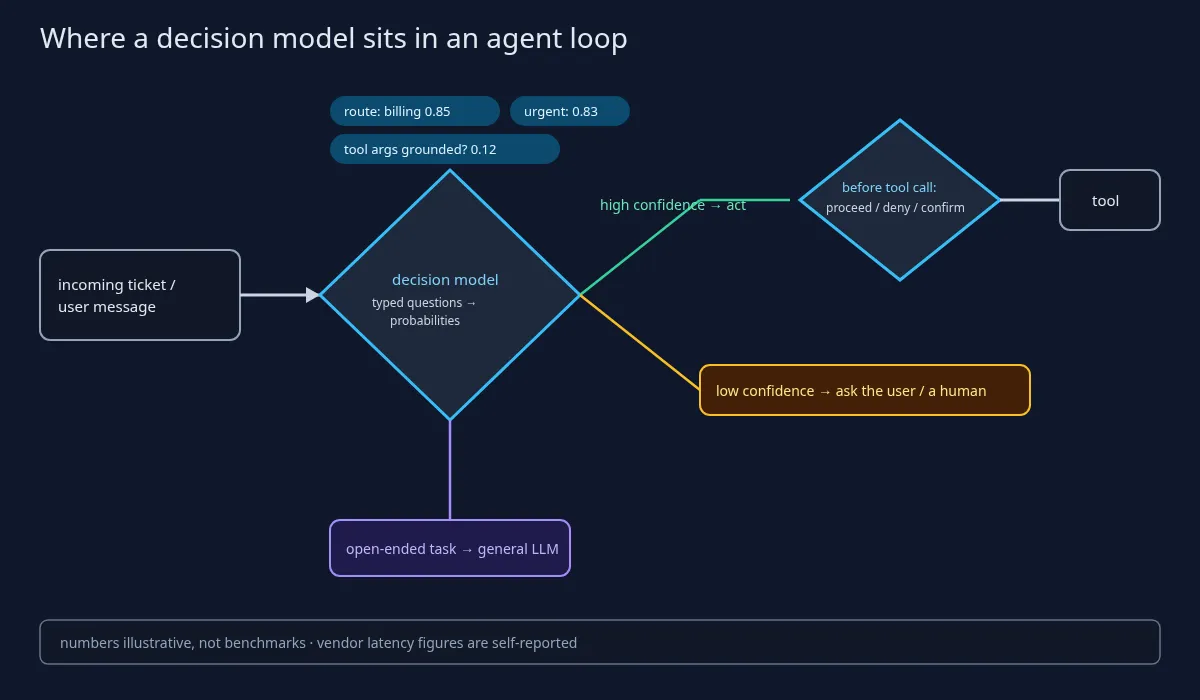
Beide Beiträge beschreiben dieselbe Schnittstelle. Man übergibt einen State, der Text oder JSON und bei Clef auch Bilder sein kann, sowie typisierte Fragen. Eine Ja/Nein-Frage heißt in beiden APIs noul, eine Auswahlfrage choice und eine geordnete Skala score. Das Modell gibt für jede zulässige Option eine Wahrscheinlichkeit zurück und antwortet immer aus den vorgegebenen Optionen.
Das ist aus zwei Gründen nützlich. Eine Antwort aus einer geschlossenen Menge muss nicht geparst werden und kann keine neue Kategorie erfinden. Und eine Wahrscheinlichkeit erlaubt dem Code, eine Schwelle zu setzen: darüber handeln, darunter einen Menschen fragen. Strands betont, dass mehrere Fragen zur selben Eingabe günstig gemeinsam gestellt werden können, sodass ein Durchlauf ein zuständiges Team, ein Dringlichkeitskennzeichen und eine Faktenprüfung liefern kann.
Die Anbieter beschreiben den Unterschied zu einem Sprachmodell über die Art, wie die Antwort entsteht. Die Entscheidung fällt in einem parallelen Durchlauf über die Eingabe statt Token für Token, und daher stammen die Geschwindigkeitsversprechen.
Ebenso wichtig ist, was ein Entscheidungsmodell nicht ist. Nach Angaben von Strands selbst ist sein Modell bei komplexen Problemen deutlich schwächer als Reasoning-Modelle und für Programmieren, Chat oder Zusammenfassungen nutzlos, weil es keinen Text erzeugen kann. Seine Stärke sind kleine, wiederholte Entscheidungen, nicht schwierige.
Klassifikatoren gibt es seit Jahren, und ein skeptischer Leser wird das sagen. Das Versprechen ist, so wie Cloudflares Beitrag es darstellt, ein einziges Modell, das neue Kategorien zur Anfragezeit ohne Neutraining akzeptiert: Man ändert die Frage, nicht das Modell.
Laut Cloudflares Beitrag vom 1. Oktober und seiner Modellkarte auf Hugging Face wurden zwei Modelle veröffentlicht: Clef und Clef-flash, gehostet auf Workers AI und unter Apache 2.0 herunterladbar. Die Karte beschreibt Clef als multimodales 27B-Modell, nachtrainiert auf Basis von Qwen3.8-27B, das Text, JSON, Bilder oder Video liest und in einem einzigen Forward-Pass ohne freie Textgenerierung antwortet. Laut Beitrag friert Clef-flash ein Qwen3.5-9B-Backbone ein. Beide ergänzen einen kleinen Routing-Kopf und Low-Rank-Adapter mit Rang 256, trainiert mit Kalibrierungsverlusten.
Cloudflare nennt zwei Dinge, die Clef nach eigener Aussage abheben: einen Vision-Encoder, sodass Bilder Teil des States sein können, und ein Kontextfenster von 64k Token, das es den 32k von Jev gegenüberstellt.
Die Zahlen stammen aus Cloudflares eigenem internem Lauf der Decision-Index-Suite und sind allesamt Herstellerangaben. Cloudflare meldet eine BFCL-Genauigkeit (case-exact) von 98,47 für Clef und 98,76 für Clef-flash. Es meldet eine Median-Latenz von 209,3 ms für Clef und 38,8 ms für Clef-flash sowie eine p95-Latenz von 238,6 ms beziehungsweise 122,4 ms.
Dieselben Tabellen zeigen auch die schwächere Seite. Cloudflares eigene Angaben zeigen Clef hinter Jev bei schwierigeren Reasoning-Sets wie GPQA Diamond, MMLU-Pro und BBH. Das passt ins Muster: Entscheidungsmodelle sind für eng gefasste Entscheidungen gebaut, nicht für schwieriges Schlussfolgern.
Zwei weitere Aussagen des Anbieters, als solche gekennzeichnet. In einer Anekdote berichtet Cloudflare, dass ein Workflow zur Domain-Klassifizierung mit Clef 2,2 Sekunden dauerte, mit gpt-oss-120b dagegen 4,7 Sekunden. Als Zusage erklärt Cloudflare, Anfragen und Antworten weder zu lesen noch zu speichern oder damit zu trainieren, es sei denn, der Kunde entscheidet sich für den Fine-Tuning-Dienst.
Selbst-Hosting ist möglich, aber nicht leichtgewichtig. Das Referenzbeispiel der Karte wurde auf einer einzelnen H200 getestet; Clef ist ein 27B-Modell, kein Laptop-Modell. Clef-flash und der gehostete Endpunkt sind die leichteren Wege. Cloudflare kündigte außerdem einen Fine-Tuning-Dienst auf Basis von Reinforcement Learning an, zunächst über seine Forward-Deployed Engineers und später als Self-Service; der Beitrag nennt keine Preise.
Laut dem Beitrag von Strands Labs vom 1. Oktober und seiner Modellkarte auf Hugging Face ist Strands Decider 2B ein Entscheidungsmodell mit zwei Milliarden Parametern auf Basis von Qwen3.5-2B, bei dem der Textgenerierungskopf entfernt und durch einen kleinen Pointer-Kopf mit gut einer Million Parametern ersetzt wurde, der jede Option bewertet. Der Rumpf wird mit einer LoRA vom Rang 16 feinabgestimmt. Der veröffentlichte Checkpoint ist v19, nach vielen Iterationen, deren Verlauf im Repository steht.
Offenheit ist die Schlagzeile. Der Code liegt auf GitHub, die Gewichte auf Hugging Face und, laut Strands, ebenso alle Trainingsdaten und Skripte, mit denen das Modell gebaut wurde, unter Apache 2.0. Laut Karte dauert ein Neutraining etwa 11 Stunden auf einer RTX 3090. Für einen MSP, der ein Entscheidungsmodell an seine eigenen Ticketkategorien anpassen will, ist genau diese Reproduzierbarkeit der Punkt.
Die Zahlen sind Herstellerangaben. Strands meldet einen Median von etwa 115 ms für lokale Entscheidungen auf einer RTX 3090, und laut Diagrammbeschriftung wurde diese Messung mit v18 statt v19 durchgeführt. Für kleine Aufgaben auf einem M3 MacBook meldet es etwa 153 ms. Die Karte meldet 167 von 231 öffentlichen JevBench-Aufgaben als korrekt und kennzeichnet dieses Ergebnis als „self-reported“.
Strands veröffentlicht seine eigenen Grenzen, und sie gehören in jede Einführungsnotiz. Lange mehrstufige Dokumente sind die Schwachstelle. Fragen werden weniger sorgfältig gelesen als die Dokumente. Die Kalibrierung wurde an kurzen Klassifizierungsaufgaben angepasst, daher rät die Karte, Schwellenwerte am eigenen Datenverkehr zu messen, bevor man ihnen vertraut.
Eine betriebliche Zeile, die ein MSP nicht übersehen darf: Laut Karte bindet der eingebaute Befehl strands-decider serve an 127.0.0.1 und hat keine Authentifizierung, und die Karte empfiehlt ihn für lokale Experimente. Stellen Sie ihn nicht unverändert in einem geteilten Netzwerk bereit.
Das ausgearbeitete Beispiel des Beitrags ist eine Prüfung vor einem Tool-Aufruf: Sind die Argumente des Tools durch das gedeckt, was der Nutzer tatsächlich gesagt hat, und ist es zu früh zum Handeln? Strands nennt es eine Veranschaulichung, keine Empfehlung, und so sollte man es lesen.
Unten steht das Beispiel von Strands aus seiner Modellkarte, ausgeführt auf einem lokalen Rechner. Die Karte merkt an, dass ein Neutraining etwas andere Zahlen ergibt.
pip install strands-decider

strands-decider ask StrandsAgents/strands-decider-2B-hobson-v19 \
  --state "Help! My payouts have been failing for 3 days! " \
  --choice "Which team should handle this?=billing,sales,retail" \
  --noul "Does this convey urgency?"
Beide Anbieter nennen dieselbe Familie von Einsatzzwecken, und sie passen gut zu den Agentenabläufen eines MSP: Ticket-Routing und Dringlichkeit, Modell-Routing (eine Anfrage an ein günstiges oder ein teures Modell schicken), Tool-Auswahl, Prüfungen vor einem Tool-Aufruf, Richtlinienklassifizierung und Alarm-Triage. Das sind die Routineentscheidungen, bei denen ein allgemeines LLM langsam, teuer und schwerer zu prüfen ist.
Strands beschreibt die hybride Form klar: Das LLM trifft die schwierigen Entscheidungen, das Entscheidungsmodell die Routineentscheidungen. Das senkt Kosten und Latenz nur, wenn Sie es an Ihrer eigenen Workload messen. Eine Einsparzahl gibt es hier nicht, denn für Ihre Workload existiert keine, bis Sie eine messen.
Kontrollen für die Einführung, aus Sicht der Verteidigung, jeweils mit ihrem Nachweis:
Was man nicht tun sollte: Ein Entscheidungsmodell darf nicht die einzige Schranke vor einer unumkehrbaren Aktion sein. Kombinieren Sie es mit einer deterministischen Richtlinie oder einem Menschen, so wie das Beispiel von Strands selbst mit seinen Aktionen proceed, deny und confirm.
Vier Dinge, die dieser Artikel nicht ist.
Er ist keine Besprechung von Jev von Typesafe. Beide Anbieter nennen Jev als Auslöser ihrer Veröffentlichungen; dieser Artikel hat Jev nicht getestet und zitiert keine Jev-Zahl außer so, wie sie in Cloudflares Tabellen erscheint.
Er handelt nicht von Laminar flow-1, einem kleinen Modell, das Agenten-Traces liest, um Fehler zu finden. Das ist eine andere Geschichte.
Er handelt nicht von Reflection Beam, einem großen Allzweckmodell, das angekündigt wurde, dessen Gewichte aber noch ausstehen.
Er ist kein Beitrag über die Preise von Workers AI. Cloudflares Beitrag nennt keinen Preis für Clef oder für den Fine-Tuning-Dienst, und dieser Artikel erfindet keinen.
Die geprüften Fakten: Am 1. Oktober 2026 veröffentlichte Cloudflare Clef, ein multimodales 27B-Entscheidungsmodell, nachtrainiert auf Basis von Qwen3.8-27B, und Clef-flash, auf Workers AI und auf Hugging Face unter Apache 2.0, mit einem Fine-Tuning-Dienst auf Basis von Reinforcement Learning in Aussicht. Am selben Tag veröffentlichte Strands Labs Strands Decider 2B, gebaut auf Qwen3.5-2B mit einer LoRA und einem Pointer-Kopf, mit Gewichten, Code, Trainingsdaten und Skripten unter Apache 2.0.
Jede Genauigkeits- und Latenzzahl in diesem Artikel stammt vom Anbieter: Clefs gemeldeter BFCL-Wert von 98,47 und Median von 209 ms, der gemeldete Median von 38,8 ms für Clef-flash und der von Strands gemeldete Wert von etwa 115 ms auf einer RTX 3090 für den Decider. Cloudflares eigene Tabellen zeigen Clef bei schwierigeren Reasoning-Sets im Rückstand.
Das Muster ist die eigentliche Geschichte. Eng gefasste, kalibrierte Entscheidungen in einem Agenten können zu kleinen Modellen mit offenen Gewichten wandern, die Sie selbst betreiben können, mit einem Menschen oder einer deterministischen Richtlinie hinter jedem Schritt mit geringer Konfidenz oder ohne Rückweg. Messen Sie an Ihrem eigenen Datenverkehr, bevor Sie einer Schwelle vertrauen.