





















01
Necessários Sempre ativo
Indispensáveis para o funcionamento do site (sessão, preferências, segurança). Sempre ativos.
A Runware diz que o seu produto Serverless está disponível: os clientes podem executar o seu próprio código, modelos e contentores nas suas GPU. Os $0,63 por hora de GPU da manchete são uma tarifa reservada com compromisso; a pedido, o preço começa em $1,60 por hora de GPU em L40S.
A Runware anunciou a 2 de outubro de 2026, numa publicação de lançamento assinada por Ryan Kerry (runware.ai/blog/runware-serverless-now-available), que o seu produto Serverless está disponível. Os clientes podem executar o seu próprio código, modelos e contentores na infraestrutura de GPU que suporta as suas Model APIs, com workers que descem a zero quando estão inativos. Uma ressalva logo à partida: a manchete diz «a partir de $0,63 por hora de GPU» (tradução nossa), mas essa tarifa aplica-se a capacidade reservada em RTX PRO 6000, com tarifa e compromisso acordados para cada implementação. A pedido, o preço começa em $1,60 por hora de GPU em L40S, faturado ao segundo em capacidade partilhada.
A publicação afirma ainda oferecer «computação a metade do custo de uma neocloud» (tradução nossa), o que não fundamenta e que não verificámos. O anúncio não diz onde correm as cargas de trabalho nem que condições de residência de dados se aplicam. Para um fornecedor que aloja fine-tunes ou modelos privados de clientes, escalar para zero pode bater uma GPU sempre ligada no custo em inatividade. Mas a questão contratual é a capacidade, não a tarifa da manchete, porque a própria Runware diz que um worker pré-aquecido não é uma reserva.
O resto deste artigo explica o que foi lançado, como funciona a faturação, o que significa capacidade, as questões de residência de dados e o que esta notícia não é.
Tudo nesta secção vem da publicação da Runware de 2 de outubro de 2026. O produto permite aos clientes executar o seu próprio código, modelos ou contentores no conjunto de GPU que serve as Model APIs da Runware. A Runware trata do agendamento, do ciclo de vida dos workers, do escalonamento, da execução e da medição do consumo; o cliente controla o código, as dependências e os requisitos de computação.
Há duas formas de entrar: uma base de código Python que a Runware empacota e compila, ou um contentor do cliente quando o ambiente de execução e as dependências têm de ficar fixados (a publicação menciona manter versões de CUDA e bibliotecas). O modelo de tarefas é assíncrono: submete-se uma tarefa, esta é agendada no conjunto de workers da aplicação e recupera-se o resultado. A Runware não o descreve como um endpoint síncrono de baixa latência.
Os workers têm 1, 2, 4 ou 8 GPU cada, quando o tipo de GPU e a capacidade o permitem. A carga de trabalho tem de se distribuir ela própria pelas GPU; a publicação diz claramente que escolher quatro GPU não torna quatro vezes mais rápido um código pensado para uma só GPU. Segundo a Runware, os seus Sonic Pods albergam cerca de 1200 GPU num contentor de 20 pés com arrefecimento líquido, e a empresa constrói-os ela própria para baixar o seu custo de fornecimento de computação. Não inspecionámos nenhum.
A observabilidade inclui um painel com implementações, estado dos workers, alocação de GPU, profundidade da fila, pedidos, erros, registos e custos, além de SDK, CLI e API. A captura de ecrã da consola na página está assinalada como dados simulados. A gama de produtos numa linha: Model APIs para modelos do catálogo, Serverless para a sua própria carga numa plataforma gerida, Runware Compute para acesso direto a máquinas.
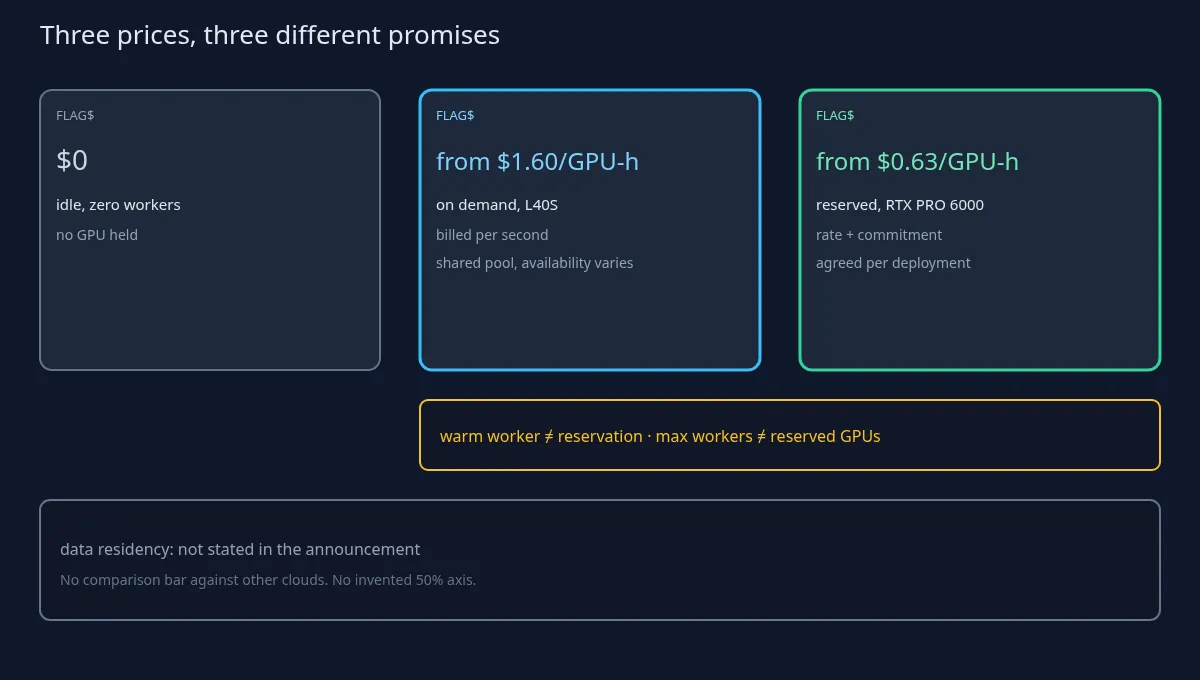
Alinhe os três valores e não os misture. Os três são preços de tabela do fornecedor. $0 de computação em inatividade com zero workers. A partir de $1,60/hora de GPU a pedido (L40S), faturação ao segundo, sem compromisso de longo prazo, capacidade partilhada. A partir de $0,63/hora de GPU reservada (RTX PRO 6000), tarifa e compromisso acordados por implementação. «A partir de» indica um mínimo para um tipo de GPU; as tarifas variam consoante o hardware.
O problema da manchete numa frase: o título da página e a primeira linha destacam $0,63, que é o mínimo com reserva. Quem só vir o título vai orçamentar uma carga a pedido por menos de metade da sua tarifa de partida real.
«Metade do custo de uma neocloud» é uma afirmação do fornecedor. A publicação não dá qualquer base para a comparação: que neocloud, que GPU, que taxa de utilização, que período. Não a verificámos, e este artigo não calcula uma percentagem própria.
Detalhes de faturação que merecem a atenção de um MSP, todos da publicação: a pedido, paga-se desde o momento em que um worker ocupa uma GPU até a libertar, incluindo o carregamento do modelo após a alocação e o tempo de inatividade com o worker pré-aquecido entre tarefas. Não se fatura: a espera por capacidade, a transferência da imagem antes da alocação e a recuperação, do lado da Runware, após uma falha da plataforma. Os workers multi-GPU são faturados por cada GPU alocada. Quanto ao débito, a publicação defende que a tarifa horária, por si só, não mostra quanto custa uma carga, porque o trabalho feito por hora de GPU varia. É verdade em geral, e também significa que nenhum destes preços pode ser convertido num custo por pedido. A publicação não inclui tabela de TCO, nem números de poupança de clientes, nem comparações com hiperescaladores identificados.
A ideia da própria Runware, em paráfrase: manter um worker pré-aquecido custa dinheiro e não constitui uma reserva de capacidade. Os workers pré-aquecidos ajudam na latência; uma reserva garante uma quantidade acordada de capacidade de GPU. São promessas diferentes, e confundi-las é a forma de um SLA acabar redigido sobre o controlo errado.
A definição do número máximo de workers, também segundo a publicação, limita a quantidade de workers e não reserva essas GPU no conjunto partilhado. O escalonamento a pedido acontece «sujeito à disponibilidade de GPU» (tradução nossa), e as tarefas esperam na fila quando não há capacidade. Os workers multi-GPU precisam de várias GPU livres ao mesmo tempo e podem demorar mais a ser colocados quando o conjunto está ocupado. O remédio que a própria publicação propõe é reservar uma capacidade de base.
Arranques a frio: a Runware diz ter criado otimizações de arranque e volumes persistentes para pesos e caches, e que os tempos de arranque continuam a variar com o tamanho do modelo, o ambiente de execução, a disponibilidade e a configuração. Não há números publicados de arranque a frio, e este artigo não estima nenhum.
Para um MSP, isto significa: se um contrato com um cliente promete um tempo de resposta, o conjunto a pedido mais um worker pré-aquecido não é, segundo a própria descrição do fornecedor, uma garantia de capacidade. A garantia é a capacidade de base reservada, com preço e compromisso por implementação. É uma questão contratual, não uma crítica. Perguntas para o formulário de encomenda: dimensão e tipo de GPU da capacidade de base reservada; o que acontece às tarefas em fila quando a procura excede a reserva; e se a recuperação após uma falha da plataforma inclui algum crédito de serviço (a publicação diz que a recuperação não é cobrada; não menciona créditos nem SLA).
Primeiro, a lacuna: a publicação de lançamento não indica regiões, residência de dados, condições de tratamento de dados, subcontratantes nem prazos de conservação de registos e dados das tarefas. Não preenchemos nenhum destes pontos, e a descrição dos Sonic Pods também não revela uma região.
Porque é que isto importa a um MSP que aloja o fine-tune ou o modelo privado de um cliente: os pesos, as entradas das tarefas, as saídas e os registos mostrados no painel são todos dados do cliente ou derivados deles. Trazer o seu próprio contentor mantém o controlo do ambiente de execução; por si só, não diz onde estão as GPU nem quem pode ver os volumes.
Perguntas a fazer à Runware antes de colocar lá uma carga de um cliente, como perguntas e não como acusações: onde correm fisicamente os workers e os volumes persistentes; se uma implementação pode ser fixada a uma região; durante quanto tempo são conservados os dados das tarefas, os resultados e os registos; quem são os subcontratantes; como são passados os segredos aos contentores; o que acontece aos volumes quando uma aplicação é eliminada.
Trate as chaves de API e as credenciais do registo de modelos desta plataforma como qualquer outro segredo de produção: cofre, rotação, privilégio mínimo. A página não faz afirmações sobre nuvem soberana, certificação ou jurisdição, e este artigo também não.
Isto não é o Prime Inference, outra oferta de inferência, e não há aqui tabela comparativa. Também não é a Nebius e a Inferize, uma aquisição orientada para os arranques a frio dentro do Nebius Token Factory; esse negócio é outra notícia.
Isto não é o Cloudflare Web Search: é um produto de pesquisa, não computação de GPU. Não é o lançamento de um modelo nem uma notícia sobre chips: o Runware Serverless é uma camada de computação para as suas próprias cargas. Sem benchmarks de modelos, sem roteiros de aceleradores.
Em resumo, os únicos preços que a página sustenta, todos preços de tabela do fornecedor: $0 de computação em inatividade com zero workers; a pedido a partir de $1,60/hora de GPU em L40S, com faturação ao segundo em capacidade partilhada; reservado a partir de $0,63/hora de GPU em RTX PRO 6000, com compromisso acordado por implementação. «Metade do custo de uma neocloud» é uma afirmação do fornecedor não verificada. As afirmações sobre arranques a frio e débito não têm benchmarks públicos. O anúncio não indica a residência de dados.
Antes de assinar, obtenha por escrito a capacidade de base reservada, o comportamento da fila acima dela e as respostas sobre residência de dados. Até lá, orçamente com a tarifa a pedido, não com a da manchete.