





















01
Niezbędne Zawsze włączone
Wymagane do działania strony (logowanie, preferencje, bezpieczeństwo). Zawsze włączone.
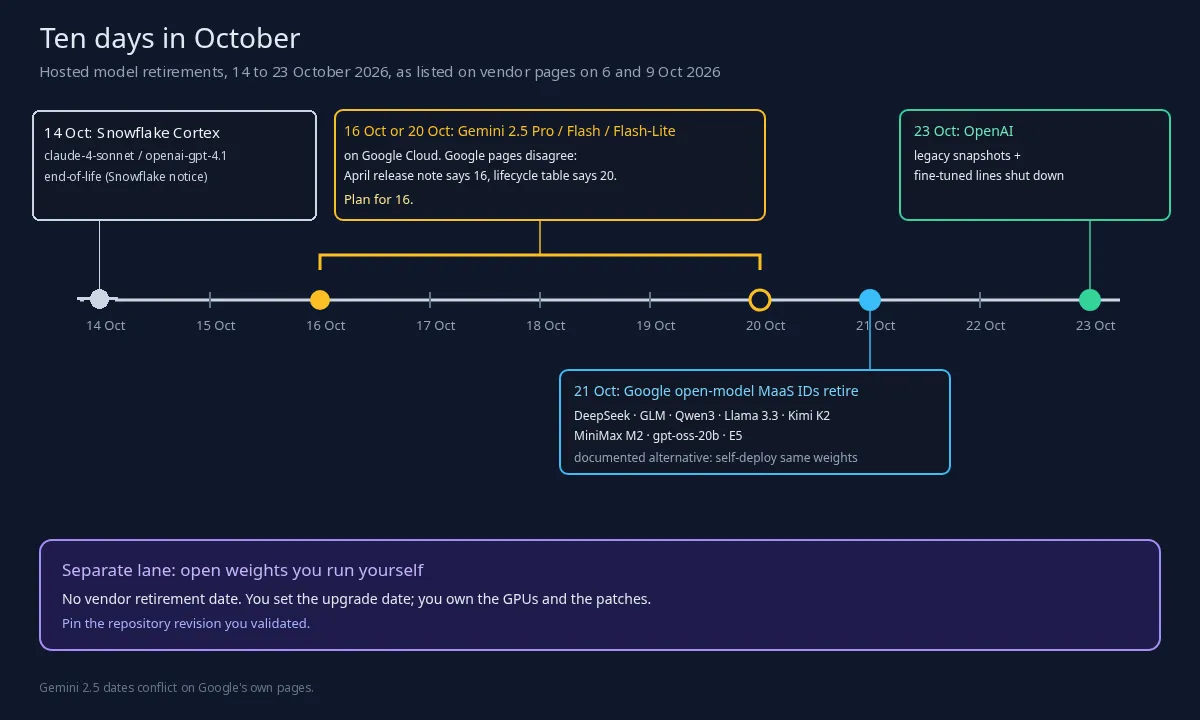
W ciągu dziesięciu dni października 2026 r. przypadają daty wycofania kilku identyfikatorów modeli hostowanych: starszych snapshotów OpenAI 23 października, identyfikatorów MaaS otwartych modeli Google 21 października, Gemini 2.5 w Google Cloud 16 lub 20 października oraz dwóch modeli Snowflake Cortex 14 października. Przypnij identyfikatory, przypisz każdemu właściciela i dowiedz się, które otwarte wagi możesz uruchomić samodzielnie.
Zacznij od kalendarza. W ciągu dziesięciu dni października 2026 r. przypadają daty wycofania kilku identyfikatorów modeli hostowanych. Strona wycofań OpenAI wymienia zestaw starszych snapshotów i linii modeli dostrajanych (fine-tuned), z datą wyłączenia wyznaczoną na 23 października 2026 r. Tabela Model-as-a-Service Google dla modeli otwartych wyznacza na 21 października datę wycofania identyfikatorów DeepSeek, GLM, Qwen3, Llama 3.3, Kimi K2, MiniMax M2, gpt-oss-20b i embeddingów E5, a jako alternatywę wskazuje samodzielne wdrożenie tych samych wag. Własne strony Google są sprzeczne co do Gemini 2.5 Pro, Flash i Flash-Lite: kwietniowa informacja o wydaniu podaje 16 października, a tabela cyklu życia odczytana 6 października podaje 20 października. Według własnego komunikatu Snowflake o wycofywaniu modeli datą końca eksploatacji (end-of-life) dwóch modeli Cortex, claude-4-sonnet i openai-gpt-4.1, jest 14 października 2026 r.
Teza mieści się w dwóch zdaniach. Identyfikator modelu hostowanego to zależność z datą ważności, więc powinien trafić do inwentarza z imiennie wskazanym właścicielem. Otwarte wagi uruchamiane samodzielnie nie mają daty wycofania narzuconej przez dostawcę, ale przenoszą na ciebie rytm aktualizacji, sprzęt i łatanie.
W dalszej części: kalendarz dostawca po dostawcy, co „wycofany” oznacza w praktyce, sześć nawyków przypinania identyfikatorów modeli, uczciwy bilans samodzielnego hostowania oraz ramka o modelu Kolibri firmy Aleph Alpha, wydanym 3 października z otwartymi wagami na licencji Apache 2.0. Każda podana niżej data pochodzi ze strony dostawcy; strony te ponownie sprawdzono 6 października 2026 r., a stronę Snowflake 9 października 2026 r.
OpenAI, 23 października. Sekcja strony wycofań OpenAI z datą 22 kwietnia 2026 r. wymienia te snapshoty do wyłączenia 23 października: gpt-3.5-turbo-0125, gpt-4-0613, gpt-4-turbo, gpt-4.1-nano, gpt-4o-2024-05-13, gpt-image-1, o1-2024-12-17, o1-pro-2025-03-19, o3-mini-2025-01-31, o4-mini-2025-04-16 i ft-o4-mini-2025-04-16, a także linie dostrajane na bazie gpt-3.5-turbo, gpt-4, gpt-4.1-nano, babbage-002 i davinci-002. Jako zamienniki OpenAI wskazuje rodzinę gpt-5.6-sol, gpt-5.6-terra i gpt-5.6-luna, a dla gpt-image-1 – gpt-image-2.5-sunburst lub gpt-image-2.5-flare. Kilka wierszy podaje też w osobnej kolumnie powiązane nazwy, a tabela nie mówi jasno, czy te nazwy również przestają działać. Jeśli wiersz podaje powiązane nazwy, porównaj ze stroną każdą nazwę wywoływaną przez twój kod.
Otwarte modele Google, 21 października. Tabela wycofań otwartych modeli w usłudze MaaS Google wymienia DeepSeek (OCR, R1-0528, V3.1 i V3.2), GLM (5 i 4.7), gpt-oss-20b, Kimi K2 Thinking, Llama 3.3 70B Instruct, MiniMax M2, dwa wielojęzyczne modele embeddingów E5 i cztery warianty Qwen3: łącznie 16 identyfikatorów modeli z datą wycofania 21 października. Wszystkie oznaczono jako przestarzałe 21 lipca, a każdy wiersz jako alternatywę wskazuje samodzielne wdrożenie modelu w Model Garden.
Gemini 2.5 w Google Cloud, 16 lub 20 października. Kwietniowa informacja o wydaniu wyznaczyła 16 października; tabela cyklu życia Google odczytana 6 października pokazuje 20 października. Planuj według wcześniejszej daty i sprawdź stronę cyklu życia dla swojego projektu. Szczegóły: informacja o wydaniu Vertex AI z około 2 kwietnia 2026 r. mówi, że daty wycofania Gemini 2.5 Pro, Flash-Lite i Flash „zostały zaktualizowane na 16 października 2026 r.” (tłumaczenie własne). Aktualna tabela wersji i cyklu życia modeli pokazuje 20 października dla wszystkich trzech, z zamiennikami takimi jak gemini-3.8-flash, gemini-3.5-flash, gemini-3.5-flash-lite i gemini-3.1-flash-lite. Nie znaleźliśmy późniejszej informacji, która wyjaśniałaby tę różnicę. Strona wycofań Gemini API Google nie podaje daty wyłączenia tych trzech modeli, więc termin zależy od tego, którą usługę Google wywołuje dane obciążenie.
Snowflake Cortex, 14 października. Komunikat Snowflake o wycofywaniu modeli Cortex podaje 14 października 2026 r. jako datę końca eksploatacji (end-of-life) modeli claude-4-sonnet i openai-gpt-4.1, które 12 sierpnia 2026 r. otrzymały status legacy. Po tej dacie zapytania i wywołania API odwołujące się do któregokolwiek z tych modeli kończą się błędem.
ChatGPT i Codex, 14 października. Oficjalny dziennik zmian ChatGPT i Codex OpenAI we wpisie z 14 września 2026 r. wyznacza 14 października 2026 r. jako datę wycofania GPT-5.5 z ChatGPT, ChatGPT Work i Codex we wszystkich planach, w tym Business, Enterprise i Edu. Ten sam wpis podaje, że wycofanie nie dotyczy API OpenAI, więc wywołania API do gpt-5.5 nie są nim objęte. W Codex domyślne ustawienia przestrzeni roboczych, zapisane ustawienia modelu, własne agenty, zaplanowane zadania i skrypty, które nadal wybierają gpt-5.5, potrzebują modelu zastępczego.
Kalendarz nie kończy się na październiku. Kolejne daty OpenAI, które już są na stronie, to 1 grudnia dla modeli GPT Image i 11 grudnia dla datowanych snapshotów GPT-5 i o3.
„Wycofany” brzmi jak formalność. Na produkcji oznacza błędy. Strona Google o modelach otwartych definiuje dwa etapy. W okresie wycofywania endpoint nadal działa dla istniejących obciążeń, żeby można było przeprowadzić migrację, ale nowe użycie endpointu może zostać ograniczone. W dniu wycofania endpoint zostaje wyłączony, a żądania API wywołujące wycofany identyfikator modelu kończą się błędem.
OpenAI ujmuje to krócej: po wyłączeniu model lub endpoint nie jest już dostępny. Jedna reguła z tej samej strony często zaskakuje zespoły. Inferencja na modelu dostrojonym zatrzymuje się, gdy jego model bazowy zostaje wycofany, więc model dostrojony jest trwały tylko na tyle, na ile trwała jest baza, na której go wytrenowano. Klient, który w zeszłym roku zapłacił za dostrojenie, kupił coś, co ma datę ważności modelu bazowego.
Okresy wypowiedzenia zależą od etapu. Strona OpenAI zobowiązuje się do co najmniej sześciu miesięcy dla modeli ogólnodostępnych, co najmniej trzech miesięcy dla wariantów wyspecjalizowanych i być może zaledwie około dwóch tygodni dla modeli z preview w nazwie. Google utrzymuje modele otwarte w fazie preview przez co najmniej 45 dni od wydania. Praktyczna zasada: identyfikatory preview nie powinny trafiać na krytyczną ścieżkę widoczną dla klienta, chyba że umowa przewiduje szybką migrację.
Istnieje furtka i jest ona handlowa. OpenAI podaje, że niektórzy deweloperzy mogą przez dział sprzedaży uzgodnić dedykowaną pojemność, aby zachować dostęp po dacie wyłączenia. To negocjacja, a nie ustawienie domyślne, i nie powinna być planem.
W środowisku MSP rzadko psuje się flagowa aplikacja. Psuje się zapomniany moduł streszczeń w integracji z systemem zgłoszeń, zadanie embeddingów za indeksem wyszukiwania albo model dostrojony, za który klient zapłacił w zeszłym roku. Wycofania modeli embeddingów liczą się podwójnie: nowy model embeddingów zwykle oznacza ponowne zaindeksowanie korpusu, a nie tylko zmianę nazwy w pliku konfiguracyjnym.
Wiersz inwentarza wymaga przypiętego identyfikatora, daty, testowanego zamiennika i imiennie wskazanego właściciela. Poglądowy plik YAML poniżej pokazuje strukturę; każda nazwa w nim jest symbolem zastępczym.
# model-inventory.yaml: one row per call site, reviewed monthly
- call_site: ticket-summarizer
  provider: openai
  model_id: o4-mini-2025-04-16        # listed for shutdown 2026-10-23
  replacement_under_test: gpt-5.6-terra
  owner: platform-team
  eval_set: summaries-golden-v3
  cutover_ticket: CHG-0000
- call_site: kb-search-embeddings
  provider: google-maas
  model_id: multilingual-e5-large-instruct-maas   # retires 2026-10-21
  plan: self-deploy same weights OR switch model + re-index
  owner: search-team
Przypinanie to nie produkt. To sześć nawyków, każdy z czymś, co liczy się jako dowód.
1. Na produkcji wywołuj datowane snapshoty, a nie nazwy ruchome. Nazwa ruchoma może bez twojej wiedzy zacząć wskazywać nowy model. Datowany identyfikator zmienia się tylko wtedy, gdy ty go zmienisz. Dowód: wdrożona konfiguracja pokazuje datowany identyfikator. To nie jest dowód: „używamy najnowszego”.
2. Prowadź jeden wiersz inwentarza na każde miejsce wywołania, z dostawcą, dokładnym identyfikatorem, właścicielem, datą wycofania i testowanym zamiennikiem. Przeszukaj kod, konfigurację infrastruktury i automatyzacje low-code, a nie tylko główną aplikację. Najbardziej bolesne są zwykle miejsca wywołań zbudowane poza głównym repozytorium.
3. Subskrybuj źródło prawdy. Czyli strony wycofań dostawców i e-maile, które wysyłają do właścicieli kont. Zbiorczy newsletter to wskazówka, a nie źródło. Ten artykuł to pokazuje: w sprawie Gemini 2.5 jedna strona Google przeczy innej stronie Google.
4. Przetestuj zamiennik na własnym ruchu z użyciem małego zestawu wzorcowego przed przełączeniem: format wyników, odmowy, opóźnienie i koszt na zadanie. Nigdy nie zakładaj, że „zalecany zamiennik” zachowuje się tak samo jak model, który zastępuje.
5. Przełącz się przed terminem, z oknem na powrót do poprzedniej wersji (rollback), które kończy się przed terminem. Powrót do identyfikatora, który został już wycofany, nie jest żadnym rollbackiem. Jeśli najwcześniejsza prawdopodobna data to 16 października, okno na rollback zamyka się przed 16 października.
6. Traktuj zmiany ustawień domyślnych jak wydania. Gdy dostawca zmienia model, na który wskazuje nazwa domyślna, rachunek i zachowanie mogą się zmienić bez żadnej zmiany cennika. To przypięcie identyfikatora zamienia taką sytuację w planowaną zmianę, ze zgłoszeniem, testem i właścicielem.
Najwyraźniejszy dowód w tej historii na to, że hostowany dostęp i sam model to dwie różne rzeczy, pochodzi od Google. Dla każdego modelu otwartego z datą wycofania 21 października własna tabela Google dokumentuje alternatywę: samodzielne wdrożenie tych samych wag w Model Garden. Endpoint znika, wagi nie.
Zyski są konkretne. Wagi, które pobierasz i udostępniasz samodzielnie, nie znikają dlatego, że dostawca wycofuje endpoint. Sam decydujesz, kiedy aktualizować, i możesz zachować dokładnie tę rewizję, którą zweryfikowałeś. Przypnij przetestowaną rewizję repozytorium, a nie tylko nazwę modelu, bo repozytorium modelu może się zmienić po twoim pierwszym pobraniu.
Obowiązki są równie konkretne: GPU lub zarezerwowana pojemność, stos serwujący i jego aktualizacje, monitoring, własna ewaluacja przed każdą aktualizacją oraz łatki bezpieczeństwa dla wszystkiego wokół modelu. To realny koszt operacyjny. Jego wysokość zależy od twojego obciążenia i umów, dlatego ten artykuł nie podaje kwoty.
Licencje się różnią. Niektóre modele otwarte są udostępniane na licencji Apache 2.0, inne na własnych licencjach z osobnymi warunkami dotyczącymi użycia, uznania autorstwa lub skali. Przeczytaj licencję konkretnego repozytorium, zanim klient zacznie od niego zależeć, i przechowuj jej kopię obok wiersza inwentarza.
Gdzie to pasuje w przypadku MSP? Dobrymi kandydatami są stabilne, dobrze zdefiniowane obciążenia, takie jak klasyfikacja, ekstrakcja i wyszukiwanie we własnych dokumentach klienta. Rozumowanie na poziomie modeli czołowych przy skokowym popycie często już nie. Podejście hybrydowe jest normalne: modele hostowane dla trudnych przypadków, przypięte wagi hostowane samodzielnie dla przewidywalnego rdzenia. To ogólny wzorzec, a nie rekomendacja konkretnego produktu hostingowego.
Ramka: Kolibri, otwarte wagi wydane 3 października. Aleph Alpha ogłosiła Kolibri w Heidelbergu 5 października 2026 r. w komunikacie prasowym. Model jest dostępny od 3 października i obsługuje język niemiecki i angielski. Firma podaje, że zaprojektowano go do wdrażania na infrastrukturze kontrolowanej przez klientów, z udokumentowanym pochodzeniem danych i decyzjami projektowymi. Obsługuje przepływy agentowe, generowanie wspomagane wyszukiwaniem (RAG) i natywne wywoływanie narzędzi, a według Aleph Alpha został wytrenowany tak, by wstrzymywać się od odpowiedzi, gdy dostarczone dokumenty nie zawierają dowodów.
Budowa według karty modelu na Hugging Face: model mixture-of-experts z 78 miliardami parametrów łącznie i około 3,46 miliarda aktywnych na token (komunikat zaokrągla to do około 3 miliardów). Natywny kontekst wynosi 262 144 tokeny; karta podaje, że jakość zweryfikowano do około miliona tokenów, ale dla wydajności serwowania zaleca nieprzekraczanie 262 144.
Licencja, sprawdzona na karcie 6 października, to Apache 2.0 dla wag i plików konfiguracyjnych opublikowanych w tym repozytorium. Karta mówi też, czego licencja nie obejmuje: kodu bazowego, architektury modelu, ustawień parametrów ani żadnej metody trenowania. „Otwarte wagi na licencji Apache 2.0” to trafny opis. Nazywanie całego stosu open source wykracza poza to, co twierdzi karta.
Realia sprzętowe, także według karty: wagi FP8 zajmujące około 78 GB pamięci i podane minimum w postaci dwóch A100 80 GB, dwóch H100 SXM5 albo jednego H200, B200 lub B300. Do serwowania służy pakiet aleph-alpha-inference firmy Aleph Alpha, wtyczka vLLM, lub jej obraz kontenera, a karta pokazuje API zgodne z OpenAI po uruchomieniu modelu w ten sposób. Mała liczba aktywnych parametrów obniża liczbę obliczeń na token. Nie zmniejsza pamięci: cały model nadal musi się zmieścić.
Dlaczego jest tutaj: wag hostowanych samodzielnie nie dotyczy żadna data wycofania narzucona przez dostawcę, a Kolibri to aktualny, datowany przykład tej opcji dla pracy w języku niemieckim i angielskim. Ważne są trzy elementy kontekstu. Karta podaje, że model jest przeznaczony do przepływów, w których człowiek sprawdza wynik, zanim zostanie on wykorzystany. Umowa Aleph Alpha z Cohere wciąż wymaga zgody regulatorów, a do jej sfinalizowania firma działa niezależnie. A „suwerenny” to w komunikacie Aleph Alpha słowo firmy oznaczające kontrolę klienta i swobodę wyboru. To nie jest certyfikacja i ten artykuł żadnej nie deklaruje.
Zweryfikowany kalendarz w jednym akapicie: datą wyłączenia starszych snapshotów i linii dostrajanych OpenAI jest 23 października. Datą wycofania identyfikatorów MaaS otwartych modeli Google jest 21 października, a samodzielne wdrożenie tych samych wag jest alternatywą udokumentowaną przez samo Google. Datą wycofania Gemini 2.5 Pro, Flash i Flash-Lite w Google Cloud jest 16 lub 20 października, zależnie od tego, którą stronę Google się czyta, więc planuj na 16. Datą końca eksploatacji modeli claude-4-sonnet i openai-gpt-4.1 w Snowflake Cortex jest 14 października.
Zasada operacyjna nie zmienia się wraz z dostawcą. Identyfikator modelu hostowanego to zależność z datą ważności: przypnij go, wpisz do inwentarza, przypisz mu właściciela i przetestuj zamiennik na własnym ruchu przed terminem. Otwarte wagi, które uruchamiasz, nie mają daty wycofania narzuconej przez dostawcę, ale rytm aktualizacji, sprzęt i łatanie stają się twoje. Kolibri to jeden datowany przykład otwartych wag na licencji Apache 2.0, z licencją, którą karta modelu ogranicza do wag i plików konfiguracyjnych w repozytorium.
Wszystkie cytowane tu strony dostawców ponownie przeczytano 6 października 2026 r., a komunikat Snowflake 9 października 2026 r. Jeśli dostawca przesunie datę, ten artykuł zostanie poprawiony.