





















01
Niezbędne Zawsze włączone
Wymagane do działania strony (logowanie, preferencje, bezpieczeństwo). Zawsze włączone.
1 października 2026 Cloudflare wydał modele decyzyjne Clef i Clef-flash, a Strands Labs — Strands Decider 2B, wszystkie z otwartymi wagami na licencji Apache 2.0. Oto gdzie małe, skalibrowane modele decyzyjne pasują w agentach MSP i gdzie się kończą.
1 października 2026 dwie firmy opublikowały tego samego dnia ten sam pomysł. Cloudflare wydał dwa modele decyzyjne, Clef i Clef-flash, hostowane w Workers AI i opublikowane na Hugging Face na licencji Apache 2.0. Tego samego dnia Strands Labs wydał Strands Decider 2B, model decyzyjny o dwóch miliardach parametrów, którego wagi, dane treningowe i skrypty są otwarte na licencji Apache 2.0.
Model decyzyjny nie pisze tekstu. Czyta sytuację, czyli „stan”, oraz zestaw typowanych pytań i zwraca prawdopodobieństwo dla każdej dozwolonej odpowiedzi, aby Twój kod mógł skierować zgłoszenie, zatwierdzić lub wstrzymać wywołanie narzędzia albo przekazać sprawę człowiekowi. Obaj dostawcy przedstawiają swoje wydanie jako odpowiedź na zainteresowanie modelem decyzyjnym Jev firmy Typesafe AI i obaj twierdzą, że ich modele są zgodne z jego API.
Do wszystkiego, co poniżej, stosuje się jedna rama: każda liczba dotycząca dokładności i opóźnień w tym artykule pochodzi od dostawcy. Dotyczy to mediany 209 ms podawanej przez Cloudflare dla Clef i 39 ms dla Clef-flash, a także około 115 ms, które Strands podaje dla lokalnej karty RTX 3090.
Dla MSP interesujące nie jest to, kto prowadzi w rankingu. Interesujące jest to, że małe, ustrukturyzowane, powtarzalne decyzje wewnątrz agenta mogą przejść z dużego modelu ogólnego na coś taniego, skalibrowanego i działającego na własnym sprzęcie. Ten artykuł omawia, czym jest model decyzyjny, co wydał każdy z dostawców, gdzie ten wzorzec pasuje i gdzie się kończy.
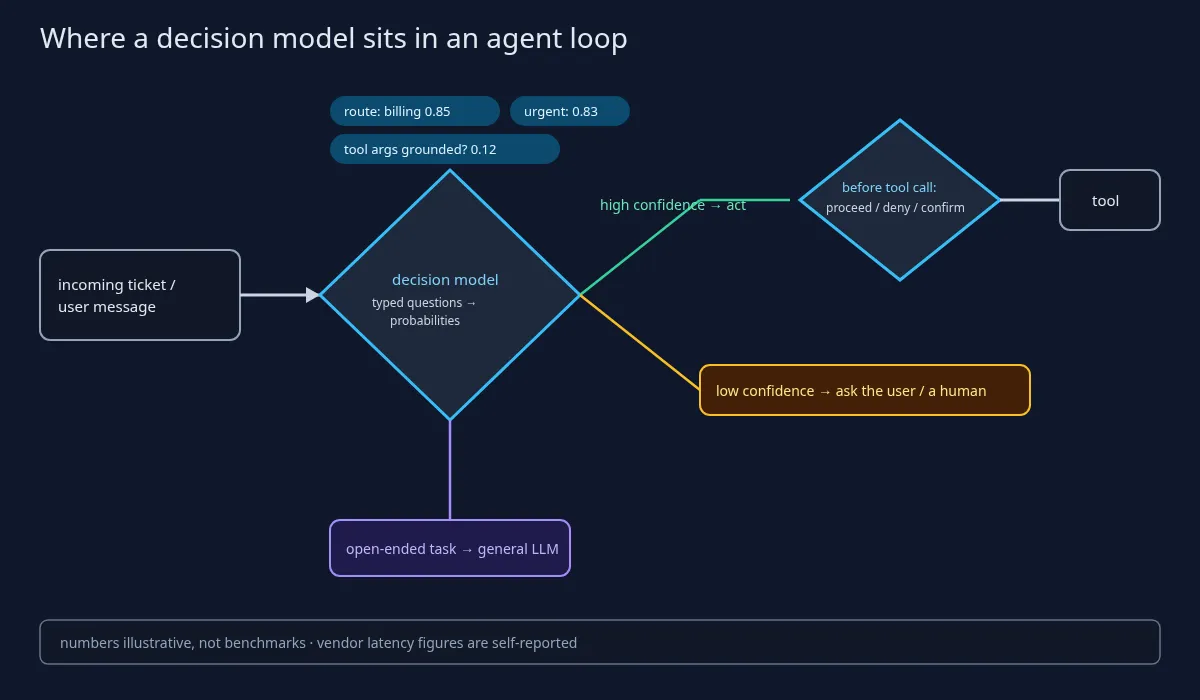
Oba wpisy opisują ten sam interfejs. Przekazujesz stan, którym może być tekst lub JSON, a w przypadku Clef także obrazy, oraz typowane pytania. Pytanie tak/nie nazywa się w obu API noul, pytanie jednokrotnego wyboru to choice, a uporządkowana skala to score. Model zwraca prawdopodobieństwo dla każdej dozwolonej opcji i zawsze odpowiada spośród podanych opcji.
Jest to przydatne z dwóch powodów. Odpowiedź z zamkniętego zbioru nie wymaga parsowania wyjścia i nie może wymyślić nowej kategorii. A prawdopodobieństwo pozwala kodowi ustawić próg: powyżej działać, poniżej zapytać człowieka. Strands podkreśla, że kilka pytań o te same dane wejściowe można tanio zadać razem, więc jedno przejście może zwrócić właściwy zespół, flagę pilności i sprawdzenie, czy dane mają oparcie w treści.
Dostawcy opisują różnicę względem modelu językowego przez sposób powstawania odpowiedzi. Decyzja zapada w jednym równoległym przejściu przez dane wejściowe, a nie token po tokenie, i stąd biorą się zapowiedzi szybkości.
Równie ważne jest to, czym model decyzyjny nie jest. Według samego Strands jego model jest znacznie słabszy od modeli rozumujących w złożonych problemach i bezużyteczny do programowania, czatu czy streszczania, bo nie potrafi generować tekstu. Jego siłą są małe, powtarzalne wybory, a nie trudne.
Klasyfikatory istnieją od lat i sceptyczny czytelnik to zauważy. Obietnica, tak jak przedstawia ją wpis Cloudflare, to jeden model, który przyjmuje nowe kategorie w momencie żądania bez ponownego trenowania: zmieniasz pytanie, a nie model.
Według wpisu Cloudflare z 1 października i jego karty na Hugging Face wydano dwa modele: Clef i Clef-flash, hostowane w Workers AI i dostępne do pobrania na licencji Apache 2.0. Karta opisuje Clef jako multimodalny model 27B, dotrenowany na bazie Qwen3.8-27B, który czyta tekst, JSON, obrazy lub wideo i odpowiada w jednym przejściu w przód, bez swobodnego generowania. Według wpisu Clef-flash zamraża szkielet Qwen3.5-9B. Oba dodają małą głowicę routingu i adaptery niskiego rzędu o rzędzie 256, trenowane z funkcjami straty kalibracji.
Cloudflare wymienia dwie rzeczy, które według firmy wyróżniają Clef: enkoder wizyjny, dzięki któremu obrazy mogą być częścią stanu, oraz okno kontekstu 64k tokenów, które zestawia z 32k w Jev.
Liczby pochodzą z własnego, wewnętrznego przebiegu pakietu Decision Index wykonanego przez Cloudflare i wszystkie podaje dostawca. Cloudflare podaje dokładność BFCL case-exact 98,47 dla Clef i 98,76 dla Clef-flash. Podaje medianę opóźnienia 209,3 ms dla Clef i 38,8 ms dla Clef-flash oraz opóźnienie p95 wynoszące odpowiednio 238,6 ms i 122,4 ms.
Te same tabele pokazują też słabszą stronę. Dane podawane przez samego Cloudflare pokazują, że Clef ustępuje Jev na trudniejszych zestawach rozumowania, takich jak GPQA Diamond, MMLU-Pro i BBH. To pasuje do wzorca: modele decyzyjne są budowane do zamkniętych wyborów, a nie do trudnego rozumowania.
Jeszcze dwa stwierdzenia dostawcy, oznaczone jako takie. W anegdocie Cloudflare podaje, że proces klasyfikacji domen trwał 2,2 sekundy z Clef wobec 4,7 sekundy z gpt-oss-120b. Jako zobowiązanie Cloudflare deklaruje, że nie czyta, nie przechowuje i nie trenuje na żądaniach ani odpowiedziach, chyba że klient zdecyduje się na usługę fine-tuningu.
Samodzielny hosting jest możliwy, ale niełatwy. Przykład referencyjny z karty testowano na pojedynczej H200; Clef to model 27B, a nie model na laptopa. Lżejsze ścieżki to Clef-flash i hostowany punkt końcowy. Cloudflare zapowiedział też usługę fine-tuningu opartą na uczeniu ze wzmocnieniem, oferowaną najpierw przez inżynierów pracujących bezpośrednio u klientów, a później w trybie samoobsługowym; wpis nie podaje cen.
Według wpisu Strands Labs z 1 października i jego karty na Hugging Face Strands Decider 2B to model decyzyjny o dwóch miliardach parametrów zbudowany na Qwen3.5-2B, w którym usunięto głowicę generowania tekstu i zastąpiono ją małą głowicą wskaźnikową, liczącą nieco ponad milion parametrów, która ocenia każdą opcję. Trzon modelu jest dostrajany za pomocą LoRA rzędu 16. Wydany checkpoint to v19, po wielu iteracjach, których historia jest w repozytorium.
Otwartość to główna wiadomość. Kod jest na GitHubie, wagi na Hugging Face, a według Strands także wszystkie dane treningowe i skrypty użyte do zbudowania modelu, na licencji Apache 2.0. Karta podaje, że ponowne trenowanie trwa około 11 godzin na jednej RTX 3090. Dla MSP, który chce dopasować model decyzyjny do własnych kategorii zgłoszeń, właśnie ta odtwarzalność jest najważniejsza.
Liczby podaje dostawca. Strands podaje medianę około 115 ms dla lokalnych decyzji na RTX 3090, a podpis wykresu mówi, że pomiar wykonano na v18, a nie na v19. Dla małych zadań na MacBooku M3 podaje około 153 ms. Karta podaje 167 poprawnie rozwiązanych z 231 publicznych zadań JevBench i oznacza ten wynik jako „self-reported”.
Strands publikuje własne ograniczenia i powinny się one znaleźć w każdej notatce wdrożeniowej. Słabym punktem są długie, wieloetapowe dokumenty. Pytania są czytane mniej uważnie niż dokumenty. Kalibrację dopasowano na krótkich zadaniach klasyfikacyjnych, dlatego karta radzi zmierzyć progi na własnym ruchu, zanim się im zaufa.
Jedna linijka operacyjna, której MSP nie może przeoczyć: według karty wbudowane polecenie strands-decider serve nasłuchuje na 127.0.0.1 i nie ma uwierzytelniania, a karta zaleca je do lokalnych eksperymentów. Nie wystawiaj go w takiej postaci we współdzielonej sieci.
Rozbudowany przykład z wpisu to kontrola przed wywołaniem narzędzia: czy argumenty narzędzia mają oparcie w tym, co użytkownik rzeczywiście powiedział, i czy nie jest za wcześnie na działanie? Strands nazywa to ilustracją, a nie rekomendacją, i tak należy to czytać.
Poniżej przykład Strands z karty modelu, uruchomiony na lokalnej maszynie. Karta zaznacza, że ponowne trenowanie daje nieco inne liczby.
pip install strands-decider

strands-decider ask StrandsAgents/strands-decider-2B-hobson-v19 \
  --state "Help! My payouts have been failing for 3 days! " \
  --choice "Which team should handle this?=billing,sales,retail" \
  --noul "Does this convey urgency?"
Obaj dostawcy wymieniają tę samą rodzinę zastosowań, a ta dobrze pasuje do operacji agentowych MSP: routing i pilność zgłoszeń, routing modeli (wysyłanie żądania do taniego albo drogiego modelu), wybór narzędzia, kontrole przed wywołaniem narzędzia, klasyfikacja według polityk i segregacja alertów. To rutynowe decyzje, przy których ogólny LLM jest wolny, drogi i trudniejszy do audytu.
Strands jasno opisuje kształt hybrydowy: niech LLM podejmuje trudne decyzje, a model decyzyjny rutynowe. Obniża to koszt i opóźnienia tylko wtedy, gdy zmierzysz to na własnym obciążeniu. Nie podajemy tu żadnej liczby oszczędności, bo dla Twojego obciążenia nie istnieje ona, dopóki jej nie zmierzysz.
Kontrole wdrożeniowe, po stronie obrony, każda z dowodem:
Czego nie robić: nie pozwól, by model decyzyjny był jedyną zaporą przed nieodwracalną akcją. Połącz go z deterministyczną polityką albo z człowiekiem, tak jak robi to sam przykład Strands z akcjami proceed, deny i confirm.
Cztery rzeczy, którymi ten artykuł nie jest.
Nie jest recenzją modelu Jev firmy Typesafe. Obaj dostawcy wskazują Jev jako impuls do swoich wydań; ten artykuł go nie testował i nie cytuje żadnej liczby dotyczącej Jev poza tymi, które pojawiają się w tabelach Cloudflare.
Nie dotyczy Laminar flow-1, małego modelu, który czyta ślady działania agentów, aby znajdować błędy. To osobny temat.
Nie dotyczy Reflection Beam, dużego modelu ogólnego, zapowiedzianego, choć jego wagi wciąż nie zostały udostępnione.
Nie jest tekstem o cenach Workers AI. Wpis Cloudflare nie podaje ceny Clef ani usługi fine-tuningu, a ten artykuł żadnej nie wymyśla.
Zweryfikowane fakty: 1 października 2026 Cloudflare wydał Clef, multimodalny model decyzyjny 27B dotrenowany na bazie Qwen3.8-27B, oraz Clef-flash, w Workers AI i na Hugging Face na licencji Apache 2.0, a usługa fine-tuningu oparta na uczeniu ze wzmocnieniem ma się pojawić później. Tego samego dnia Strands Labs wydał Strands Decider 2B, zbudowany na Qwen3.5-2B z LoRA i głowicą wskaźnikową, z wagami, kodem, danymi treningowymi i skryptami na licencji Apache 2.0.
Każda liczba dotycząca dokładności i opóźnień w tym artykule pochodzi od dostawcy: podawany wynik BFCL 98,47 i mediana 209 ms dla Clef, podawana mediana 38,8 ms dla Clef-flash oraz około 115 ms na RTX 3090, które Strands podaje dla Decidera. Własne tabele Cloudflare pokazują, że Clef zostaje w tyle na trudniejszych zestawach rozumowania.
Wzorzec jest tu najważniejszy. Zamknięte, skalibrowane decyzje wewnątrz agenta mogą przejść do małych modeli o otwartych wagach, które możesz uruchomić samodzielnie, z człowiekiem lub deterministyczną polityką za każdym krokiem o niskiej pewności lub nieodwracalnym. Zanim zaufasz jakiemukolwiek progowi, zmierz go na własnym ruchu.