





















01
Necessari Sempre attivo
Indispensabili per il funzionamento del sito (login, preferenze, sicurezza). Sempre attivi.
Oggi i tecnici installano skill e server MCP negli agenti di coding e negli assistenti come un tempo installavano le estensioni del browser: in fretta, e su macchine che raggiungono i sistemi dei clienti. Una skill è fatta di istruzioni, codice e dipendenze, e l'agente seguirà le istruzioni. Per questo l'ingresso.
Oggi i tecnici installano skill e server MCP negli agenti di coding e negli assistenti come un tempo installavano le estensioni del browser: in fretta, e su macchine che raggiungono i sistemi dei clienti. Una skill è fatta di istruzioni, codice e dipendenze, e l'agente seguirà le istruzioni. Per questo l'ingresso delle skill è una questione di governance, non un'impostazione di comodo.
Uno strumento di riferimento, citato come riferimento e non come raccomandazione: SkillSpector di NVIDIA, repository NVIDIA/SkillSpector, licenza Apache-2.0, che il progetto descrive come scanner di sicurezza per skill di Claude Code, Codex e MCP «prima di installarle». La lettura dell'API GitHub del 6 ottobre 2026 riportava 19.494 stelle e un ultimo push alle 06:47 Europe/Rome di quella mattina. La release attuale è la v2.12.0, pubblicata il 23 settembre 2026.
Questo tutorial ha una sola regola. Di default l'exit code 0 di SkillSpector copre sia SAFE sia CAUTION, e le note di rilascio dicono chiaramente che «l'exit code 0 da solo non stabilisce un'ispezione completa». Nelle pipeline servono entrambi i cancelli, --fail-on-findings e --fail-on-incomplete.
Di seguito: cosa guarda lo scanner e cosa non fa mai, cosa è cambiato nella 2.12.0, come leggere exit code e completezza, quali contenuti escono dalla rete quando l'analisi LLM è attiva, e una policy di ingresso che un MSP può adottare questa settimana. L'articolo non contiene esempi di attacco.
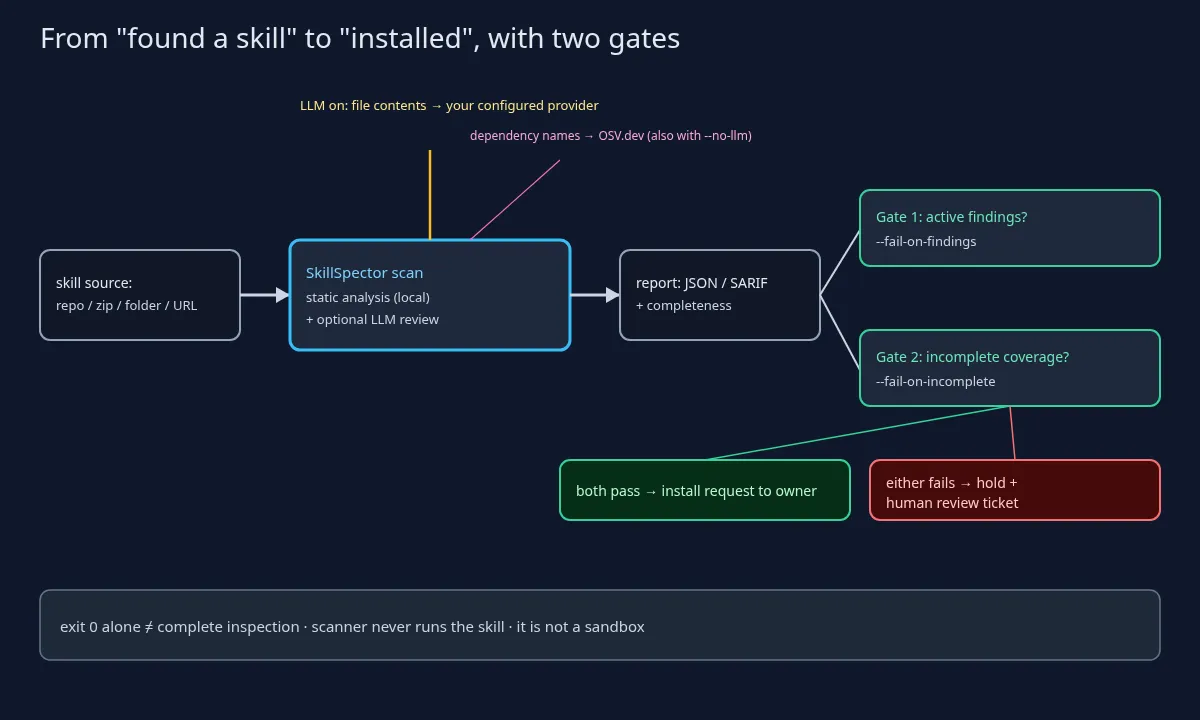
Solo da descrizione del repository e README: SkillSpector scansiona skill fornite come cartelle, singoli file, repository Git, URL o file zip. Segnala rischi in categorie che includono prompt injection, esfiltrazione di dati, escalation di privilegi, rischio di supply chain, autonomia eccessiva e tool poisoning MCP. Il progetto dichiara di coprire 71 pattern in 17 categorie. Questo articolo nomina le categorie e non spiega le tecniche.
La scansione avviene in due fasi. La prima è un'analisi statica veloce: regole a pattern, controlli sull'albero sintattico Python e firme YARA. La seconda è una revisione semantica opzionale affidata a un modello linguistico. Un controllo di supply chain confronta le dipendenze dichiarate con OSV.dev, con un elenco di riserva offline.
L'output può essere testo a terminale, JSON, Markdown o SARIF, con un punteggio di rischio da 0 a 100, una raccomandazione e un meccanismo di baseline per i finding accettati, così le nuove scansioni mostrano solo le novità.
Il modello di fiducia, con le parole del progetto: SkillSpector non esegue mai la skill scansionata e non mette l'host in una sandbox. Segnala i pattern rischiosi prima dell'installazione. Non contiene una skill che qualcuno decide di installare comunque.
I numeri di popolarità: 19.494 stelle e 1.704 fork al 6 ottobre 2026, letti dall'API GitHub. Una precedente istantanea di ricerca nel nostro lavoro indicava circa 19,3k; il quadro è lo stesso. Le stelle misurano l'attenzione, non la garanzia. La licenza è Apache-2.0, dal campo SPDX dell'API.
I fatti sulle release vengono dalla pagina pubblica delle release. L'API delle release di GitHub era limitata al momento del controllo, quindi le date vengono dal testo delle release.
v2.12.0, pubblicata il 23 settembre 2026. La release porta un report di completezza della scansione più coerente, identità e posizione nel sorgente dei finding migliorate in JSON e SARIF, e scansioni più veloci con messaggi di avanzamento sullo standard error, mentre JSON e SARIF restano puliti sullo standard output. Aggiunge un'integrazione OpenCode opzionale e il supporto alla scansione di link a sottocartelle GitHub e a file GitHub o GitLab.
Il flag per la CI è nuovo e opzionale: --fail-on-findings. Opzionale significa che le pipeline che non lo aggiungono mantengono il comportamento precedente, quindi aggiornare lo scanner da solo non rende nulla più severo.
Sono cambiati anche i tempi. Il tempo di analisi statica per artefatto passa di default da 30 a 300 secondi, sempre entro la scadenza complessiva del flusso, e una variabile d'ambiente riporta il valore a 30 secondi. Dimensiona di conseguenza i tempi della CI.
v2.11.1, 7 settembre. La scadenza complessiva di default del flusso passa da 60 a 600 secondi ed è diventata configurabile. È un tetto condiviso per tutta la scansione, non un tempo per singolo analizzatore.
L'avvertenza di aggiornamento su cui un MSP deve agire, dalle note della 2.12.0: finding, punteggi di rischio, raccomandazioni e risultati di completezza possono cambiare dopo l'aggiornamento, quindi vanno riviste le baseline esistenti. Un aggiornamento dello scanner è una modifica con un proprio ticket. Una riga di contesto dalla 2.10.0: un'analisi LLM degradata ora abbassa a CAUTION un risultato altrimenti SAFE, così il lavoro incompleto è più difficile da scambiare per un esito pulito.
Gli exit code, dal README. 0 significa che la scansione è stata completata, il punteggio di rischio è pari o inferiore a 50 (raccomandazione SAFE o CAUTION) e nessun cancello rigoroso è scattato. 1 significa punteggio di rischio sopra 50, oppure è scattato un cancello attivo: finding, copertura incompleta o soglia minima di copertura. 2 significa errore, per esempio input non valido, sorgente illeggibile o guasto interno.
La trappola sta in una frase: di default l'exit code unisce SAFE e CAUTION nello 0, quindi una pipeline che controlla solo «è uscito con 0?» lascia passare una skill che lo scanner stesso ha marcato CAUTION.
La correzione, con le parole del progetto nelle note della 2.12.0: combinare --fail-on-findings con --fail-on-incomplete quando la CI deve rifiutare sia i finding attivi sia la copertura incompleta. Un cancello di policy che fallisce restituisce il codice 1, e il codice 2 indica un errore di input o di esecuzione. Facoltativamente si aggiunge --min-coverage con una soglia percentuale, oppure si legge il campo JSON recommendation per una policy personalizzata.
L'incompletezza capita nell'operatività normale, senza alcun attaccante: timeout rispetto alla scadenza del flusso, un fornitore LLM che fallisce o non è configurato, input non supportati, oppure esclusioni decise da chi lancia la scansione. Il README dice che qualunque esclusione applicata rende la copertura parziale e impedisce la raccomandazione SAFE.
Il codice 2 è «nessun verdetto», mai un via libera. Va registrato, poi si riprova o si scala.
Le prove che un MSP dovrebbe conservare per ogni richiesta di installazione: versione dello scanner, sorgente e revisione esatte scansionate, report SARIF o JSON, sezione di completezza e chi ha approvato. Non sono prove: «è uscito con 0» o il numero di stelle.
Segue un cancello minimo per un job CI o uno script di ingresso. Togli --no-llm solo dove la tua policy sui dati consente l'invio dei contenuti dei file al fornitore LLM configurato.
# Static-only scan: file contents stay local (dependency names still go to OSV.dev).
# Fails the job on any active finding OR on incomplete coverage.
skillspector scan ./incoming-skills/example-skill/ \
  --no-llm \
  --fail-on-findings \
  --fail-on-incomplete \
  --format sarif --output skillspector.sarif
# exit 0 = both gates passed · 1 = a gate fired or risk > 50 · 2 = no verdict (error)
Prima di tutto la custodia dei dati, dalla sezione del README sul modello di fiducia. L'analisi LLM è attiva di default e invia i contenuti dei file ammessi all'analisi al fornitore configurato, qualunque sia. --no-llm tiene i contenuti dei file in locale ed esegue solo l'analisi statica; un'analisi richiesta ma non eseguita resta visibile nei metadati di completezza.
Il secondo flusso è quello che sfugge. Il controllo di supply chain invia a OSV.dev nomi e versioni delle dipendenze dichiarate, non il contenuto dei file, e lo fa anche con --no-llm. Se la skill è codice privato di un cliente, decidi se i nomi delle sue dipendenze sono sensibili e se quella chiamata in uscita è consentita da quella rete.
La scelta del fornitore è una decisione di custodia. Il progetto supporta endpoint in hosting, locali e compatibili OpenAI. Per le skill di proprietà del cliente preferisci un fornitore locale o coperto da contratto, e scrivi la scelta nella policy di scansione.
La modalità server MCP ha un confine da conoscere, dalla 2.9.4: quando SkillSpector stesso è esposto come server MCP via HTTP, rifiuta percorsi di scansione locali scelti da chi chiama. Per le scansioni locali si usa il trasporto stdio fidato.
Il progetto dichiara anche un limite linguistico. Può non riconoscere pattern in contenuti non in inglese e non analizza il testo dentro le immagini. Per skill scritte in italiano, tedesco o francese, un esito pulito va trattato con più cautela, mantenendo una lettura umana nel processo.
Una policy di ingresso che un MSP può adottare questa settimana, scritta come controlli da difensore, con la prova valida e quella che non vale:
--fail-on-findings e --fail-on-incomplete su ogni scansione automatica; il codice 2 è un blocco. Prova: la definizione della pipeline mostra entrambi i flag.Lo scanner accorcia la lettura. Non sostituisce la decisione.
Cinque cose che questo articolo non è.
Non parla della Codex Security CLI di OpenAI, uno scanner separato e vincolato al fornitore che richiede l'accesso a Codex Security.
Non parla di DefectDojo, che aggrega i finding di molti strumenti.
Non parla di Harden-Runner, che controlla l'egress dei runner CI. Completa uno scanner di skill ma fa un lavoro diverso.
Non parla di Trivy né di Syft, che scansionano container e generano SBOM per immagini software, non per skill di agenti fatte di istruzioni.
E non è un'analisi di attacco: qui non ci sono esempi di injection, né payload, né spiegazioni passo passo di tecniche.
I fatti vivi: SkillSpector è Apache-2.0, aveva 19.494 stelle GitHub il 6 ottobre 2026 e l'ultimo push è delle 06:47 Europe/Rome di quel giorno. La release attuale è la v2.12.0, pubblicata il 23 settembre 2026, con il cancello opzionale --fail-on-findings; la 2.11.1 ha portato a 600 secondi la scadenza di default del flusso.
La regola: l'exit code 0 da solo non stabilisce un'ispezione completa. Servono cancelli su finding e su completezza con --fail-on-findings e --fail-on-incomplete, e il codice 2 è «nessun verdetto». La riga sulla custodia: l'analisi LLM invia i contenuti dei file al fornitore configurato se non si usa --no-llm, e i nomi delle dipendenze vanno comunque a OSV.dev. Il limite: i contenuti non in inglese possono sfuggire, quindi le skill in italiano meritano una lettura umana.
Questa è una storia di ingresso delle skill, non di Codex Security CLI, DefectDojo, Harden-Runner, Trivy o Syft. Pagina delle release, README e API del repository sono stati letti il 6 ottobre 2026; l'API delle release era limitata, quindi le date di rilascio vengono dal testo delle release.