





















01
Necessari Sempre attivo
Indispensabili per il funzionamento del sito (login, preferenze, sicurezza). Sempre attivi.
Runware dice che il suo prodotto Serverless è disponibile: i clienti possono eseguire codice, modelli e container propri sulle sue GPU. I 0,63 dollari per GPU-ora del titolo sono una tariffa riservata con impegno; on demand si parte da 1,60 dollari per GPU-ora su L40S.
Runware ha annunciato il 2 ottobre 2026, in un post di lancio firmato da Ryan Kerry (runware.ai/blog/runware-serverless-now-available), che il suo prodotto Serverless è disponibile. I clienti possono eseguire codice, modelli e container propri sull’infrastruttura GPU che sta dietro le sue Model API, con worker che scendono a zero quando sono inattivi. Una precisazione subito: il titolo dice «da 0,63 dollari per GPU-ora» (traduzione nostra), ma quella tariffa vale per capacità riservata su RTX PRO 6000, con tariffa e impegno concordati per ogni deployment. On demand si parte da 1,60 dollari per GPU-ora su L40S, con fatturazione al secondo su capacità condivisa.
Il post sostiene anche di offrire «calcolo a metà del costo di un neocloud» (traduzione nostra), affermazione che non documenta e che non abbiamo verificato. L’annuncio non dice dove girano i carichi di lavoro né quali condizioni di residenza dei dati si applicano. Per un provider che ospita fine-tune o modelli privati dei clienti, lo scale-to-zero può battere una GPU sempre accesa sui costi a vuoto. Ma la domanda contrattuale è la capacità, non la tariffa del titolo, perché è la stessa Runware a dire che un worker caldo non è una prenotazione.
Il resto dell’articolo spiega che cosa è stato lanciato, come funziona la fatturazione, che cosa significa capacità, le domande sulla residenza dei dati e che cosa questa notizia non è.
Tutto ciò che è in questa sezione viene dal post di Runware del 2 ottobre 2026. Il prodotto permette ai clienti di eseguire codice, modelli o container propri sul pool di GPU che serve le Model API di Runware. Runware gestisce scheduling, ciclo di vita dei worker, scalabilità, esecuzione e misurazione dei consumi; il cliente controlla codice, dipendenze e requisiti di calcolo.
Ci sono due modi per entrare: una codebase Python che Runware impacchetta e compila, oppure un container del cliente quando runtime e dipendenze devono restare fissati (il post cita il mantenimento di versioni CUDA e librerie). Il modello dei job è asincrono: si invia un job, viene pianificato sul pool di worker dell’app e si recupera il risultato. Runware non lo descrive come un endpoint sincrono a bassa latenza.
I worker hanno 1, 2, 4 o 8 GPU ciascuno, dove tipo di GPU e capacità lo consentono. Il carico deve distribuirsi da sé sulle GPU; il post dice chiaramente che scegliere quattro GPU non rende quattro volte più veloce un codice pensato per una sola GPU. Runware afferma che i suoi Sonic Pod contengono circa 1.200 GPU in un container da 20 piedi con raffreddamento a liquido, e che li costruisce in proprio per ridurre il costo di erogazione del calcolo. Non ne abbiamo ispezionato nessuno.
L’osservabilità comprende una dashboard con deployment, stato dei worker, allocazione delle GPU, profondità della coda, richieste, errori, log e costi, più SDK, CLI e API. Lo screenshot della console sulla pagina è indicato come dati simulati. La gamma di prodotti in una riga: Model API per i modelli a catalogo, Serverless per il proprio carico su una piattaforma gestita, Runware Compute per l’accesso diretto alle macchine.
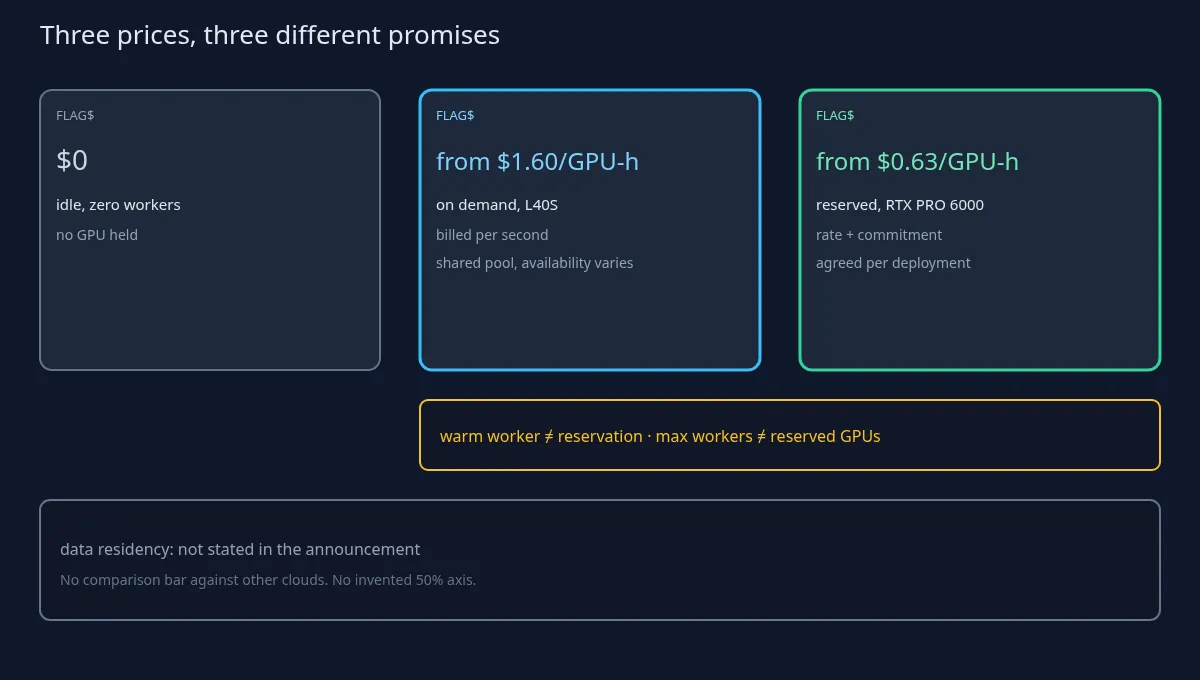
Mettete in fila i tre numeri e non mescolateli. Sono tutti e tre prezzi di listino del fornitore. 0 dollari di calcolo a riposo con zero worker. Da 1,60 dollari/GPU-ora on demand (L40S), fatturazione al secondo, nessun impegno a lungo termine, capacità condivisa. Da 0,63 dollari/GPU-ora riservati (RTX PRO 6000), tariffa e impegno concordati per deployment. «Da» indica una soglia minima su un solo tipo di GPU; le tariffe variano con l’hardware.
Il problema del titolo in una frase: il titolo della pagina e la prima riga aprono con 0,63 dollari, che è la soglia riservata. Chi legge solo il titolo stimerà un carico on demand a meno della metà della sua tariffa di partenza reale.
«Metà del costo di un neocloud» è un’affermazione del fornitore. Il post non dà una base per il confronto: quale neocloud, quale GPU, quale utilizzo, quale periodo. Non l’abbiamo verificata, e questo articolo non calcola una percentuale per conto suo.
Dettagli di fatturazione che meritano l’attenzione di un MSP, tutti dal post: l’on demand si paga dal momento in cui un worker occupa una GPU fino a quando la rilascia, compresi il caricamento del modello dopo l’allocazione e il tempo a riposo con worker caldo tra un job e l’altro. Non si pagano: l’attesa di capacità, il pull dell’immagine prima dell’allocazione e il ripristino lato Runware dopo un guasto della piattaforma. I worker multi-GPU si pagano per ogni GPU allocata. Sul throughput, il post sostiene che la tariffa oraria da sola non mostra quanto costa un carico, perché il lavoro svolto per GPU-ora varia. È vero in generale, e significa anche che nessuno di questi prezzi si può trasformare in un costo per richiesta. Il post non contiene una tabella TCO, né cifre sui risparmi dei clienti, né confronti con hyperscaler nominati.
Il punto della stessa Runware, parafrasato: tenere un worker caldo costa e non costituisce una prenotazione di capacità. I worker caldi aiutano la latenza; una prenotazione garantisce una quantità concordata di capacità GPU. Sono promesse diverse, e confonderle è il modo in cui uno SLA finisce scritto sul controllo sbagliato.
L’impostazione del numero massimo di worker, sempre dal post, limita il numero di worker e non riserva quelle GPU nel pool condiviso. Lo scale-up on demand avviene «in base alla disponibilità di GPU» (traduzione nostra), e i job aspettano in coda quando la capacità non c’è. I worker multi-GPU hanno bisogno di più GPU libere contemporaneamente e possono richiedere più tempo per essere collocati quando il pool è occupato. Il rimedio indicato dal post è riservare una capacità di base.
Avvii a freddo: Runware dice di aver realizzato ottimizzazioni di avvio e volumi persistenti per pesi e cache, e che i tempi di avvio variano comunque con dimensione del modello, runtime, disponibilità e configurazione. Non ci sono numeri pubblicati sugli avvii a freddo, e questo articolo non ne stima nessuno.
Per un MSP significa questo: se un contratto con il cliente promette un tempo di risposta, il pool on demand più un worker caldo non è, per descrizione dello stesso fornitore, una garanzia di capacità. La garanzia è la capacità di base riservata, prezzata e impegnata per deployment. È una domanda contrattuale, non una critica. Domande da mettere nell’ordine: dimensione e tipo di GPU della capacità di base riservata; che cosa succede ai job in coda quando la domanda supera la prenotazione; se il ripristino dopo un guasto della piattaforma prevede crediti di servizio (il post dice che il ripristino non viene addebitato; non parla di crediti né di SLA).
Prima la lacuna: il post di lancio non indica regioni, residenza dei dati, condizioni di trattamento dei dati, subresponsabili né tempi di conservazione di log e payload dei job. Non colmiamo nessuno di questi punti, e la descrizione dei Sonic Pod non rivela nemmeno una regione.
Perché conta per un MSP che ospita il fine-tune o il modello privato di un cliente: pesi, input dei job, output e log mostrati nella dashboard sono tutti dati del cliente o derivati da essi. Portare il proprio container mantiene il controllo del runtime; non dice di per sé dove si trovano le GPU né chi può vedere i volumi.
Domande da porre a Runware prima di mettere sopra un carico di un cliente, come domande e non come accuse: dove girano fisicamente worker e volumi persistenti; se un deployment può essere vincolato a una regione; per quanto tempo si conservano payload dei job, risultati e log; chi sono i subresponsabili; come vengono passati i segreti ai container; che cosa succede ai volumi quando un’app viene eliminata.
Trattate le chiavi API e le credenziali del registro dei modelli di questa piattaforma come qualunque altro segreto di produzione: vault, rotazione, privilegio minimo. La pagina non fa affermazioni su cloud sovrano, certificazioni o giurisdizione, e nemmeno questo articolo.
Questo non è Prime Inference, un’altra offerta di inferenza, e qui non c’è una tabella di confronto. Non è nemmeno Nebius e Inferize, un’acquisizione mirata agli avvii a freddo dentro Nebius Token Factory; quell’operazione è un’altra notizia.
Questo non è Cloudflare Web Search: è un prodotto di ricerca, non calcolo GPU. Non è il lancio di un modello né una notizia sui chip: Runware Serverless è uno strato di calcolo per i propri carichi di lavoro. Niente benchmark di modelli, niente roadmap di acceleratori.
In sintesi, gli unici prezzi che la pagina sostiene, tutti di listino del fornitore: 0 dollari di calcolo a riposo con zero worker; on demand da 1,60 dollari/GPU-ora su L40S, con fatturazione al secondo su capacità condivisa; riservato da 0,63 dollari/GPU-ora su RTX PRO 6000, con impegno concordato per deployment. «Metà del costo di un neocloud» è un’affermazione del fornitore non verificata. Le affermazioni su avvii a freddo e throughput non hanno benchmark pubblici. L’annuncio non indica la residenza dei dati.
Prima di firmare, fatevi mettere per iscritto la capacità di base riservata, il comportamento della coda oltre quella soglia e le risposte sulla residenza dei dati. Fino ad allora, nei preventivi usate la tariffa on demand, non quella del titolo.