





















01
Necessari Sempre attivo
Indispensabili per il funzionamento del sito (login, preferenze, sicurezza). Sempre attivi.
Dal 5 ottobre 2026 OpenAI permette ai clienti API di tutto il mondo di attivare la filigrana testuale su alcuni modelli (disattivata per impostazione predefinita) e nelle prossime settimane aggiungerà una filigrana invisibile, textGrain, ai testi idonei di ChatGPT e Codex nell'UE. Che cosa dimostra un rilevamento, e che cosa no.
Dal 5 ottobre 2026, scrive OpenAI, i clienti API di tutto il mondo possono attivare su richiesta la filigrana testuale su alcuni modelli (disattivata per impostazione predefinita), e nelle prossime settimane l'azienda aggiungerà una filigrana invisibile, textGrain, ai testi idonei di ChatGPT e Codex per gli utenti nell'Unione europea. Al lancio non è un'impostazione globale di ChatGPT. La fonte primaria è il post di OpenAI Our approach to EU text provenance rules; l'articolo del Centro assistenza sui segnali di provenienza indica per il testo «textGrain watermarks (EU only)».
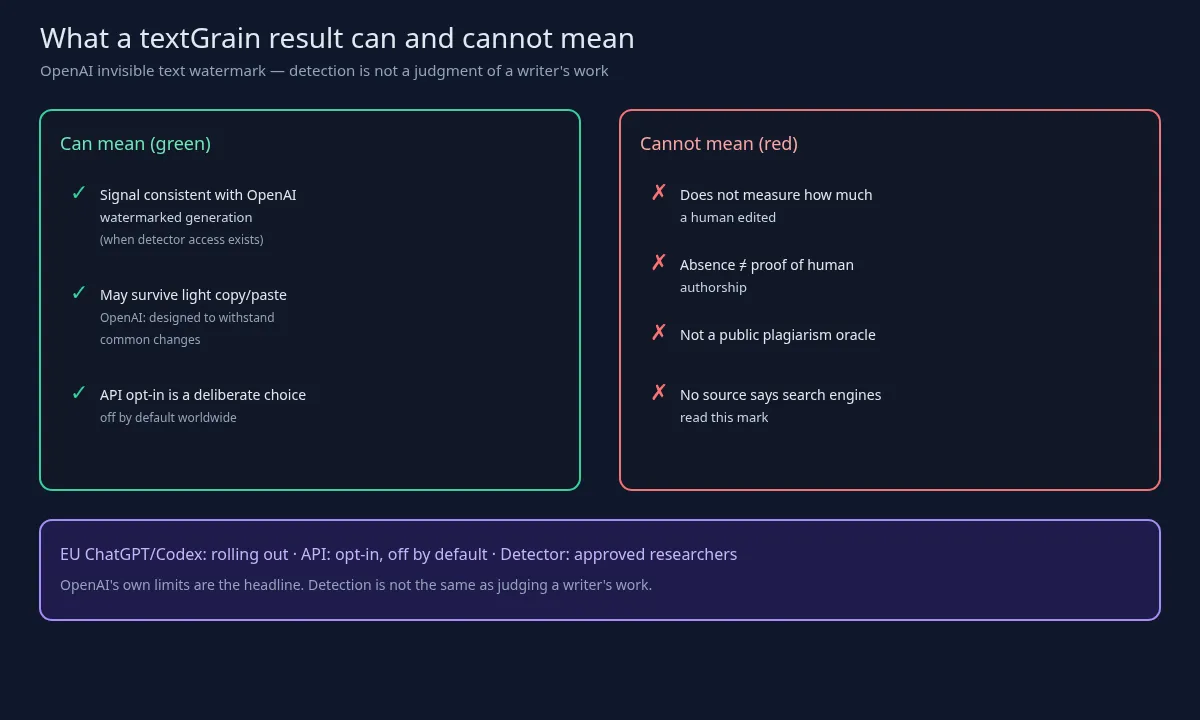
In sintesi: un risultato di rilevamento può indicare che un sistema OpenAI ha generato o elaborato parte di un passaggio. È OpenAI stessa a precisare che una filigrana non misura il contributo umano e che l'assenza del segno non prova che il testo sia stato scritto da una persona.
Questo articolo spiega a grandi linee come funziona textGrain, i tassi di rilevamento pubblicati e i limiti dopo le modifiche, chi può usare il rilevatore, una riga fattuale sull'Articolo 50 del regolamento europeo sull'IA e che cosa significa tutto questo per SEO e GEO nelle agenzie con autori in più Paesi. Non è una guida per rimuovere o aggirare una filigrana.
App nell'UE. Nelle prossime settimane, scrive OpenAI, la filigrana testuale arriverà agli utenti idonei di ChatGPT e Codex su tutti i piani, solo nell'UE. Secondo OpenAI, l'approccio regionale le permette di imparare dall'uso reale e dai riscontri degli utenti. Il Centro assistenza indica la filigrana testuale come limitata all'UE per i testi generati da ChatGPT.
API. Dal 5 ottobre 2026 i clienti API di tutto il mondo possono attivare la filigrana testuale su alcuni modelli; resta disattivata per impostazione predefinita. Secondo il Centro assistenza, l'opzione si trova nelle impostazioni dell'organizzazione (Data controls, poi Text provenance), con la possibilità di sovrascriverla per singolo progetto, e il cliente sceglie quali modelli ricevono la filigrana. Il post di OpenAI non elenca i modelli; il Centro assistenza spiega che l'elenco dei modelli idonei è visibile nelle impostazioni e che nelle prossime settimane la copertura sarà estesa ai modelli precedenti. Nominate un responsabile dell'impostazione a livello di organizzazione prima che qualcuno la attivi.
Partner cloud. OpenAI dice di lavorare con i partner cloud per rendere disponibile, nelle prossime settimane, la filigrana sugli output dei modelli OpenAI usati tramite i loro servizi. Non ha indicato quali partner.
La differenza con Anthropic. Anthropic marca il testo dei modelli Claude supportati in tutto il mondo con una versione di SynthID-Text di Google DeepMind, secondo la sintesi del materiale di supporto di Anthropic pubblicata da Search Engine Journal. OpenAI ha scelto invece un'introduzione regionale per le sue app. È una differenza di strategia di prodotto, non una classifica su quale segno sia «migliore».
Perché l'UE, e perché ora. OpenAI presenta il lavoro come risposta al regolamento europeo sull'IA, che chiede ai fornitori di IA generativa di rendere il testo generato identificabile in modo leggibile dalle macchine. Le regole di trasparenza dell'Articolo 50 si applicano dal 2 agosto 2026; secondo le indicazioni della Commissione europea riportate da Search Engine Journal, i sistemi immessi sul mercato prima di quella data hanno tempo fino al 2 dicembre per rispettare l'obbligo di marcatura e rilevamento. Questo articolo non è una lista di controllo per la conformità e non offre interpretazioni legali.
Secondo la descrizione di OpenAI, textGrain modifica in modo sottile il modo in cui il modello sceglie a caso tra le possibili parole o porzioni di parola successive, così che un rilevatore in possesso della chiave segreta possa cercare uno schema statistico. Non inserisce caratteri nascosti, spazi invisibili o punteggiatura insolita. Il rapporto tecnico datato 5 ottobre 2026 descrive una filigrana a entropia calibrata che lega la scelta dei token a una casualità derivata dalla chiave tramite trasporto ottimo su blocchi di vocabolario; al rilevatore bastano il testo generato e la chiave segreta, senza conoscere il budget di entropia usato in generazione. OpenAI dice di voler rilasciare textGrain come software open source.
I numeri sul rilevamento vengono tutti dalle valutazioni pubblicate da OpenAI. Con un obiettivo di falsi positivi dell'1 per cento, l'azienda riporta un rilevamento di circa l'80 per cento su passaggi da 200 token e di circa il 95 per cento su passaggi da 400 token per contenuti come la psicologia, con risultati nettamente inferiori sulla matematica. Sulle modifiche, OpenAI riporta che su passaggi da 400 token la sostituzione del 10 per cento delle parole con sinonimi ha ridotto il rilevamento da circa il 92 al 66 per cento, e la sostituzione del 25 per cento lo ha portato al 17 per cento.
Queste cifre sui sinonimi sono limiti di affidabilità. Descrivono come si comporta il rilevamento dopo modifiche comuni. Questo articolo non spiega come indebolire o rimuovere una filigrana.
L'accesso al rilevatore è controllato. OpenAI raccoglie candidature e per ora concede l'accesso solo a ricercatori approvati e organizzazioni esperte. Lo strumento indica se rileva una filigrana OpenAI; non identifica l'utente e non mostra prompt o conversazioni. OpenAI motiva la scelta di non renderlo pubblico al lancio con il rischio di filigrane non rilevate e di falsi positivi.
Una filigrana danneggia la SEO? Google penalizza i testi marcati?
OpenAI afferma che una filigrana non misura il contributo umano e che la sua assenza non prova che l'autore sia umano. Né il post di OpenAI sull'UE, né l'articolo del Centro assistenza, né il rapporto tecnico, né l'articolo di Search Engine Journal sostengono che i motori di ricerca leggano o valutino textGrain. Per questo l'articolo non attribuisce alla filigrana alcun effetto sul posizionamento, né penalità né vantaggi.
Il problema pratico per le agenzie: come osserva Search Engine Journal, un team con autori a Berlino e a Toronto sullo stesso piano ChatGPT potrebbe presto produrre testi marcati e non marcati con lo stesso flusso di lavoro, a seconda della regione che si applica durante l'introduzione. Il rilevamento varia anche per lingua. In un test di OpenAI sulle 24 lingue ufficiali dell'UE, con un tasso di falsi positivi dell'1 per cento, lo spagnolo ha ottenuto il tasso di rilevamento più alto (69,0 per cento) e il rumeno il più basso (42,2 per cento), prima che OpenAI rafforzasse il segnale per le lingue più deboli. OpenAI aggiunge che una parafrasi profonda o una traduzione possono rendere la filigrana non rilevabile. Policy e contratti non dovrebbero trattare il risultato di un rilevatore privato come prova di chi ha scritto una pagina. La filigrana è un segnale di provenienza per chi ha accesso al rilevatore. Non è una firma.
Che cosa scrivere invece in una policy sull'uso dell'IA: dichiarare il processo, mantenere la revisione umana dove il cliente la richiede e registrare quali strumenti hanno toccato una bozza. Niente di tutto questo richiede un punteggio di filigrana. La pagina del Centro assistenza tratta anche la provenienza di immagini, audio e video; questo articolo resta sul testo.
Sei abitudini pratiche per clienti e MSP che supportano team di autori in più Paesi.
1. Mappate le regioni. Verificate chi usa ChatGPT o Codex da account UE e chi da account non UE. Durante l'introduzione la presenza della filigrana può variare per regione, anche all'interno della stessa azienda.
2. Decidete l'attivazione via API in modo consapevole. L'impostazione predefinita è disattivata. Nominate un responsabile dell'impostazione di organizzazione o di progetto e annotate la decisione nel registro delle modifiche.
3. Non costruite test di accettazione per i clienti su un accesso al rilevatore che non avete. L'accesso per ricercatori approvati non è uno strumento di assistenza.
4. Considerate i «rilevatori di IA» di terze parti come prodotti diversi, a meno che non dimostrino di usare la chiave di OpenAI. Il Centro assistenza di OpenAI osserva che gli strumenti di terze parti di solito usano classificatori che analizzano il testo dopo la sua stesura, invece di rilevare un segnale incorporato. Un indicatore di affidabilità su una pagina promozionale non è textGrain.
5. Con i clienti in settori regolamentati, rimandate ai limiti pubblicati da OpenAI invece di promettere certezze. Le cifre sulle sostituzioni con sinonimi e il rilevamento più basso sulla matematica fanno parte di una risposta onesta.
6. Mantenete i riferimenti all'Articolo 50 brevi e fattuali. L'interpretazione legale spetta ai legali.
Un'ultima nota per i team che lavorano in più Paesi. Durante l'introduzione nell'UE, lo stesso prompt scritto da due colleghi può produrre un testo con filigrana e uno senza, a seconda di dove viene collocata la loro sessione ChatGPT o Codex. Non trasformate questa differenza in una caccia al colpevole su chi «ha usato l'IA». Trasformatela in un processo documentato: quali strumenti sono approvati, chi rivede e che cosa viene registrato prima che una pagina vada online.
I fatti principali. textGrain arriva sui testi idonei di ChatGPT e Codex nell'UE nelle prossime settimane. L'attivazione via API è disponibile in tutto il mondo dal 5 ottobre 2026 ed è disattivata per impostazione predefinita. Il rilevatore è riservato a ricercatori approvati e organizzazioni esperte. I tassi di rilevamento e le cifre sui sinonimi di OpenAI sono dati di affidabilità. Una filigrana non misura il contributo umano. Nessuna delle fonti citate dice che i motori di ricerca leggano il segno. L'Articolo 50 compare qui in una sola riga fattuale.
Fonti: OpenAI, Our approach to EU text provenance rules (5 ottobre 2026); Centro assistenza OpenAI, Provenance signals in OpenAI-generated content; OpenAI, rapporto tecnico su textGrain (5 ottobre 2026); Matt G. Southern, OpenAI To Watermark ChatGPT Text In The EU, Opens API Opt-In, Search Engine Journal (5 ottobre 2026).