





















01
Nécessaires Toujours actif
Indispensables au fonctionnement du site (session, préférences, sécurité). Toujours actifs.
Selon Runware, son produit Serverless est disponible : les clients peuvent exécuter leur propre code, leurs modèles et leurs conteneurs sur ses GPU. Les 0,63 $ par heure GPU du titre sont un tarif réservé avec engagement ; à la demande, le prix démarre à 1,60 $ par heure GPU sur L40S.
Runware a annoncé le 2 octobre 2026, dans un billet de lancement signé Ryan Kerry (runware.ai/blog/runware-serverless-now-available), que son produit Serverless est disponible. Les clients peuvent exécuter leur propre code, leurs modèles et leurs conteneurs sur l’infrastructure GPU qui fait tourner ses Model APIs, avec des workers qui redescendent à zéro au repos. Une réserve d’emblée : le titre annonce « à partir de 0,63 $ par heure GPU » (notre traduction), mais ce tarif concerne de la capacité réservée sur RTX PRO 6000, avec un tarif et un engagement convenus pour chaque déploiement. À la demande, le prix démarre à 1,60 $ par heure GPU sur L40S, facturé à la seconde sur de la capacité partagée.
Le billet affirme aussi offrir « du calcul à moitié prix par rapport à un néocloud » (notre traduction), ce qu’il ne démontre pas et que nous n’avons pas vérifié. L’annonce ne dit pas où tournent les charges de travail ni quelles conditions de résidence des données s’appliquent. Pour un fournisseur qui héberge des fine-tunes ou des modèles privés de clients, le scale-to-zero peut battre un GPU allumé en permanence sur le coût à vide. Mais la question contractuelle est la capacité, pas le tarif vedette, car Runware dit lui-même qu’un worker préchauffé n’est pas une réservation.
La suite de cet article couvre ce qui a été lancé, le fonctionnement de la facturation, ce que veut dire capacité, les questions de résidence des données et ce que cette actualité n’est pas.
Tout ce qui figure dans cette section provient du billet de Runware du 2 octobre 2026. Le produit permet aux clients d’exécuter leur propre code, leurs modèles ou leurs conteneurs sur le pool de GPU qui sert les Model APIs de Runware. Runware gère l’ordonnancement, le cycle de vie des workers, la mise à l’échelle, l’exécution et le comptage ; le client maîtrise le code, les dépendances et les besoins de calcul.
Il y a deux portes d’entrée : une base de code Python que Runware empaquette et construit, ou un conteneur du client lorsque l’environnement d’exécution et les dépendances doivent rester figés (le billet mentionne la conservation des versions CUDA et des bibliothèques). Le modèle de tâches est asynchrone : on soumet une tâche, elle est planifiée sur le pool de workers de l’application, puis on récupère le résultat. Runware ne le décrit pas comme un point de terminaison synchrone à faible latence.
Les workers comptent 1, 2, 4 ou 8 GPU, lorsque le type de GPU et la capacité le permettent. La charge de travail doit se répartir elle-même sur les GPU ; le billet dit clairement que choisir quatre GPU ne rend pas quatre fois plus rapide un code conçu pour un seul GPU. Selon Runware, ses Sonic Pods réunissent environ 1 200 GPU dans un conteneur de 20 pieds refroidi par liquide, et l’entreprise les construit elle-même pour réduire son coût de fourniture du calcul. Nous n’en avons inspecté aucun.
L’observabilité comprend un tableau de bord avec les déploiements, l’état des workers, l’allocation des GPU, la profondeur de la file d’attente, les requêtes, les erreurs, les journaux et les coûts, plus un SDK, une CLI et une API. La capture de la console sur la page est signalée comme montrant des données simulées. La gamme en une ligne : Model APIs pour les modèles du catalogue, Serverless pour votre propre charge sur une plateforme gérée, Runware Compute pour un accès direct aux machines.
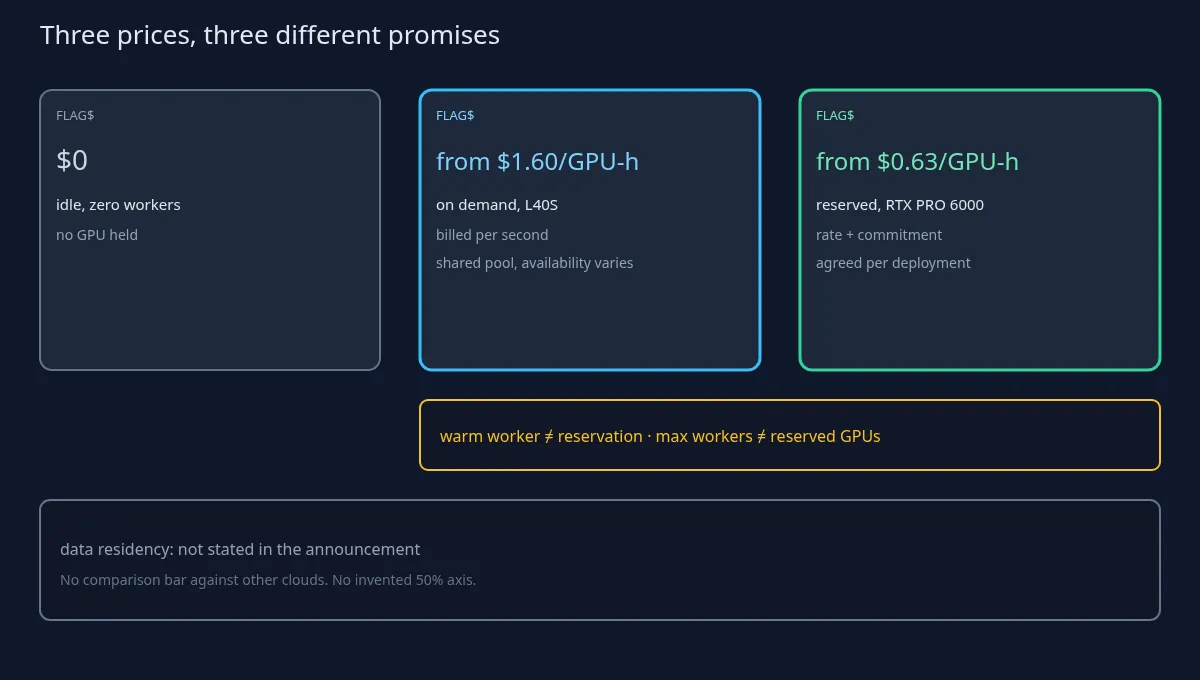
Alignez les trois chiffres et ne les mélangez pas. Tous trois sont des prix catalogue du fournisseur. 0 $ de calcul au repos avec zéro worker. À partir de 1,60 $/heure GPU à la demande (L40S), facturation à la seconde, sans engagement de longue durée, capacité partagée. À partir de 0,63 $/heure GPU en réservé (RTX PRO 6000), tarif et engagement convenus par déploiement. « À partir de » désigne un plancher pour un type de GPU ; les tarifs varient selon le matériel.
Le problème du titre en une phrase : le titre de la page et sa première ligne mettent en avant 0,63 $, qui est le plancher en réservé. Un lecteur qui ne voit que le titre chiffrera une charge à la demande à moins de la moitié de son tarif de départ réel.
« À moitié prix par rapport à un néocloud » est une affirmation du fournisseur. Le billet ne donne aucune base de comparaison : quel néocloud, quel GPU, quel taux d’utilisation, quelle période. Nous ne l’avons pas vérifiée, et cet article ne calcule pas de pourcentage de son côté.
Détails de facturation qui méritent l’attention d’un MSP, tous tirés du billet : à la demande, la facturation court du moment où un worker détient un GPU jusqu’à ce qu’il le libère, y compris le chargement du modèle après l’allocation et le temps de repos préchauffé entre les tâches. Ne sont pas facturés : l’attente de capacité, le téléchargement de l’image avant l’allocation et la reprise côté Runware après une panne de la plateforme. Les workers multi-GPU sont facturés pour chaque GPU alloué. Sur le débit, le billet fait valoir que le tarif horaire seul ne montre pas ce que coûte une charge, car le travail accompli par heure GPU varie. C’est vrai en général, et cela signifie aussi qu’aucun de ces prix ne peut être converti en coût par requête. Le billet ne contient ni tableau de TCO, ni chiffre d’économies client, ni comparaison avec des hyperscalers nommés.
Le propos de Runware lui-même, paraphrasé : garder un worker préchauffé coûte de l’argent et ne constitue pas une réservation de capacité. Les workers préchauffés aident la latence ; une réservation garantit une quantité convenue de capacité GPU. Ce sont deux promesses différentes, et les confondre, c’est ainsi qu’un SLA finit rédigé sur le mauvais levier.
Le réglage du nombre maximal de workers, toujours selon le billet, plafonne le nombre de workers et ne réserve pas ces GPU dans le pool partagé. La montée en charge à la demande se fait « sous réserve de disponibilité des GPU » (notre traduction), et les tâches attendent dans la file quand la capacité manque. Les workers multi-GPU ont besoin de plusieurs GPU libres en même temps et peuvent mettre plus longtemps à être placés quand le pool est chargé. Le remède proposé par le billet est de réserver une capacité de base.
Démarrages à froid : Runware dit avoir mis au point des optimisations de démarrage et des volumes persistants pour les poids et les caches, et que les temps de démarrage varient malgré tout selon la taille du modèle, l’environnement d’exécution, la disponibilité et la configuration. Aucun chiffre de démarrage à froid n’est publié, et cet article n’en estime aucun.
Pour un MSP, cela signifie : si un contrat client promet un temps de réponse, le pool à la demande plus un worker préchauffé ne constitue pas, selon la description même du fournisseur, une garantie de capacité. La garantie, c’est la capacité de base réservée, tarifée et engagée par déploiement. C’est une question contractuelle, pas une critique. Questions pour le bon de commande : la taille et le type de GPU de la capacité de base réservée ; ce qu’il advient des tâches en file quand la demande dépasse la réservation ; et si la reprise après une panne de la plateforme donne droit à des crédits de service (le billet dit que la reprise n’est pas facturée ; il ne mentionne ni crédits ni SLA).
D’abord la lacune : le billet de lancement ne cite ni régions, ni résidence des données, ni conditions de traitement des données, ni sous-traitants, ni durée de conservation des journaux et des données des tâches. Nous ne comblons aucun de ces points, et la description des Sonic Pods ne révèle pas non plus de région.
Pourquoi c’est important pour un MSP qui héberge le fine-tune ou le modèle privé d’un client : les poids, les entrées des tâches, les sorties et les journaux affichés dans le tableau de bord sont tous des données du client ou en dérivent. Apporter son propre conteneur garde la maîtrise de l’environnement d’exécution ; cela ne dit pas à soi seul où se trouvent les GPU ni qui peut voir les volumes.
Questions à poser à Runware avant d’y placer une charge client, sous forme de questions et non d’accusations : où tournent physiquement les workers et les volumes persistants ; un déploiement peut-il être limité à une région ; combien de temps sont conservés les données des tâches, les résultats et les journaux ; qui sont les sous-traitants ; comment les secrets sont-ils transmis aux conteneurs ; que deviennent les volumes quand une application est supprimée.
Traitez les clés API et les identifiants du registre de modèles de cette plateforme comme n’importe quel autre secret de production : coffre-fort, rotation, moindre privilège. La page ne revendique ni cloud souverain, ni certification, ni juridiction, et cet article non plus.
Ce n’est pas Prime Inference, une autre offre d’inférence, et il n’y a pas de tableau comparatif ici. Ce n’est pas non plus Nebius et Inferize, une acquisition visant les démarrages à froid au sein de Nebius Token Factory ; cette opération est un autre sujet.
Ce n’est pas Cloudflare Web Search : c’est un produit de recherche, pas du calcul GPU. Ce n’est ni le lancement d’un modèle ni une actualité sur les puces : Runware Serverless est une couche de calcul pour vos propres charges. Pas de benchmarks de modèles, pas de feuilles de route d’accélérateurs.
En bref, les seuls prix que la page étaye, tous des prix catalogue du fournisseur : 0 $ de calcul au repos avec zéro worker ; à la demande à partir de 1,60 $/heure GPU sur L40S, facturé à la seconde sur capacité partagée ; en réservé à partir de 0,63 $/heure GPU sur RTX PRO 6000, avec un engagement convenu par déploiement. « À moitié prix par rapport à un néocloud » est une affirmation non vérifiée du fournisseur. Les déclarations sur les démarrages à froid et le débit ne s’appuient sur aucun benchmark public. L’annonce ne précise pas la résidence des données.
Avant de signer, obtenez par écrit la capacité de base réservée, le comportement de la file au-delà et les réponses sur la résidence des données. D’ici là, chiffrez au tarif à la demande, pas au tarif vedette.