





















01
Notwendig Immer aktiv
Erforderlich für den Betrieb der Seite (Login, Einstellungen, Sicherheit). Immer aktiv.
Runware zufolge ist sein Produkt Serverless verfügbar: Kunden können eigenen Code, eigene Modelle und Container auf seinen GPUs ausführen. Die 0,63 $ pro GPU-Stunde aus der Schlagzeile sind ein Reservierungspreis mit Commitment; On-Demand beginnt bei 1,60 $ pro GPU-Stunde auf L40S.
Runware hat am 2. Oktober 2026 in einem Launch-Beitrag von Ryan Kerry (runware.ai/blog/runware-serverless-now-available) bekannt gegeben, dass sein Produkt Serverless verfügbar ist. Kunden können eigenen Code, eigene Modelle und Container auf der GPU-Infrastruktur hinter den Model APIs des Anbieters ausführen, mit Workern, die im Leerlauf auf null skalieren. Eine Einschränkung vorweg: Die Schlagzeile lautet „ab 0,63 $ pro GPU-Stunde“ (unsere Übersetzung), doch dieser Preis gilt für reservierte Kapazität auf RTX PRO 6000, mit Preis und Commitment, die pro Deployment vereinbart werden. On-Demand beginnt bei 1,60 $ pro GPU-Stunde auf L40S, sekundengenau abgerechnet auf geteilter Kapazität.
Der Beitrag behauptet außerdem „Rechenleistung zum halben Preis einer Neocloud“ (unsere Übersetzung), belegt das aber nicht, und wir haben es nicht überprüft. Die Ankündigung sagt nicht, wo Workloads laufen oder welche Bedingungen zur Datenresidenz gelten. Für einen Anbieter, der Fine-Tunes oder private Modelle von Kunden hostet, kann Scale-to-Zero bei den Leerlaufkosten eine dauerhaft laufende GPU schlagen. Die Vertragsfrage ist aber die Kapazität, nicht der Schlagzeilenpreis, denn Runware selbst sagt, dass ein warmer Worker keine Reservierung ist.
Der Rest dieses Beitrags behandelt, was gestartet ist, wie die Abrechnung funktioniert, was Kapazität bedeutet, die Fragen zur Datenresidenz und was diese Meldung nicht ist.
Alles in diesem Abschnitt stammt aus dem Beitrag von Runware vom 2. Oktober 2026. Das Produkt erlaubt Kunden, eigenen Code, eigene Modelle oder Container auf dem GPU-Pool auszuführen, der die Model APIs von Runware bedient. Runware übernimmt Scheduling, Worker-Lebenszyklus, Skalierung, Ausführung und Verbrauchsmessung; der Kunde kontrolliert Code, Abhängigkeiten und Rechenanforderungen.
Es gibt zwei Wege hinein: eine Python-Codebasis, die Runware paketiert und baut, oder einen kundeneigenen Container, wenn Laufzeitumgebung und Abhängigkeiten fixiert werden müssen (der Beitrag nennt das Beibehalten von CUDA-Versionen und Bibliotheken). Das Job-Modell ist asynchron: Man reicht einen Job ein, er wird auf den Worker-Pool der App eingeplant, und man holt das Ergebnis ab. Runware beschreibt es nicht als synchronen Endpunkt mit niedriger Latenz.
Worker gibt es mit 1, 2, 4 oder 8 GPUs, sofern GPU-Typ und Kapazität es zulassen. Die Workload muss sich selbst auf die GPUs verteilen; der Beitrag sagt klar, dass vier GPUs Single-GPU-Code nicht viermal schneller machen. Runware zufolge fassen seine Sonic Pods etwa 1.200 GPUs in einem 20-Fuß-Container mit Flüssigkeitskühlung, und das Unternehmen baut sie selbst, um seine Kosten für die Bereitstellung von Rechenleistung zu senken. Wir haben keinen davon besichtigt.
Zur Observability gehört ein Dashboard mit Deployments, Worker-Status, GPU-Zuteilung, Warteschlangentiefe, Anfragen, Fehlern, Logs und Kosten, dazu SDK, CLI und API. Der Konsolen-Screenshot auf der Seite ist als simulierte Daten gekennzeichnet. Die Produktpalette in einer Zeile: Model APIs für Katalogmodelle, Serverless für die eigene Workload auf einer verwalteten Plattform, Runware Compute für direkten Zugriff auf Maschinen.
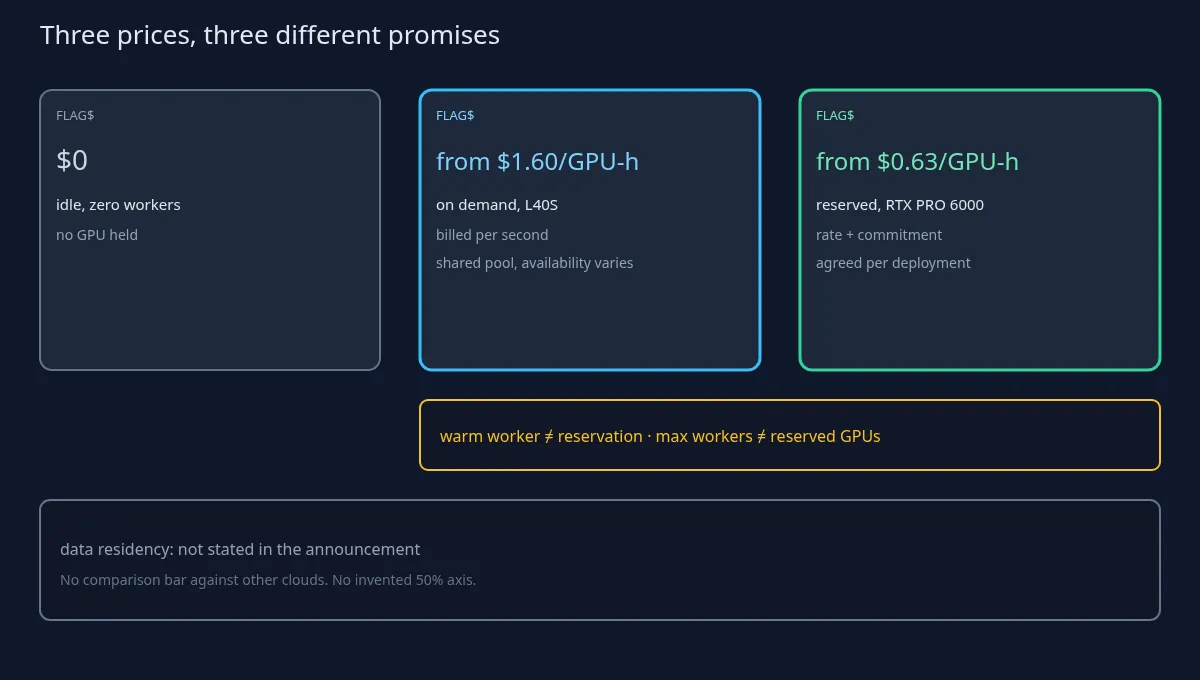
Stellen Sie die drei Zahlen nebeneinander und vermischen Sie sie nicht. Alle drei sind Listenpreise des Anbieters. 0 $ Rechenkosten im Leerlauf bei null Workern. Ab 1,60 $/GPU-Stunde On-Demand (L40S), sekundengenaue Abrechnung, keine langfristige Bindung, geteilte Kapazität. Ab 0,63 $/GPU-Stunde reserviert (RTX PRO 6000), Preis und Commitment pro Deployment vereinbart. „Ab“ bedeutet eine Untergrenze für einen GPU-Typ; die Preise variieren je nach Hardware.
Das Problem der Schlagzeile in einem Satz: Seitentitel und erste Zeile führen mit 0,63 $, also der Untergrenze für Reservierungen. Wer nur den Titel liest, kalkuliert eine On-Demand-Workload mit weniger als der Hälfte ihres tatsächlichen Einstiegspreises.
„Halber Preis einer Neocloud“ ist eine Behauptung des Anbieters. Der Beitrag nennt keine Vergleichsbasis: welche Neocloud, welche GPU, welche Auslastung, welcher Zeitraum. Wir haben sie nicht überprüft, und dieser Artikel berechnet keinen eigenen Prozentsatz.
Abrechnungsdetails, die ein MSP beachten sollte, alle aus dem Beitrag: On-Demand-Kosten laufen ab dem Moment, in dem ein Worker eine GPU belegt, bis er sie freigibt, einschließlich des Ladens des Modells nach der Zuteilung und der warmen Leerlaufzeit zwischen Jobs. Nicht berechnet werden: das Warten auf Kapazität, das Ziehen des Images vor der Zuteilung und die Wiederherstellung nach einem Plattformausfall auf Seiten von Runware. Multi-GPU-Worker werden für jede zugeteilte GPU berechnet. Zum Durchsatz argumentiert der Beitrag, dass der Stundenpreis allein nicht zeigt, was eine Workload kostet, weil die Arbeit pro GPU-Stunde variiert. Das stimmt allgemein und bedeutet auch, dass sich keiner dieser Preise in Kosten pro Anfrage umrechnen lässt. Der Beitrag enthält keine TCO-Tabelle, keine Einsparzahlen von Kunden und keinen Vergleich mit namentlich genannten Hyperscalern.
Der Punkt von Runware selbst, sinngemäß: Einen Worker warm zu halten kostet Geld und ist keine Kapazitätsreservierung. Warme Worker helfen bei der Latenz; eine Reservierung sichert eine vereinbarte Menge an GPU-Kapazität. Das sind unterschiedliche Versprechen, und wer sie vermischt, schreibt ein SLA gegen die falsche Kontrolle.
Die Einstellung für die maximale Worker-Zahl, ebenfalls laut Beitrag, begrenzt die Anzahl der Worker und reserviert diese GPUs nicht im geteilten Pool. On-Demand-Hochskalierung erfolgt „je nach GPU-Verfügbarkeit“ (unsere Übersetzung), und Jobs warten in der Warteschlange, wenn keine Kapazität da ist. Multi-GPU-Worker brauchen mehrere freie GPUs gleichzeitig und können länger brauchen, bis sie platziert sind, wenn der Pool ausgelastet ist. Die Abhilfe, die der Beitrag selbst nennt, ist das Reservieren einer Grundkapazität.
Kaltstarts: Runware sagt, es habe Startoptimierungen und persistente Volumes für Gewichte und Caches gebaut, und die Startzeiten variierten dennoch mit Modellgröße, Laufzeitumgebung, Verfügbarkeit und Konfiguration. Es gibt keine veröffentlichten Kaltstartzahlen, und dieser Artikel schätzt keine.
Für einen MSP heißt das: Wenn ein Kundenvertrag eine Antwortzeit verspricht, sind On-Demand-Pool plus warmer Worker nach der eigenen Beschreibung des Anbieters keine Kapazitätsgarantie. Die Garantie ist die reservierte Grundkapazität, bepreist und zugesagt pro Deployment. Das ist eine Vertragsfrage, keine Kritik. Fragen für das Bestellformular: Größe und GPU-Typ der reservierten Grundkapazität; was mit Jobs in der Warteschlange passiert, wenn die Nachfrage die Reservierung übersteigt; und ob die Wiederherstellung nach einem Plattformausfall mit Servicegutschriften verbunden ist (laut Beitrag wird die Wiederherstellung nicht berechnet; Gutschriften oder ein SLA erwähnt er nicht).
Zuerst die Lücke: Der Launch-Beitrag nennt keine Regionen, keine Datenresidenz, keine Bedingungen zur Datenverarbeitung, keine Unterauftragsverarbeiter und keine Aufbewahrungsfristen für Logs und Job-Payloads. Wir füllen keine dieser Lücken, und auch die Beschreibung der Sonic Pods verrät keine Region.
Warum das für einen MSP zählt, der das Fine-Tune oder private Modell eines Kunden hostet: Die Gewichte, die Job-Eingaben, die Ausgaben und die im Dashboard gezeigten Logs sind allesamt Kundendaten oder daraus abgeleitet. Ein eigener Container behält die Kontrolle über die Laufzeitumgebung; er sagt für sich genommen nicht, wo die GPUs stehen oder wer die Volumes sehen kann.
Fragen an Runware, bevor eine Kunden-Workload darauf läuft, als Fragen und nicht als Vorwürfe: Wo laufen Worker und persistente Volumes physisch; lässt sich ein Deployment an eine Region binden; wie lange werden Job-Payloads, Ergebnisse und Logs aufbewahrt; wer sind die Unterauftragsverarbeiter; wie werden Secrets an Container übergeben; was passiert mit Volumes, wenn eine App gelöscht wird.
Behandeln Sie API-Schlüssel und Zugangsdaten zur Modell-Registry dieser Plattform wie jedes andere Produktionsgeheimnis: Vault, Rotation, minimale Rechte. Die Seite erhebt keinen Anspruch auf Sovereign Cloud, Zertifizierung oder Rechtsraum, und dieser Artikel ebenso wenig.
Dies ist nicht Prime Inference, ein anderes Inferenzangebot, und hier gibt es keine Vergleichstabelle. Es ist auch nicht Nebius und Inferize, eine Übernahme, die auf Kaltstarts in Nebius Token Factory zielt; dieser Deal ist eine andere Geschichte.
Dies ist nicht Cloudflare Web Search: Das ist ein Suchprodukt, keine GPU-Rechenleistung. Dies ist weder ein Modell-Launch noch eine Chip-Meldung: Runware Serverless ist eine Rechenschicht für eigene Workloads. Keine Modell-Benchmarks, keine Beschleuniger-Roadmaps.
Kurz gesagt, die einzigen Preise, die die Seite trägt, allesamt Listenpreise des Anbieters: 0 $ Rechenkosten im Leerlauf bei null Workern; On-Demand ab 1,60 $/GPU-Stunde auf L40S, sekundengenau abgerechnet auf geteilter Kapazität; reserviert ab 0,63 $/GPU-Stunde auf RTX PRO 6000, mit pro Deployment vereinbartem Commitment. „Halber Preis einer Neocloud“ ist eine nicht überprüfte Behauptung des Anbieters. Für Aussagen zu Kaltstarts und Durchsatz gibt es keine öffentlichen Benchmarks. Die Ankündigung nennt keine Datenresidenz.
Lassen Sie sich vor der Unterschrift die reservierte Grundkapazität, das Verhalten der Warteschlange darüber hinaus und die Antworten zur Datenresidenz schriftlich geben. Bis dahin kalkulieren Sie mit dem On-Demand-Preis, nicht mit der Schlagzeile.