





















01
Nödvändiga Alltid på
Krävs för att webbplatsen ska fungera (inloggning, inställningar, säkerhet). Alltid på.
Den 1 oktober 2026 släppte Cloudflare beslutsmodellerna Clef och Clef-flash och Strands Labs släppte Strands Decider 2B, alla med öppna vikter under Apache 2.0. Här är var små, kalibrerade beslutsmodeller passar in i en MSP:s agenter, och var de tar slut.
Den 1 oktober 2026 publicerade två företag samma idé samma dag. Cloudflare släppte två beslutsmodeller, Clef och Clef-flash, som körs på Workers AI och är publicerade på Hugging Face under Apache 2.0. Samma dag släppte Strands Labs Strands Decider 2B, en beslutsmodell med två miljarder parametrar vars vikter, träningsdata och skript är öppna under Apache 2.0.
En beslutsmodell skriver ingen text. Den läser en situation, ”tillståndet”, och en uppsättning typade frågor, och returnerar en sannolikhet för varje tillåtet svar, så att din kod kan dirigera ett ärende, godkänna eller stoppa ett verktygsanrop eller lämna över till en människa. Båda leverantörerna presenterar sin release som ett svar på uppmärksamheten kring Typesafe AI:s beslutsmodell Jev, och båda säger att deras modeller är kompatibla med dess API.
En ram gäller för allt nedan: varje siffra för träffsäkerhet och latens i den här artikeln är leverantörsrapporterad. Det gäller Cloudflares rapporterade median på 209 ms för Clef och 39 ms för Clef-flash, och de ungefär 115 ms som Strands rapporterar på ett lokalt RTX 3090.
För en MSP är det intressanta inte vem som leder en topplista. Det är att de små, strukturerade, upprepade besluten inuti en agent kan flyttas från en stor generell modell till något billigt, kalibrerat och körbart på egen hårdvara. Den här artikeln går igenom vad en beslutsmodell är, vad varje leverantör släppte, var mönstret passar och var det tar slut.
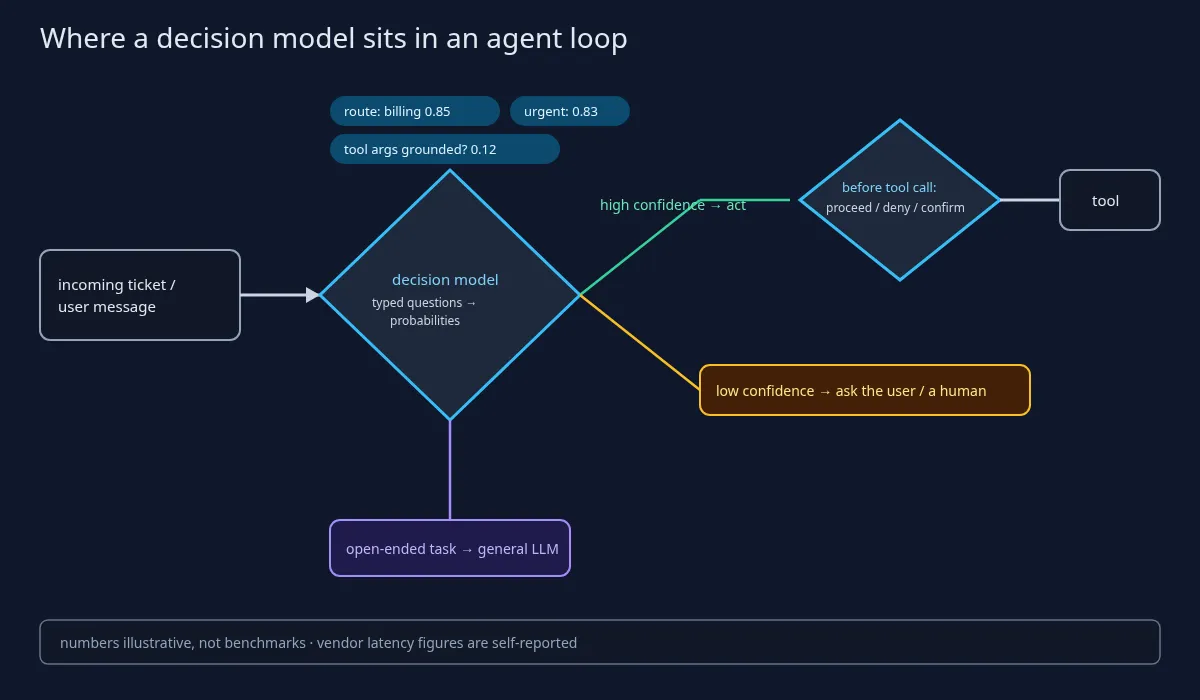
Båda inläggen beskriver samma gränssnitt. Du skickar in ett tillstånd, som kan vara text eller JSON och för Clef även bilder, plus typade frågor. En ja/nej-fråga heter noul i båda API:erna, en fråga med ett val är en choice och en ordnad skala är en score. Modellen returnerar en sannolikhet för varje tillåtet alternativ och svarar alltid utifrån de alternativ du angav.
Det är användbart av två skäl. Ett svar från en sluten mängd behöver ingen tolkning av utdata och kan inte hitta på en ny kategori. Och en sannolikhet låter koden sätta en tröskel: agera över den, fråga en människa under den. Strands betonar att flera frågor om samma indata är billiga att ställa tillsammans, så att en enda körning kan returnera ett ansvarigt team, en brådskeflagga och en kontroll av att uppgifterna har stöd.
Leverantörerna beskriver skillnaden mot en språkmodell utifrån hur svaret tas fram. Beslutet fattas i en enda parallell genomgång av indata i stället för token för token, och det är därifrån hastighetslöftena kommer.
Vad en beslutsmodell inte är spelar lika stor roll. Enligt Strands egen beskrivning är dess modell mycket svagare än resonerande modeller på komplexa problem, och oanvändbar för kodning, chatt eller sammanfattning eftersom den inte kan generera text. Dess styrka är små, upprepade val, inte svåra.
Klassificerare har funnits i åratal, och en skeptisk läsare kommer att påpeka det. Löftet, som Cloudflares inlägg formulerar det, är en enda modell som accepterar nya kategorier vid anropet utan omträning: du ändrar frågan, inte modellen.
Enligt Cloudflares inlägg den 1 oktober och dess modellkort på Hugging Face släpptes två modeller: Clef och Clef-flash, som körs på Workers AI och kan laddas ned under Apache 2.0. Kortet beskriver Clef som en multimodal 27B-modell, eftertränad från Qwen3.8-27B, som läser text, JSON, bilder eller video och svarar i en enda framåtpassning utan fri generering. Enligt inlägget fryser Clef-flash en Qwen3.5-9B-stomme. Båda lägger till ett litet dirigeringshuvud och lågrangsadaptrar med rang 256, tränade med kalibreringsförluster.
Cloudflare nämner två saker som enligt företaget skiljer Clef från andra: en bildkodare, så att bilder kan ingå i tillståndet, och ett kontextfönster på 64k token, som det ställer mot Jevs 32k.
Siffrorna kommer från Cloudflares egen interna körning av Decision Index-sviten, och alla är leverantörsrapporterade. Cloudflare rapporterar en BFCL-träffsäkerhet (case-exact) på 98,47 för Clef och 98,76 för Clef-flash. Företaget rapporterar en medianlatens på 209,3 ms för Clef och 38,8 ms för Clef-flash, med en rapporterad p95-latens på 238,6 ms respektive 122,4 ms.
Samma tabeller visar också den svagare sidan. Cloudflares egna rapporterade siffror visar att Clef ligger efter Jev på svårare resonemangsuppsättningar som GPQA Diamond, MMLU-Pro och BBH. Det stämmer med mönstret: beslutsmodeller är byggda för avgränsade val, inte för svåra resonemang.
Ytterligare två påståenden från leverantören, markerade som sådana. I en anekdot uppger Cloudflare att ett arbetsflöde för domänklassificering tog 2,2 sekunder med Clef mot 4,7 sekunder med gpt-oss-120b. Som löfte säger Cloudflare att företaget inte läser, lagrar eller tränar på förfrågningar och svar, om inte kunden väljer att använda dess finjusteringstjänst.
Egen drift är möjlig men inte lätt. Kortets referensexempel testades på ett enda H200; Clef är en 27B-modell, ingen laptopmodell. Clef-flash och den hostade slutpunkten är de lättare vägarna. Cloudflare aviserade också en finjusteringstjänst baserad på förstärkningsinlärning, som först erbjuds via företagets ingenjörer ute hos kunderna och senare som självbetjäning; inlägget publicerar inga priser.
Enligt Strands Labs inlägg den 1 oktober och dess modellkort på Hugging Face är Strands Decider 2B en beslutsmodell med två miljarder parametrar byggd på Qwen3.5-2B, där textgenereringshuvudet har tagits bort och ersatts av ett litet pekarhuvud på drygt en miljon parametrar som poängsätter varje alternativ. Stommen finjusteras med en LoRA med rang 16. Den släppta checkpointen är v19, efter många iterationer vars historik finns i repot.
Öppenheten är huvudnyheten. Koden finns på GitHub, vikterna på Hugging Face och, enligt Strands, även alla träningsdata och skript som användes för att bygga modellen, under Apache 2.0. Kortet anger att omträning tar ungefär 11 timmar på ett RTX 3090. För en MSP som vill anpassa en beslutsmodell till sina egna ärendekategorier är just den reproducerbarheten poängen.
Siffrorna är leverantörsrapporterade. Strands rapporterar en median på ungefär 115 ms för lokala beslut på ett RTX 3090, och diagramtexten säger att mätningen gjordes på v18, inte v19. Företaget rapporterar ungefär 153 ms för små uppgifter på en M3 MacBook. Kortet rapporterar 167 av 231 offentliga JevBench-uppgifter som korrekta och märker resultatet som ”self-reported”.
Strands publicerar sina egna begränsningar, och de hör hemma i varje införandeanteckning. Långa dokument i flera steg är den svaga punkten. Frågor läses mindre noggrant än dokumenten. Kalibreringen anpassades på korta klassificeringsuppgifter, så kortet rekommenderar att du mäter trösklarna på din egen trafik innan du litar på dem.
En driftrad som en MSP inte får missa: enligt kortet binder det inbyggda kommandot strands-decider serve till 127.0.0.1 och saknar autentisering, och kortet säger att det är avsett för lokala experiment. Exponera det inte som det är i ett delat nätverk.
Inläggets genomarbetade exempel är en kontroll före ett verktygsanrop: har verktygets argument stöd i vad användaren faktiskt sa, och är det för tidigt att agera? Strands kallar det en illustration snarare än en rekommendation, och så bör det läsas.
Nedan finns Strands eget exempel från modellkortet, kört på en lokal maskin. Kortet påpekar att en omträning ger något annorlunda siffror.
pip install strands-decider

strands-decider ask StrandsAgents/strands-decider-2B-hobson-v19 \
  --state "Help! My payouts have been failing for 3 days! " \
  --choice "Which team should handle this?=billing,sales,retail" \
  --noul "Does this convey urgency?"
Båda leverantörerna nämner samma familj av användningsområden, och de passar väl ihop med en MSP:s agentdrift: dirigering och brådska för ärenden, modelldirigering (att skicka en förfrågan till en billig eller en dyr modell), verktygsval, kontroller före ett verktygsanrop, policyklassificering och larmtriage. Det är rutinbesluten där en generell LLM är långsam, dyr och svårare att granska.
Strands beskriver den hybrida formen tydligt: låt LLM:en ta de svåra besluten och beslutsmodellen rutinbesluten. Det sänker kostnad och latens bara om du mäter det på din egen arbetslast. Här ges ingen besparingssiffra, eftersom det inte finns någon för din arbetslast förrän du har mätt den.
Kontroller för införandet, på försvarssidan, var och en med sitt bevis:
Vad du inte ska göra: låt inte en beslutsmodell vara den enda spärren före en oåterkallelig åtgärd. Kombinera den med en deterministisk policy eller en människa, som Strands eget exempel gör med åtgärderna proceed, deny och confirm.
Fyra saker som den här artikeln inte är.
Den är ingen recension av Typesafes Jev. Båda leverantörerna anger Jev som utlösare för sina releaser; den här artikeln har inte testat Jev och citerar inga Jev-siffror utöver dem som står i Cloudflares tabeller.
Den handlar inte om Laminar flow-1, en liten modell som läser agentspår för att hitta fel. Det är en annan nyhet.
Den handlar inte om Reflection Beam, en stor generell modell som har aviserats men vars vikter ännu inte släppts.
Den är ingen artikel om priser för Workers AI. Cloudflares inlägg publicerar inget pris för Clef eller för dess finjusteringstjänst, och den här artikeln hittar inte på något.
De verifierade fakta: den 1 oktober 2026 släppte Cloudflare Clef, en multimodal 27B-beslutsmodell eftertränad från Qwen3.8-27B, och Clef-flash, på Workers AI och på Hugging Face under Apache 2.0, med en finjusteringstjänst baserad på förstärkningsinlärning på väg. Samma dag släppte Strands Labs Strands Decider 2B, byggd på Qwen3.5-2B med en LoRA och ett pekarhuvud, med vikter, kod, träningsdata och skript under Apache 2.0.
Varje siffra för träffsäkerhet och latens i den här artikeln är leverantörsrapporterad: Clefs rapporterade BFCL-värde på 98,47 och median på 209 ms, Clef-flashs rapporterade median på 38,8 ms och siffran på ungefär 115 ms på ett RTX 3090 som Strands rapporterar för Decider. Cloudflares egna tabeller visar att Clef ligger efter på svårare resonemangsuppsättningar.
Mönstret är nyheten. Avgränsade, kalibrerade beslut inuti en agent kan flyttas till små modeller med öppna vikter som du kan köra själv, med en människa eller en deterministisk policy bakom varje steg med låg säkerhet eller som inte går att ångra. Mät på din egen trafik innan du litar på någon tröskel.