





















01
Nödvändiga Alltid på
Krävs för att webbplatsen ska fungera (inloggning, inställningar, säkerhet). Alltid på.
Under tio dagar i oktober 2026 når flera värdbaserade modell-ID:n sitt utfasningsdatum: OpenAI:s äldre snapshots den 23 oktober, Googles MaaS-ID:n för öppna modeller den 21 oktober, Gemini 2.5 på Google Cloud den 16 eller 20 oktober och två Snowflake Cortex-modeller den 14 oktober. Fäst modell-ID:n, ge vart och ett en ansvarig och ta reda på vilka öppna vikter du kan köra själv.
Börja med kalendern. Under tio dagar i oktober 2026 når flera värdbaserade modell-ID:n sitt utfasningsdatum. OpenAI:s sida för utfasningar listar ett block av äldre snapshots och finjusterade modellinjer med avstängningsdatum den 23 oktober 2026. Googles Model-as-a-Service-tabell för öppna modeller anger den 21 oktober som utfasningsdatum för ID:na för DeepSeek, GLM, Qwen3, Llama 3.3, Kimi K2, MiniMax M2, gpt-oss-20b och E5-inbäddningar, och nämner att man själv driftsätter samma vikter som alternativ. Googles egna sidor är oense om Gemini 2.5 Pro, Flash och Flash-Lite: en versionsanteckning från april säger 16 oktober, medan livscykeltabellen som lästes den 6 oktober säger 20 oktober. Snowflakes egen utfasningsavisering anger den 14 oktober 2026 som end-of-life-datum för två Cortex-modeller, claude-4-sonnet och openai-gpt-4.1.
Tesen ryms i två meningar. Ett värdbaserat modell-ID är ett beroende med ett utgångsdatum och hör därför hemma i en inventering med en namngiven ansvarig. Öppna vikter som du kör själv har inget utfasningsdatum från en leverantör, men de flyttar uppgraderingstakten, hårdvaran och patchningen till dig.
Det här följer: kalendern leverantör för leverantör, vad ”tas ur drift” betyder i praktiken, sex vanor för att fästa modell-ID:n, de ärliga avvägningarna med egen drift och en faktaruta om Aleph Alphas Kolibri, som släpptes den 3 oktober med öppna vikter under Apache 2.0. Varje datum nedan kommer från en leverantörssida; sidorna lästes om den 6 oktober 2026, Snowflakes sida den 9 oktober 2026.
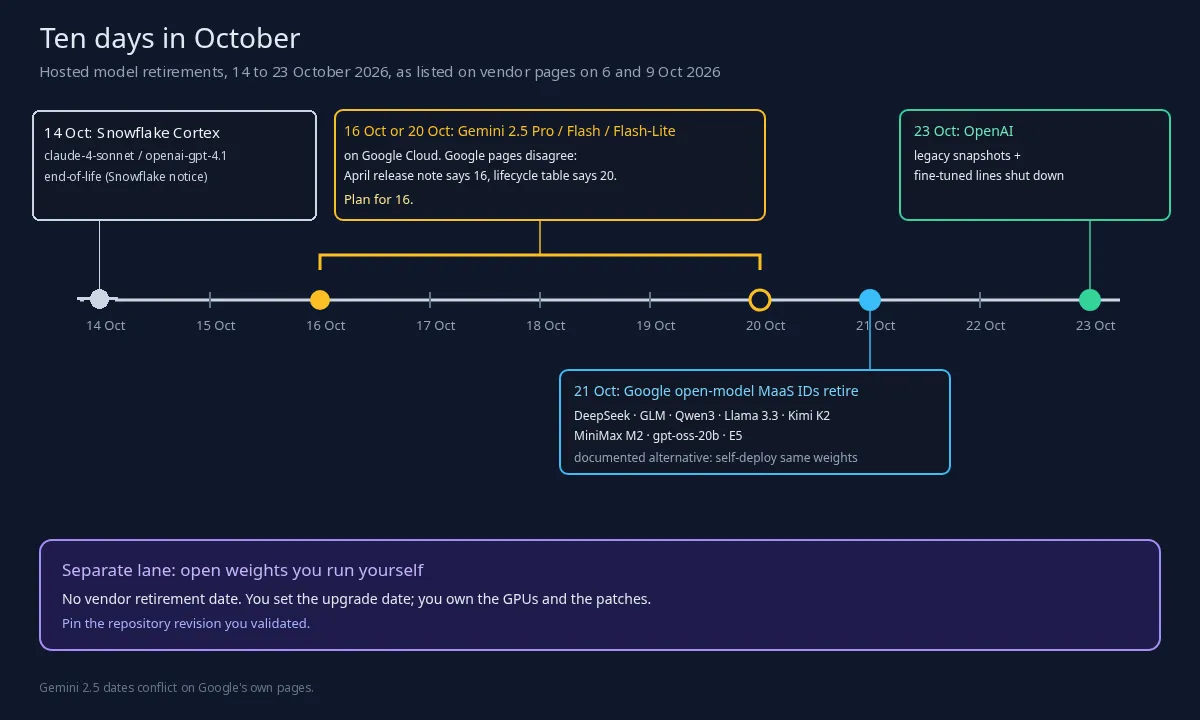
OpenAI, 23 oktober. Avsnittet på OpenAI:s sida för utfasningar daterat den 22 april 2026 listar dessa snapshots för nedstängning den 23 oktober: gpt-3.5-turbo-0125, gpt-4-0613, gpt-4-turbo, gpt-4.1-nano, gpt-4o-2024-05-13, gpt-image-1, o1-2024-12-17, o1-pro-2025-03-19, o3-mini-2025-01-31, o4-mini-2025-04-16 och ft-o4-mini-2025-04-16, samt finjusterade linjer baserade på gpt-3.5-turbo, gpt-4, gpt-4.1-nano, babbage-002 och davinci-002. Som ersättare anger OpenAI familjen gpt-5.6-sol, gpt-5.6-terra och gpt-5.6-luna, med gpt-image-2.5-sunburst eller gpt-image-2.5-flare i stället för gpt-image-1. Flera rader listar också relaterade namn i en separat kolumn, och tabellen säger inte tydligt om även de namnen slutar fungera. Om en rad listar relaterade namn ska du jämföra varje namn som din kod anropar med sidan.
Googles öppna modeller, 21 oktober. Googles tabell över utfasningar av öppna modeller i MaaS listar DeepSeek (OCR, R1-0528, V3.1 och V3.2), GLM (5 och 4.7), gpt-oss-20b, Kimi K2 Thinking, Llama 3.3 70B Instruct, MiniMax M2, två flerspråkiga E5-inbäddningsmodeller och fyra Qwen3-varianter: totalt 16 modell-ID:n med utfasningsdatum den 21 oktober. Alla förklarades föråldrade den 21 juli, och varje rad anger att man själv driftsätter modellen i Model Garden som alternativ.
Gemini 2.5 på Google Cloud, 16 eller 20 oktober. En versionsanteckning från april angav 16 oktober; Googles livscykeltabell som lästes den 6 oktober visar 20 oktober. Planera för det tidigare datumet och kontrollera livscykelsidan för ditt projekt. I detalj: en versionsanteckning för Vertex AI från omkring den 2 april 2026 säger att utfasningsdatumen för Gemini 2.5 Pro, Flash-Lite och Flash ”har uppdaterats till den 16 oktober 2026” (vår översättning). Den aktuella tabellen över modellversioner och livscykel visar 20 oktober för alla tre, med ersättare som gemini-3.8-flash, gemini-3.5-flash, gemini-3.5-flash-lite och gemini-3.1-flash-lite. Vi har inte hittat någon senare anteckning som förklarar skillnaden. Googles sida för utfasningar i Gemini API anger inget nedstängningsdatum för dessa tre modeller, så tidsgränsen beror på vilken Google-tjänst en arbetslast anropar.
Snowflake Cortex, 14 oktober. Snowflakes avisering om utfasning av Cortex-modeller anger den 14 oktober 2026 som end-of-life-datum för claude-4-sonnet och openai-gpt-4.1, som fick legacy-status den 12 augusti 2026. Efter end-of-life-datumet misslyckas frågor och API-anrop som anger någon av de två modellerna.
ChatGPT och Codex, 14 oktober. OpenAI:s officiella ändringslogg för ChatGPT och Codex anger, i en post daterad 14 september 2026, 14 oktober 2026 som det datum då GPT-5.5 tas bort ur ChatGPT, ChatGPT Work och Codex för alla abonnemang, även Business, Enterprise och Edu. Samma post säger att detta inte gäller OpenAI:s API, så API-anrop till gpt-5.5 påverkas inte. I Codex behöver standardinställningar för arbetsytor, sparade modellinställningar, egna agenter, schemalagda uppgifter och skript som fortfarande väljer gpt-5.5 en ersättningsmodell.
Kalendern tar inte slut efter oktober. Nästa OpenAI-datum som redan finns på sidan är 1 december för GPT Image-modeller och 11 december för daterade snapshots av GPT-5 och o3.
”Tas ur drift” låter administrativt. I produktion betyder det fel. Googles sida om öppna modeller definierar två steg. Under utfasningsperioden fortsätter endpointen att fungera för befintliga arbetslaster så att du kan migrera, men ny användning av endpointen kan begränsas. På utfasningsdatumet inaktiveras endpointen, och API-anrop till ett modell-ID som tagits ur drift misslyckas.
OpenAI uttrycker det kortare: vid nedstängningen är en modell eller endpoint inte längre tillgänglig. En regel på samma sida överraskar många team. Inferens på en finjusterad modell upphör när dess basmodell fasas ut, så en finjustering håller bara lika länge som basen den tränades på. Kunden som betalade för en finjustering förra året köpte något som bär basmodellens utgångsdatum.
Varseltiderna varierar med steget. OpenAI:s sida utlovar minst sex månader för allmänt tillgängliga modeller, minst tre månader för specialiserade varianter och möjligen så lite som ungefär två veckor för modeller med preview i namnet. Google håller öppna modeller i förhandsversion tillgängliga i minst 45 dagar från lansering. Den praktiska regeln: preview-ID:n hör inte hemma på en kritisk kundnära väg om inte avtalet tillåter en snabb migrering.
Det finns en nödutgång, och den är kommersiell. OpenAI skriver att vissa utvecklare kan komma överens med säljteamet om dedikerad kapacitet för fortsatt åtkomst efter ett nedstängningsdatum. Det är en förhandling, inte ett standardläge, och det bör inte vara planen.
Det som går sönder i en MSP-miljö är sällan flaggskeppsappen. Det är den bortglömda sammanfattaren i en ärendeintegration, inbäddningsjobbet bakom ett sökindex eller finjusteringen som en kund betalade för förra året. Utfasningar av inbäddningsmodeller räknas dubbelt: en ny inbäddningsmodell innebär oftast att korpusen måste indexeras om, inte bara att ett namn byts i en konfigurationsfil.
En inventeringsrad behöver ett fäst ID, datumet, en ersättare under test och en namngiven ansvarig. Den illustrativa YAML-filen nedan visar strukturen; alla namn i den är platshållare.
# model-inventory.yaml: one row per call site, reviewed monthly
- call_site: ticket-summarizer
  provider: openai
  model_id: o4-mini-2025-04-16        # listed for shutdown 2026-10-23
  replacement_under_test: gpt-5.6-terra
  owner: platform-team
  eval_set: summaries-golden-v3
  cutover_ticket: CHG-0000
- call_site: kb-search-embeddings
  provider: google-maas
  model_id: multilingual-e5-large-instruct-maas   # retires 2026-10-21
  plan: self-deploy same weights OR switch model + re-index
  owner: search-team
Att fästa ID:n är ingen produkt. Det är sex vanor, var och en med något som räknas som belägg.
1. Anropa daterade snapshots, inte flytande namn, i produktion. Ett flytande namn kan byta till en ny modell utan att du märker det. Ett daterat ID ändras bara när du ändrar det. Belägg: den driftsatta konfigurationen visar det daterade ID:t. Inte belägg: ”vi använder den senaste”.
2. Ha en inventeringsrad per anropsställe, med leverantör, exakt ID, ansvarig, utfasningsdatum och ersättaren under test. Sök i kod, infrastrukturkonfiguration och lågkodsautomationer, inte bara i huvudapplikationen. De anropsställen som gör ont är oftast de som byggts utanför huvudrepot.
3. Prenumerera på den auktoritativa källan. Det vill säga leverantörernas utfasningssidor och de kontomejl de skickar. Ett sammanställande nyhetsbrev är ett tips, inte en källa. Den här artikeln visar det: om Gemini 2.5 säger en Google-sida emot en annan Google-sida.
4. Testa ersättaren på din egen trafik med en liten referensuppsättning före bytet: utdataformat, vägranden, latens och kostnad per uppgift. Utgå aldrig från att en ”rekommenderad ersättare” beter sig likadant som modellen den ersätter.
5. Byt före datumet, med ett återställningsfönster som slutar före datumet. Att återgå till ett ID som tagits ur drift är ingen återställning. Om det tidigaste rimliga datumet är den 16 oktober stänger återställningsfönstret före den 16 oktober.
6. Behandla ändrade standardval som releaser. När en leverantör ändrar vilken modell ett standardnamn pekar på kan fakturan och beteendet förändras utan någon prisändring. Det är de fästa ID:na som gör det till en planerad ändring med ett ärende, ett test och en ansvarig.
Det tydligaste belägget i den här historien för att värdbaserad åtkomst och själva modellen är olika saker kommer från Google. För varje öppen modell med utfasningsdatum den 21 oktober dokumenterar Googles egen tabell alternativet: driftsätt samma vikter själv i Model Garden. Endpointen försvinner, vikterna gör det inte.
Det du vinner är konkret. Vikter som du laddar ner och serverar försvinner inte för att en leverantör tar en endpoint ur drift. Du väljer när du uppgraderar och kan behålla exakt den revision du har validerat. Fäst den repo-revision du testade, inte bara modellnamnet, eftersom ett modellrepo kan ändras efter din första nedladdning.
Det du tar på dig är lika konkret: GPU:er eller reserverad kapacitet, en serveringsstack och dess uppdateringar, övervakning, din egen utvärdering före varje uppgradering och säkerhetspatchning av allt runt modellen. Det är en verklig driftskostnad. Beloppet beror på din arbetslast och dina avtal, så den här artikeln anger ingen siffra.
Licenser skiljer sig åt. Vissa öppna modeller släpps under Apache 2.0, andra under egna licenser med egna villkor för användning, erkännande eller skala. Läs licensen för exakt det repot innan en kund blir beroende av det, och spara en kopia bredvid inventeringsraden.
Var passar det för en MSP? Jämna, väldefinierade arbetslaster som klassificering, extraktion och sökning i kundens egna dokument är bra kandidater. Resonerande på frontiernivå med ryckig efterfrågan är det ofta inte. En hybrid är normalt: värdbaserade modeller för de svåra fallen, fästa egendriftade vikter för den förutsägbara kärnan. Det här är ett allmänt mönster, inte en rekommendation av någon särskild hostingprodukt.
Faktaruta: Kolibri, öppna vikter släppta den 3 oktober. Aleph Alpha presenterade Kolibri från Heidelberg den 5 oktober 2026 i ett pressmeddelande. Modellen har funnits tillgänglig sedan den 3 oktober och stöder tyska och engelska. Företaget säger att den är utformad för driftsättning på infrastruktur som kunderna själva kontrollerar, med dokumenterad dataproveniens och dokumenterade designbeslut. Den stöder agentiska arbetsflöden, retrieval-augmented generation och inbyggda verktygsanrop, och enligt Aleph Alpha har den tränats att avstå från att svara när de tillhandahållna dokumenten saknar belägg.
Uppbyggnaden enligt modellkortet på Hugging Face: en mixture-of-experts-modell med totalt 78 miljarder parametrar och cirka 3,46 miljarder aktiva per token (pressmeddelandet avrundar till cirka 3 miljarder). Den inbyggda kontexten är 262 144 tokens; kortet säger att kvaliteten har validerats upp till ungefär en miljon tokens, men rekommenderar att man håller sig på högst 262 144 för effektiv servering.
Licensen, kontrollerad på kortet den 6 oktober, är Apache 2.0 för de vikter och konfigurationsfiler som publicerats i det repot. Kortet säger också vad licensen inte omfattar: underliggande kod, modellarkitektur, parameterinställningar eller någon träningsmetod. ”Öppna vikter under Apache 2.0” är den korrekta beskrivningen. Att kalla hela stacken öppen källkod går längre än vad kortet hävdar.
Hårdvaruverkligheten, också enligt kortet: FP8-vikter med ett minnesavtryck på cirka 78 GB och ett angivet minimum på två A100 80 GB, två H100 SXM5 eller en H200, B200 eller B300. Servering sker med Aleph Alphas paket aleph-alpha-inference, ett vLLM-plugin, eller företagets containeravbild, och kortet visar ett OpenAI-kompatibelt API när modellen serveras på det sättet. Få aktiva parametrar sänker beräkningen per token. De minskar inte minnesbehovet: hela modellen måste fortfarande få plats.
Varför den hör hemma här: inget utfasningsdatum från en leverantör gäller för vikter som du driftar själv, och Kolibri är ett aktuellt, daterat exempel på det alternativet för arbete på tyska och engelska. Tre saker i sammanhanget är viktiga. Kortet säger att modellen är avsedd för arbetsflöden där en människa granskar utdata innan något görs utifrån dem. Aleph Alphas avtal med Cohere är fortfarande föremål för myndighetsgodkännande, och företaget fortsätter att verka självständigt fram till slutförandet. Och ”suverän” är i Aleph Alphas pressmeddelande företagets ord för kundkontroll och valfrihet. Det är ingen certifiering, och den här artikeln gör inte anspråk på någon.
Den verifierade kalendern i ett stycke: avstängningsdatumet för OpenAI:s äldre snapshots och finjusterade linjer är den 23 oktober. Utfasningsdatumet för Googles MaaS-ID:n för öppna modeller är den 21 oktober, med egen driftsättning av samma vikter som Googles eget dokumenterade alternativ. För Gemini 2.5 Pro, Flash och Flash-Lite på Google Cloud är utfasningsdatumet den 16 eller 20 oktober beroende på vilken Google-sida du läser, så planera för den 16. Snowflakes end-of-life-datum för claude-4-sonnet och openai-gpt-4.1 i Cortex är den 14 oktober.
Driftregeln ändras inte med leverantören. Ett värdbaserat modell-ID är ett beroende med ett utgångsdatum: fäst det, inventera det, ge det en ansvarig och testa ersättaren på din egen trafik före datumet. Öppna vikter som du kör har inget utfasningsdatum från en leverantör, men uppgraderingstakten, hårdvaran och patchningen blir ditt ansvar. Kolibri är ett daterat exempel på öppna vikter under Apache 2.0, med en licens som modellkortet begränsar till vikterna och konfigurationsfilerna i repot.
Alla leverantörssidor som citeras här lästes om den 6 oktober 2026, Snowflakes avisering den 9 oktober 2026. Om en leverantör flyttar ett datum kommer den här artikeln att rättas.