





















01
Necesare Mereu activ
Indispensabile pentru funcționarea site-ului (autentificare, preferințe, securitate). Mereu active.
Pe parcursul a zece zile din octombrie 2026, mai multe ID-uri de modele găzduite ajung la data de retragere: snapshot-urile vechi OpenAI pe 23 octombrie, ID-urile MaaS ale Google pentru modele deschise pe 21 octombrie, Gemini 2.5 pe Google Cloud pe 16 sau 20 octombrie și două modele Snowflake Cortex pe 14 octombrie. Fixează ID-urile, dă fiecăruia un responsabil și află ce ponderi deschise ai putea rula singur.
Începe cu calendarul. Pe parcursul a zece zile din octombrie 2026, mai multe ID-uri de modele găzduite ajung la data de retragere. Pagina de depreciere a OpenAI listează un bloc de snapshot-uri vechi și de linii ajustate fin (fine-tuned) cu data de oprire stabilită la 23 octombrie 2026. Tabelul Model-as-a-Service al Google pentru modele deschise stabilește 21 octombrie ca dată de retragere pentru ID-urile DeepSeek, GLM, Qwen3, Llama 3.3, Kimi K2, MiniMax M2, gpt-oss-20b și ale embedding-urilor E5 și indică drept alternativă implementarea pe cont propriu a acelorași ponderi. Chiar paginile Google se contrazic în privința Gemini 2.5 Pro, Flash și Flash-Lite: o notă de lansare din aprilie spune 16 octombrie, în timp ce tabelul ciclului de viață citit pe 6 octombrie spune 20 octombrie. Anunțul de depreciere publicat chiar de Snowflake stabilește 14 octombrie 2026 ca dată de sfârșit al ciclului de viață (end-of-life) pentru două modele Cortex, claude-4-sonnet și openai-gpt-4.1.
Teza încape în două propoziții. Un ID de model găzduit este o dependență cu dată de expirare, deci trebuie să figureze într-un inventar, cu un responsabil numit explicit. Ponderile deschise pe care le rulezi singur nu au o dată de retragere impusă de furnizor, dar mută la tine ritmul actualizărilor, hardware-ul și aplicarea patch-urilor.
Ce urmează: calendarul pe furnizori, ce înseamnă „retras” în practică, șase obiceiuri pentru fixarea ID-urilor de modele, compromisurile oneste ale găzduirii proprii și o casetă despre Kolibri de la Aleph Alpha, lansat pe 3 octombrie cu ponderi deschise sub Apache 2.0. Fiecare dată de mai jos provine de pe pagina unui furnizor; aceste pagini au fost recitite pe 6 octombrie 2026, iar cea a Snowflake pe 9 octombrie 2026.
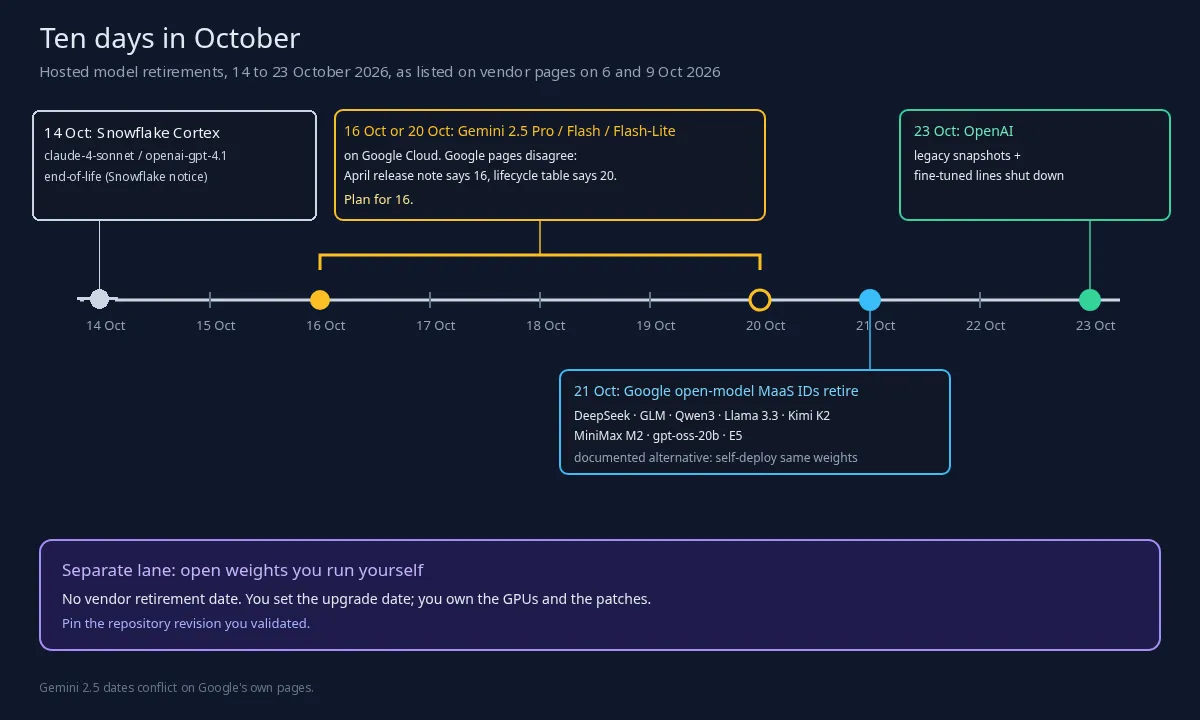
OpenAI, 23 octombrie. Secțiunea din pagina de depreciere a OpenAI datată 22 aprilie 2026 listează aceste snapshot-uri pentru oprire pe 23 octombrie: gpt-3.5-turbo-0125, gpt-4-0613, gpt-4-turbo, gpt-4.1-nano, gpt-4o-2024-05-13, gpt-image-1, o1-2024-12-17, o1-pro-2025-03-19, o3-mini-2025-01-31, o4-mini-2025-04-16 și ft-o4-mini-2025-04-16, plus linii ajustate fin pe baza gpt-3.5-turbo, gpt-4, gpt-4.1-nano, babbage-002 și davinci-002. Înlocuitorii indicați de OpenAI sunt familia gpt-5.6-sol, gpt-5.6-terra și gpt-5.6-luna, cu gpt-image-2.5-sunburst sau gpt-image-2.5-flare în locul gpt-image-1. Mai multe rânduri listează și nume înrudite într-o coloană separată, iar tabelul nu spune clar dacă și acele nume se opresc. Acolo unde un rând listează nume înrudite, verifică pe pagină fiecare nume pe care îl apelează codul tău.
Modelele deschise Google, 21 octombrie. Tabelul de depreciere MaaS al Google pentru modele deschise listează DeepSeek (OCR, R1-0528, V3.1 și V3.2), GLM (5 și 4.7), gpt-oss-20b, Kimi K2 Thinking, Llama 3.3 70B Instruct, MiniMax M2, două modele de embedding E5 multilingve și patru variante Qwen3: în total 16 ID-uri de model cu data de retragere stabilită la 21 octombrie. Toate au fost depreciate pe 21 iulie, iar fiecare rând indică drept alternativă implementarea pe cont propriu a modelului în Model Garden.
Gemini 2.5 pe Google Cloud, 16 sau 20 octombrie. O notă de lansare din aprilie a stabilit 16 octombrie; tabelul ciclului de viață al Google, citit pe 6 octombrie, arată 20 octombrie. Planifică pentru data mai apropiată și verifică pagina ciclului de viață pentru proiectul tău. În detaliu: o notă de lansare Vertex AI din jurul datei de 2 aprilie 2026 spune că datele de retragere pentru Gemini 2.5 Pro, Flash-Lite și Flash „au fost actualizate la 16 octombrie 2026” (traducerea noastră). Tabelul versiunilor și al ciclului de viață al modelelor, publicat în prezent, arată 20 octombrie pentru toate trei, cu înlocuitori precum gemini-3.8-flash, gemini-3.5-flash, gemini-3.5-flash-lite și gemini-3.1-flash-lite. Nu am găsit nicio notă ulterioară care să explice diferența. Pagina de depreciere a Gemini API de la Google nu anunță nicio dată de oprire pentru aceste trei modele, așa că termenul depinde de serviciul Google pe care îl apelează o sarcină de lucru.
Snowflake Cortex, 14 octombrie. Anunțul Snowflake privind deprecierea modelelor Cortex indică 14 octombrie 2026 ca dată de sfârșit al ciclului de viață (end-of-life) pentru claude-4-sonnet și openai-gpt-4.1, care au trecut în starea legacy pe 12 august 2026. După această dată, interogările și apelurile API care numesc oricare dintre cele două modele eșuează.
ChatGPT și Codex, 14 octombrie. Jurnalul oficial de modificări ChatGPT și Codex al OpenAI, într-o intrare datată 14 septembrie 2026, stabilește 14 octombrie 2026 ca dată la care GPT-5.5 este retras din ChatGPT, ChatGPT Work și Codex pentru toate planurile, inclusiv Business, Enterprise și Edu. Aceeași intrare precizează că retragerea nu se aplică API-ului OpenAI, deci apelurile API către gpt-5.5 nu sunt afectate. În Codex, setările implicite ale spațiilor de lucru, setările de model salvate, agenții personalizați, sarcinile programate și scripturile care încă selectează gpt-5.5 au nevoie de un model de înlocuire.
Calendarul nu se oprește după octombrie. Următoarele date OpenAI aflate deja pe pagină sunt 1 decembrie pentru modelele GPT Image și 11 decembrie pentru snapshot-urile datate ale GPT-5 și o3.
„Retras” sună administrativ. În producție înseamnă erori. Pagina Google despre modelele deschise definește două etape. În perioada de depreciere, endpoint-ul continuă să funcționeze pentru sarcinile existente, ca să poți migra, dar utilizarea nouă a endpoint-ului poate fi restricționată. La data retragerii, endpoint-ul este dezactivat, iar cererile API care apelează un ID de model retras eșuează.
Formularea OpenAI este mai scurtă: la oprire, un model sau un endpoint nu mai este accesibil. O regulă de pe aceeași pagină prinde multe echipe nepregătite. Inferența pe un model ajustat fin se oprește atunci când modelul său de bază este depreciat, așa că un model ajustat fin durează doar cât durează baza pe care a fost antrenat. Clientul care a plătit anul trecut pentru o ajustare fină a cumpărat ceva care poartă data de expirare a modelului de bază.
Perioadele de preaviz variază în funcție de etapă. Pagina OpenAI se angajează la cel puțin șase luni pentru modelele disponibile general, cel puțin trei luni pentru variantele specializate și, posibil, doar aproximativ două săptămâni pentru modelele cu preview în nume. Google păstrează modelele deschise în etapa de previzualizare disponibile cel puțin 45 de zile de la lansare. Regula practică: ID-urile preview nu au ce căuta pe o cale critică expusă clientului decât dacă contractul permite o migrare rapidă.
Există o ieșire de urgență, iar ea este comercială. OpenAI spune că unii dezvoltatori pot obține, prin echipa sa de vânzări, capacitate dedicată pentru acces continuu după data de oprire. Este o negociere, nu o setare implicită, și nu ar trebui să fie planul.
Ce se strică într-un parc MSP este rareori aplicația principală. Este rezumatorul uitat dintr-o integrare de ticketing, jobul de embedding din spatele unui index de căutare sau modelul ajustat fin pe care un client l-a plătit anul trecut. Retragerile modelelor de embedding contează dublu: un model nou de embedding înseamnă de obicei reindexarea corpusului, nu doar schimbarea unui nume într-un fișier de configurare.
Un rând de inventar are nevoie de un ID fixat, de dată, de un înlocuitor aflat în test și de un responsabil numit. Fișierul YAML ilustrativ de mai jos arată structura; fiecare nume din el este un substituent.
# model-inventory.yaml: one row per call site, reviewed monthly
- call_site: ticket-summarizer
  provider: openai
  model_id: o4-mini-2025-04-16        # listed for shutdown 2026-10-23
  replacement_under_test: gpt-5.6-terra
  owner: platform-team
  eval_set: summaries-golden-v3
  cutover_ticket: CHG-0000
- call_site: kb-search-embeddings
  provider: google-maas
  model_id: multilingual-e5-large-instruct-maas   # retires 2026-10-21
  plan: self-deploy same weights OR switch model + re-index
  owner: search-team
Fixarea nu este un produs. Sunt șase obiceiuri, fiecare cu ceva care contează drept dovadă.
1. În producție, apelează snapshot-uri datate, nu nume flotante. Un nume flotant poate trece pe un model nou fără să observi. Un ID datat se schimbă doar când îl schimbi tu. Dovadă: configurația implementată arată ID-ul datat. Nu este dovadă: „folosim ultima versiune”.
2. Ține câte un rând de inventar pentru fiecare punct de apel, cu furnizorul, ID-ul exact, responsabilul, data retragerii și înlocuitorul aflat în test. Caută în cod, în configurația infrastructurii și în automatizările low-code, nu doar în aplicația principală. Punctele de apel care dor sunt de obicei cele construite în afara depozitului principal.
3. Abonează-te la sursa oficială. Adică la paginile de depreciere ale furnizorilor și la e-mailurile de cont pe care le trimit. Un buletin informativ de tip rezumat este un indiciu, nu o sursă. Acest articol o demonstrează: în privința Gemini 2.5, o pagină Google contrazice o altă pagină Google.
4. Testează înlocuitorul pe propriul trafic, cu un mic set de referință, înainte de trecere: formatul rezultatului, refuzurile, latența și costul pe sarcină. Nu presupune niciodată că un „înlocuitor recomandat” se comportă la fel ca modelul pe care îl înlocuiește.
5. Fă trecerea înainte de dată, cu o fereastră de revenire care se încheie înainte de dată. Revenirea la un ID retras nu este o revenire. Dacă cea mai apropiată dată plauzibilă este 16 octombrie, fereastra de revenire se închide înainte de 16 octombrie.
6. Tratează schimbările de setări implicite ca pe lansări. Când un furnizor schimbă modelul spre care trimite un nume implicit, factura și comportamentul se pot schimba fără nicio modificare de preț. Fixarea este cea care transformă asta într-o schimbare planificată, cu un tichet, un test și un responsabil.
Cea mai clară dovadă din această poveste că accesul găzduit și modelul în sine sunt lucruri diferite vine de la Google. Pentru fiecare model deschis cu data de retragere stabilită la 21 octombrie, chiar tabelul Google documentează alternativa: implementează singur aceleași ponderi în Model Garden. Endpoint-ul dispare; ponderile nu.
Ce câștigi este concret. Ponderile pe care le descarci și le servești nu dispar pentru că un furnizor retrage un endpoint. Tu alegi când faci actualizarea și poți păstra exact revizia pe care ai validat-o. Fixează revizia depozitului pe care ai testat-o, nu doar numele modelului, pentru că un depozit de modele se poate schimba după prima ta descărcare.
Ce preiei este la fel de concret: GPU-uri sau capacitate rezervată, o stivă de servire și actualizările ei, monitorizare, propria evaluare înainte de fiecare actualizare și patch-urile de securitate pentru tot ce înconjoară modelul. Este un cost operațional real. Valoarea depinde de sarcinile tale de lucru și de contracte, așa că acest articol nu o cuantifică.
Licențele diferă. Unele modele deschise sunt publicate sub Apache 2.0; altele folosesc licențe proprii, cu condiții proprii privind utilizarea, atribuirea sau scara. Citește licența depozitului exact pe care îl folosești înainte ca un client să depindă de el și păstrează o copie lângă rândul de inventar.
Unde se potrivește pentru un MSP? Sarcinile stabile și bine definite, cum ar fi clasificarea, extragerea și căutarea în documentele proprii ale clientului, sunt candidați buni. Raționamentul de nivel frontier cu cerere în salturi adesea nu este. Abordarea hibridă este normală: modele găzduite pentru cazurile dificile, ponderi fixate găzduite pe cont propriu pentru nucleul previzibil. Acesta este un model general de lucru, nu o recomandare pentru vreun anumit produs de găzduire.
Casetă: Kolibri, ponderi deschise lansate pe 3 octombrie. Aleph Alpha a anunțat Kolibri din Heidelberg pe 5 octombrie 2026, într-un comunicat de presă. Modelul este disponibil din 3 octombrie și suportă germana și engleza. Compania spune că este conceput pentru implementare pe infrastructură controlată de clienți, cu proveniența datelor și deciziile de proiectare documentate. Suportă fluxuri agentice, generare augmentată prin regăsire (RAG) și apelare nativă de instrumente, iar potrivit Aleph Alpha a fost antrenat să se abțină atunci când documentele furnizate nu conțin dovezi.
Structura, conform fișei modelului de pe Hugging Face: un model mixture-of-experts cu 78 de miliarde de parametri în total și aproximativ 3,46 miliarde activi per token (comunicatul rotunjește la circa 3 miliarde). Contextul nativ este de 262.144 de tokeni; fișa spune că calitatea a fost validată până la aproximativ un milion de tokeni, dar recomandă să nu se depășească 262.144 pentru eficiența servirii.
Licența, verificată pe fișă pe 6 octombrie, este Apache 2.0 pentru ponderile și fișierele de configurare publicate în acel depozit. Fișa spune și ce nu acoperă licența: codul de bază, arhitectura modelului, setările parametrilor sau orice metodă de antrenare. „Ponderi deschise sub Apache 2.0” este descrierea corectă. A numi întreaga stivă open source depășește ceea ce afirmă fișa.
Realitatea hardware, tot conform fișei: ponderi FP8 cu o amprentă de memorie de aproximativ 78 GB și un minim indicat de două A100 de 80 GB, două H100 SXM5 sau un H200, B200 ori B300. Servirea folosește pachetul aleph-alpha-inference al Aleph Alpha, un plugin vLLM, sau imaginea sa de container, iar fișa arată un API compatibil OpenAI odată ce modelul este servit astfel. Puțini parametri activi reduc calculul per token. Nu reduc memoria: întregul model trebuie totuși să încapă.
De ce își are locul aici: nicio dată de retragere impusă de furnizor nu se aplică ponderilor pe care le găzduiești singur, iar Kolibri este un exemplu actual și datat al acestei opțiuni pentru lucrul în germană și engleză. Contează trei elemente de context. Fișa spune că modelul este destinat fluxurilor în care o persoană verifică rezultatul înainte de a se acționa pe baza lui. Acordul Aleph Alpha cu Cohere rămâne supus aprobării autorităților de reglementare, iar compania continuă să funcționeze independent până la finalizare. Iar „suveran”, în comunicatul Aleph Alpha, este cuvântul companiei pentru controlul clientului și libertatea de alegere. Nu este o certificare, iar acest articol nu revendică niciuna.
Calendarul verificat, într-un paragraf: data de oprire pentru snapshot-urile vechi și liniile ajustate fin ale OpenAI este 23 octombrie. Data de retragere pentru ID-urile MaaS ale Google pentru modele deschise este 21 octombrie, cu implementarea pe cont propriu a acelorași ponderi drept alternativă documentată chiar de Google. Pentru Gemini 2.5 Pro, Flash și Flash-Lite pe Google Cloud, data de retragere este 16 sau 20 octombrie, în funcție de pagina Google pe care o citești, așa că planifică pentru 16. În Snowflake Cortex, data de sfârșit al ciclului de viață pentru claude-4-sonnet și openai-gpt-4.1 este 14 octombrie.
Regula operațională nu se schimbă de la un furnizor la altul. Un ID de model găzduit este o dependență cu dată de expirare: fixează-l, trece-l în inventar, dă-i un responsabil și testează înlocuitorul pe propriul trafic înainte de dată. Ponderile deschise pe care le rulezi nu au o dată de retragere impusă de furnizor, dar ritmul actualizărilor, hardware-ul și patch-urile devin responsabilitatea ta. Kolibri este un exemplu datat de ponderi deschise sub Apache 2.0, cu o licență pe care fișa modelului o limitează la ponderile și fișierele de configurare din depozit.
Toate paginile furnizorilor citate aici au fost recitite pe 6 octombrie 2026, iar anunțul Snowflake pe 9 octombrie 2026. Dacă un furnizor mută o dată, acest articol va fi corectat.