





















01
Necesare Mereu activ
Indispensabile pentru funcționarea site-ului (autentificare, preferințe, securitate). Mereu active.
Pe 1 octombrie 2026, Cloudflare a lansat modelele de decizie Clef și Clef-flash, iar Strands Labs a lansat Strands Decider 2B, toate cu ponderi deschise sub Apache 2.0. Iată unde se potrivesc modelele de decizie mici și calibrate în agenții unui MSP și unde se opresc.
Pe 1 octombrie 2026, două companii au publicat aceeași idee în aceeași zi. Cloudflare a lansat două modele de decizie, Clef și Clef-flash, găzduite pe Workers AI și publicate pe Hugging Face sub licența Apache 2.0. În aceeași zi, Strands Labs a lansat Strands Decider 2B, un model de decizie cu două miliarde de parametri, ale cărui ponderi, date de antrenare și scripturi sunt deschise sub Apache 2.0.
Un model de decizie nu scrie text. Citește o situație, „starea”, și un set de întrebări tipizate și returnează o probabilitate pentru fiecare răspuns permis, astfel încât codul tău să poată direcționa un tichet, aproba sau opri un apel de instrument ori preda cazul unui om. Ambii furnizori își prezintă lansarea ca pe un răspuns la atenția din jurul modelului de decizie Jev al Typesafe AI și amândoi spun că modelele lor sunt compatibile cu API-ul acestuia.
Un cadru se aplică pentru tot ce urmează: fiecare cifră de acuratețe și latență din acest articol este raportată de furnizor. Asta include mediana de 209 ms raportată de Cloudflare pentru Clef și de 39 ms pentru Clef-flash, precum și cele aproximativ 115 ms pe care Strands le raportează pe un RTX 3090 local.
Pentru un MSP, partea interesantă nu este cine conduce un clasament. Este faptul că deciziile mici, structurate și repetabile dintr-un agent pot trece de pe un model general mare pe ceva ieftin, calibrat și rulabil pe propriul hardware. Acest articol explică ce este un model de decizie, ce a lansat fiecare furnizor, unde se potrivește tiparul și unde se oprește.
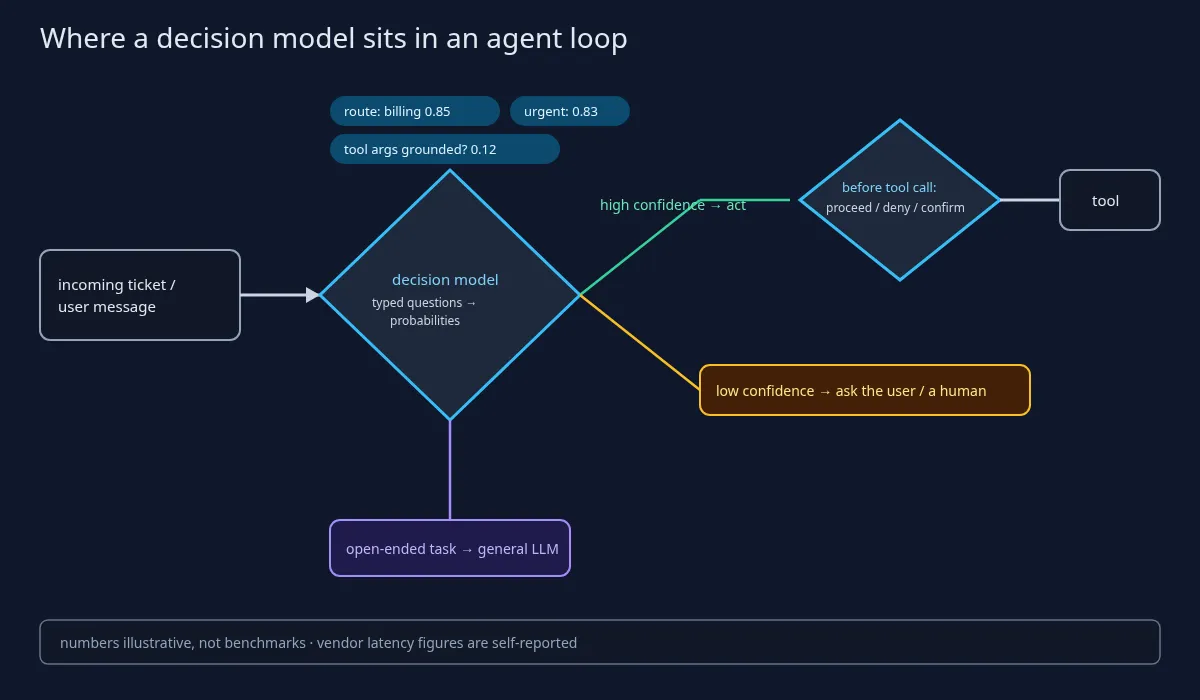
Ambele postări descriu aceeași interfață. Transmiți o stare, care poate fi text sau JSON și, în cazul Clef, imagini, plus întrebări tipizate. O întrebare da/nu se numește noul în ambele API-uri, o întrebare cu o singură alegere este un choice, iar o scară ordonată este un score. Modelul returnează o probabilitate pentru fiecare opțiune permisă și răspunde întotdeauna din opțiunile pe care i le-ai dat.
Acest lucru e util din două motive. Un răspuns dintr-o mulțime închisă nu necesită analizarea ieșirii și nu poate inventa o categorie nouă. Iar o probabilitate îi permite codului să stabilească un prag: peste el acționează, sub el întreabă un om. Strands subliniază că mai multe întrebări despre aceeași intrare costă puțin dacă sunt puse împreună, astfel că o singură trecere poate returna echipa responsabilă, un indicator de urgență și o verificare a fundamentării.
Furnizorii descriu diferența față de un model lingvistic prin felul în care se produce răspunsul. Decizia se ia într-o singură trecere paralelă prin intrare, nu token cu token, și de aici vin promisiunile de viteză.
La fel de important este ce nu este un model de decizie. După chiar spusele Strands, modelul său este mult mai slab decât modelele de raționament pe probleme complexe și inutil pentru programare, chat sau rezumare, pentru că nu poate genera text. Punctul său forte sunt alegerile mici și repetate, nu cele dificile.
Clasificatoarele există de ani de zile, iar un cititor sceptic va spune asta. Promisiunea, așa cum o formulează postarea Cloudflare, este un singur model care acceptă categorii noi în momentul cererii, fără reantrenare: schimbi întrebarea, nu modelul.
Potrivit postării Cloudflare din 1 octombrie și fișei sale de pe Hugging Face, au fost lansate două modele: Clef și Clef-flash, găzduite pe Workers AI și descărcabile sub Apache 2.0. Fișa descrie Clef ca un model multimodal de 27B, post-antrenat pornind de la Qwen3.8-27B, care citește text, JSON, imagini sau video și răspunde într-o singură trecere înainte, fără generare liberă. Potrivit postării, Clef-flash îngheață o bază Qwen3.5-9B. Ambele adaugă un mic cap de direcționare și adaptoare de rang redus cu rangul 256, antrenate cu funcții de pierdere pentru calibrare.
Cloudflare numește două lucruri care, spune compania, diferențiază Clef: un encoder vizual, astfel încât imaginile pot face parte din stare, și o fereastră de context de 64k tokeni, pe care o pune în contrast cu cei 32k ai lui Jev.
Cifrele provin dintr-o rulare internă a Cloudflare a suitei Decision Index și toate sunt raportate de furnizor. Cloudflare raportează o acuratețe BFCL case-exact de 98,47 pentru Clef și de 98,76 pentru Clef-flash. Raportează o latență mediană de 209,3 ms pentru Clef și de 38,8 ms pentru Clef-flash, cu o latență p95 raportată de 238,6 ms și, respectiv, 122,4 ms.
Aceleași tabele arată și partea mai slabă. Chiar cifrele raportate de Cloudflare arată Clef în urma lui Jev pe seturi de raționament mai dificile, precum GPQA Diamond, MMLU-Pro și BBH. Se potrivește cu tiparul: modelele de decizie sunt construite pentru alegeri delimitate, nu pentru raționament dificil.
Încă două afirmații ale furnizorului, marcate ca atare. Într-o anecdotă, Cloudflare relatează că un flux de clasificare a domeniilor a durat 2,2 secunde cu Clef, față de 4,7 secunde cu gpt-oss-120b. Ca angajament, Cloudflare spune că nu citește, nu stochează și nu antrenează pe cereri și răspunsuri, decât dacă clientul optează pentru serviciul său de fine-tuning.
Găzduirea proprie este posibilă, dar nu ușoară. Exemplul de referință din fișă a fost testat pe un singur H200; Clef este un model de 27B, nu un model pentru laptop. Clef-flash și endpointul găzduit sunt variantele mai ușoare. Cloudflare a anunțat și un serviciu de fine-tuning prin învățare prin întărire, oferit mai întâi prin inginerii săi detașați la clienți și ulterior în regim self-service; postarea nu publică prețuri.
Potrivit postării Strands Labs din 1 octombrie și fișei sale de pe Hugging Face, Strands Decider 2B este un model de decizie cu două miliarde de parametri construit pe Qwen3.5-2B, căruia i s-a eliminat capul de generare a textului, înlocuit cu un mic cap de pointer, de puțin peste un milion de parametri, care punctează fiecare opțiune. Trunchiul este ajustat cu o LoRA de rang 16. Checkpointul publicat este v19, după multe iterații al căror istoric se află în depozit.
Deschiderea este titlul principal. Codul este pe GitHub, ponderile pe Hugging Face și, potrivit Strands, la fel toate datele de antrenare și scripturile folosite pentru a construi modelul, sub Apache 2.0. Fișa spune că reantrenarea durează aproximativ 11 ore pe un RTX 3090. Pentru un MSP care vrea să adapteze un model de decizie la propriile categorii de tichete, tocmai această reproductibilitate contează.
Cifrele sunt raportate de furnizor. Strands raportează o mediană de aproximativ 115 ms pentru decizii locale pe un RTX 3090, iar legenda graficului spune că măsurătoarea a fost făcută pe v18, nu pe v19. Raportează aproximativ 153 ms pentru sarcini mici pe un MacBook M3. Fișa raportează 167 din 231 de sarcini publice JevBench rezolvate corect și marchează rezultatul drept „self-reported”.
Strands își publică propriile limite, iar acestea își au locul în orice notă de adoptare. Documentele lungi, cu mai mulți pași, sunt punctul slab. Întrebările sunt citite cu mai puțină atenție decât documentele. Calibrarea a fost ajustată pe sarcini scurte de clasificare, așa că fișa recomandă măsurarea pragurilor pe propriul trafic înainte de a avea încredere în ele.
O linie operațională pe care un MSP nu trebuie să o rateze: potrivit fișei, comanda integrată strands-decider serve ascultă pe 127.0.0.1 și nu are autentificare, iar fișa o recomandă pentru experimente locale. Nu o expune ca atare într-o rețea partajată.
Exemplul detaliat din postare este o verificare înaintea unui apel de instrument: sunt argumentele instrumentului fundamentate pe ce a spus de fapt utilizatorul și este prea devreme pentru a acționa? Strands îl numește o ilustrare, nu o recomandare, și așa trebuie citit.
Mai jos este exemplul Strands din fișa modelului, rulat pe o mașină locală. Fișa notează că o reantrenare dă cifre ușor diferite.
pip install strands-decider

strands-decider ask StrandsAgents/strands-decider-2B-hobson-v19 \
  --state "Help! My payouts have been failing for 3 days! " \
  --choice "Which team should handle this?=billing,sales,retail" \
  --noul "Does this convey urgency?"
Ambii furnizori numesc aceeași familie de utilizări, iar ele se potrivesc bine cu operațiunile de agenți ale unui MSP: direcționarea și urgența tichetelor, direcționarea modelelor (trimiterea unei cereri către un model ieftin sau unul scump), alegerea instrumentelor, verificări înaintea unui apel de instrument, clasificarea după politici și trierea alertelor. Acestea sunt deciziile de rutină la care un LLM general este lent, scump și mai greu de auditat.
Strands descrie clar forma hibridă: LLM-ul ia deciziile dificile, iar modelul de decizie pe cele de rutină. Asta reduce costul și latența doar dacă o măsori pe propria sarcină de lucru. Nu oferim aici nicio cifră de economii, pentru că pentru sarcina ta nu există una până când nu o măsori.
Controale de adoptare, din partea apărării, fiecare cu dovada sa:
Ce să nu faci: nu lăsa un model de decizie să fie singura barieră înaintea unei acțiuni ireversibile. Combină-l cu o politică deterministă sau cu un om, așa cum face chiar exemplul Strands cu acțiunile proceed, deny și confirm.
Patru lucruri pe care acest articol nu le este.
Nu este o recenzie a lui Jev de la Typesafe. Ambii furnizori numesc Jev drept declanșator al lansărilor lor; acest articol nu l-a testat și nu citează nicio cifră Jev decât așa cum apare în tabelele Cloudflare.
Nu este despre Laminar flow-1, un model mic care citește urmele de execuție ale agenților pentru a găsi erori. Aceea este o altă știre.
Nu este despre Reflection Beam, un model general mare anunțat, ale cărui ponderi sunt încă așteptate.
Nu este un articol despre prețurile Workers AI. Postarea Cloudflare nu publică niciun preț pentru Clef sau pentru serviciul său de fine-tuning, iar acest articol nu inventează niciunul.
Faptele verificate: pe 1 octombrie 2026, Cloudflare a lansat Clef, un model de decizie multimodal de 27B post-antrenat pornind de la Qwen3.8-27B, și Clef-flash, pe Workers AI și pe Hugging Face sub Apache 2.0, cu un serviciu de fine-tuning prin învățare prin întărire care urmează. În aceeași zi, Strands Labs a lansat Strands Decider 2B, construit pe Qwen3.5-2B cu o LoRA și un cap de pointer, cu ponderi, cod, date de antrenare și scripturi sub Apache 2.0.
Fiecare cifră de acuratețe și latență din acest articol este raportată de furnizor: scorul BFCL raportat de 98,47 și mediana de 209 ms pentru Clef, mediana raportată de 38,8 ms pentru Clef-flash și cifra de aproximativ 115 ms pe un RTX 3090 pe care Strands o raportează pentru Decider. Chiar tabelele Cloudflare arată Clef în urmă pe seturile de raționament mai dificile.
Tiparul este adevărata știre. Deciziile delimitate și calibrate dintr-un agent pot trece pe modele mici cu ponderi deschise pe care le poți rula singur, cu un om sau o politică deterministă în spatele fiecărui pas cu încredere scăzută sau ireversibil. Măsoară pe propriul trafic înainte de a avea încredere în vreun prag.