





















01
Niezbędne Zawsze włączone
Wymagane do działania strony (logowanie, preferencje, bezpieczeństwo). Zawsze włączone.
Runware podaje, że jego produkt Serverless jest już dostępny: klienci mogą uruchamiać własny kod, modele i kontenery na jego GPU. Stawka 0,63 USD za godzinę GPU z nagłówka dotyczy rezerwacji ze zobowiązaniem; na żądanie ceny zaczynają się od 1,60 USD za godzinę GPU na L40S.
Runware ogłosił 2 października 2026 we wpisie premierowym autorstwa Ryana Kerry’ego (runware.ai/blog/runware-serverless-now-available), że jego produkt Serverless jest już dostępny. Klienci mogą uruchamiać własny kod, modele i kontenery na infrastrukturze GPU, która obsługuje Model APIs firmy, z workerami skalowanymi do zera w czasie bezczynności. Jedno zastrzeżenie na początek: nagłówek mówi „od 0,63 USD za godzinę GPU” (tłumaczenie własne), ale ta stawka dotyczy zarezerwowanej mocy na RTX PRO 6000, ze stawką i zobowiązaniem uzgadnianymi dla każdego wdrożenia. Na żądanie ceny zaczynają się od 1,60 USD za godzinę GPU na L40S, z rozliczaniem co do sekundy na współdzielonej mocy.
Wpis twierdzi też, że oferuje „moc obliczeniową za połowę ceny neocloudu” (tłumaczenie własne), czego nie uzasadnia i czego nie zweryfikowaliśmy. Ogłoszenie nie mówi, gdzie działają obciążenia ani jakie warunki rezydencji danych obowiązują. Dla dostawcy, który hostuje fine-tune’y lub prywatne modele klientów, skalowanie do zera może wygrać z GPU działającym bez przerwy pod względem kosztów bezczynności. Ale pytaniem umownym jest moc, a nie stawka z nagłówka, bo sam Runware mówi, że rozgrzany worker to nie rezerwacja.
Dalsza część tekstu omawia, co uruchomiono, jak działa rozliczanie, co oznacza moc, pytania o rezydencję danych oraz to, czym ta informacja nie jest.
Wszystko w tej sekcji pochodzi z wpisu Runware z 2 października 2026. Produkt pozwala klientom uruchamiać własny kod, modele lub kontenery w puli GPU, która obsługuje Model APIs Runware. Runware zajmuje się harmonogramowaniem, cyklem życia workerów, skalowaniem, wykonaniem i pomiarem zużycia; klient kontroluje kod, zależności i wymagania obliczeniowe.
Są dwie drogi wejścia: baza kodu w Pythonie, którą Runware pakuje i buduje, albo własny kontener klienta, gdy środowisko uruchomieniowe i zależności muszą pozostać przypięte (wpis wspomina o zachowaniu wersji CUDA i bibliotek). Model zadań jest asynchroniczny: wysyłasz zadanie, jest ono planowane w puli workerów aplikacji, a potem odbierasz wynik. Runware nie opisuje tego jako synchronicznego punktu końcowego o niskich opóźnieniach.
Workery mają 1, 2, 4 lub 8 GPU, o ile pozwala na to typ GPU i dostępna moc. Obciążenie musi samo rozłożyć się na GPU; wpis mówi wprost, że wybranie czterech GPU nie sprawi, że kod napisany dla jednego GPU zadziała cztery razy szybciej. Według Runware jego Sonic Pods mieszczą około 1200 GPU w 20-stopowym kontenerze z chłodzeniem cieczą, a firma buduje je sama, aby obniżyć swój koszt dostarczania mocy obliczeniowej. Nie oglądaliśmy żadnego z nich.
Obserwowalność obejmuje panel z wdrożeniami, stanem workerów, przydziałem GPU, długością kolejki, żądaniami, błędami, logami i kosztami, a do tego SDK, CLI i API. Zrzut ekranu konsoli na stronie jest oznaczony jako dane symulowane. Oferta w jednym zdaniu: Model APIs dla modeli z katalogu, Serverless dla własnego obciążenia na zarządzanej platformie, Runware Compute dla bezpośredniego dostępu do maszyn.
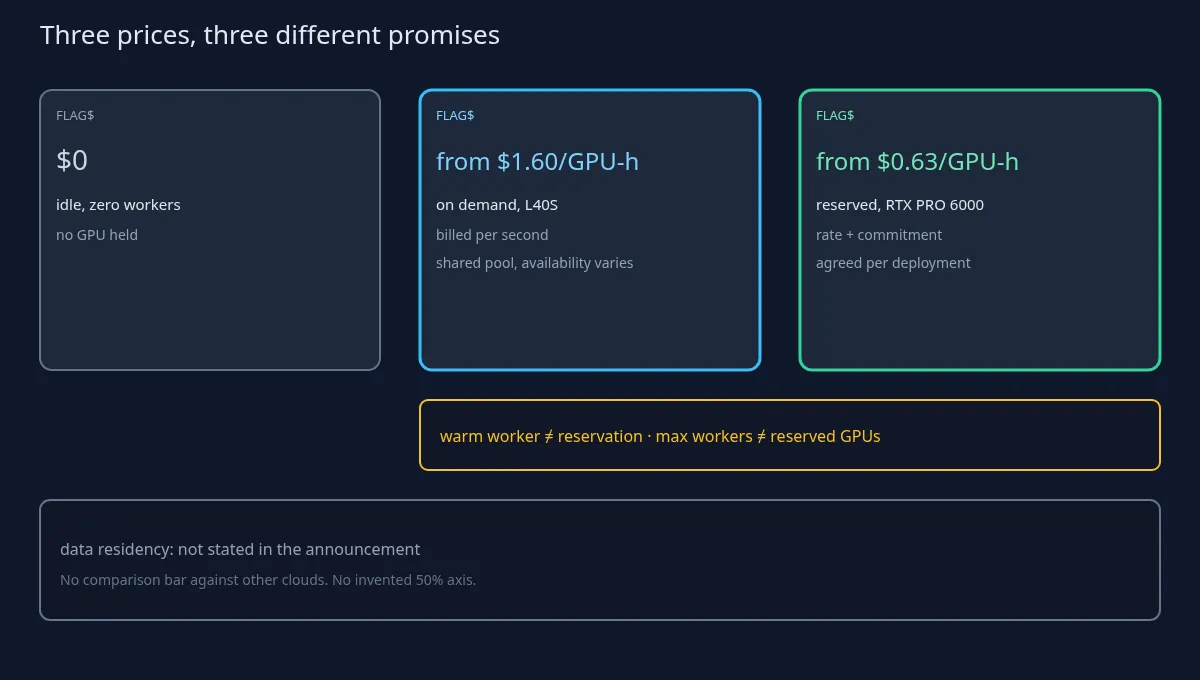
Ustaw trzy liczby obok siebie i nie mieszaj ich. Wszystkie trzy to ceny katalogowe dostawcy. 0 USD za moc obliczeniową w bezczynności przy zerze workerów. Od 1,60 USD/godz. GPU na żądanie (L40S), rozliczanie co do sekundy, bez długoterminowego zobowiązania, moc współdzielona. Od 0,63 USD/godz. GPU z rezerwacją (RTX PRO 6000), stawka i zobowiązanie uzgadniane dla wdrożenia. „Od” oznacza minimum dla jednego typu GPU; stawki zależą od sprzętu.
Problem nagłówka w jednym zdaniu: tytuł strony i jej pierwszy wiersz eksponują 0,63 USD, czyli minimum dla rezerwacji. Kto zobaczy tylko tytuł, wyceni obciążenie na żądanie na mniej niż połowę jego rzeczywistej stawki początkowej.
„Połowa ceny neocloudu” to twierdzenie dostawcy. Wpis nie podaje podstawy porównania: który neocloud, które GPU, jakie wykorzystanie, jaki okres. Nie zweryfikowaliśmy tego, a ten artykuł nie wylicza własnego odsetka.
Szczegóły rozliczeń warte uwagi MSP, wszystkie z wpisu: opłaty na żądanie naliczane są od chwili, gdy worker zajmuje GPU, do chwili, gdy je zwalnia, łącznie z ładowaniem modelu po przydziale i czasem bezczynności rozgrzanego workera między zadaniami. Nie są naliczane: oczekiwanie na moc, pobieranie obrazu przed przydziałem oraz przywracanie po awarii platformy po stronie Runware. Workery wielo-GPU są rozliczane za każde przydzielone GPU. Co do przepustowości, wpis argumentuje, że sama stawka godzinowa nie pokazuje, ile kosztuje obciążenie, bo ilość pracy na godzinę GPU się zmienia. To prawda w ogólności i oznacza też, że żadnej z tych cen nie da się przeliczyć na koszt pojedynczego żądania. Wpis nie zawiera tabeli TCO, danych o oszczędnościach klientów ani porównania z wymienionymi z nazwy hiperskalerami.
Myśl samego Runware, w parafrazie: utrzymywanie rozgrzanego workera kosztuje i nie stanowi rezerwacji mocy. Rozgrzane workery pomagają w kwestii opóźnień; rezerwacja zapewnia uzgodnioną ilość mocy GPU. To różne obietnice, a ich pomylenie sprawia, że SLA zostaje napisane wobec niewłaściwego mechanizmu.
Ustawienie maksymalnej liczby workerów, również według wpisu, ogranicza ich liczbę i nie rezerwuje tych GPU we współdzielonej puli. Skalowanie w górę na żądanie odbywa się „w zależności od dostępności GPU” (tłumaczenie własne), a zadania czekają w kolejce, gdy brakuje mocy. Workery wielo-GPU potrzebują kilku wolnych GPU jednocześnie i ich umieszczenie może trwać dłużej, gdy pula jest zajęta. Rozwiązanie proponowane w samym wpisie to zarezerwowanie mocy bazowej.
Zimne starty: Runware twierdzi, że zbudował optymalizacje startu i trwałe wolumeny na wagi i pamięć podręczną, a czasy startu nadal zależą od rozmiaru modelu, środowiska uruchomieniowego, dostępności i konfiguracji. Nie opublikowano liczb dotyczących zimnych startów, a ten artykuł żadnych nie szacuje.
Dla MSP oznacza to: jeśli umowa z klientem obiecuje czas odpowiedzi, pula na żądanie plus rozgrzany worker nie są, według opisu samego dostawcy, gwarancją mocy. Gwarancją jest zarezerwowana moc bazowa, wyceniona i objęta zobowiązaniem dla danego wdrożenia. To pytanie umowne, a nie krytyka. Pytania do formularza zamówienia: wielkość i typ GPU zarezerwowanej mocy bazowej; co dzieje się z zadaniami w kolejce, gdy popyt przekracza rezerwację; oraz czy przywracanie po awarii platformy wiąże się z jakimikolwiek kredytami serwisowymi (wpis mówi, że przywracanie nie jest naliczane; nie wspomina o kredytach ani SLA).
Najpierw luka: wpis premierowy nie podaje regionów, rezydencji danych, warunków przetwarzania danych, podmiotów przetwarzających ani okresów przechowywania logów i danych zadań. Nie uzupełniamy żadnego z tych punktów, a opis Sonic Pods również nie zdradza regionu.
Dlaczego to ważne dla MSP, który hostuje fine-tune lub prywatny model klienta: wagi, dane wejściowe zadań, wyniki i logi widoczne w panelu to dane klienta albo dane z nich pochodne. Własny kontener zachowuje kontrolę nad środowiskiem uruchomieniowym; sam w sobie nie mówi, gdzie stoją GPU ani kto widzi wolumeny.
Pytania do Runware, zanim trafi tam obciążenie klienta, zadane jako pytania, a nie oskarżenia: gdzie fizycznie działają workery i trwałe wolumeny; czy wdrożenie można przypiąć do regionu; jak długo przechowywane są dane zadań, wyniki i logi; kim są podmioty przetwarzające; jak sekrety są przekazywane do kontenerów; co dzieje się z wolumenami po usunięciu aplikacji.
Traktuj klucze API i dane uwierzytelniające do rejestru modeli tej platformy jak każdy inny sekret produkcyjny: sejf, rotacja, najmniejsze uprawnienia. Strona nie twierdzi niczego o suwerennej chmurze, certyfikacji ani jurysdykcji i ten artykuł również nie.
To nie jest Prime Inference, inna oferta inferencji, i nie ma tu tabeli porównawczej. To również nie Nebius i Inferize, przejęcie nastawione na zimne starty w Nebius Token Factory; ta transakcja to osobny temat.
To nie jest Cloudflare Web Search: to produkt wyszukiwania, a nie moc obliczeniowa GPU. To ani premiera modelu, ani informacja o chipach: Runware Serverless to warstwa obliczeniowa dla własnych obciążeń. Bez benchmarków modeli, bez planów rozwoju akceleratorów.
W skrócie, jedyne ceny, które potwierdza strona, wszystkie katalogowe ceny dostawcy: 0 USD za moc w bezczynności przy zerze workerów; na żądanie od 1,60 USD/godz. GPU na L40S, z rozliczaniem co do sekundy na współdzielonej mocy; z rezerwacją od 0,63 USD/godz. GPU na RTX PRO 6000, z zobowiązaniem uzgadnianym dla wdrożenia. „Połowa ceny neocloudu” to niezweryfikowane twierdzenie dostawcy. Stwierdzenia o zimnych startach i przepustowości nie mają publicznych benchmarków. Ogłoszenie nie określa rezydencji danych.
Przed podpisaniem uzyskaj na piśmie zarezerwowaną moc bazową, zachowanie kolejki powyżej niej i odpowiedzi w sprawie rezydencji danych. Do tego czasu wyceniaj według stawki na żądanie, a nie stawki z nagłówka.