





















01
Noodzakelijk Altijd aan
Nodig voor de werking van de site (login, voorkeuren, beveiliging). Altijd aan.
Op 1 oktober 2026 bracht Cloudflare de beslismodellen Clef en Clef-flash uit en Strands Labs Strands Decider 2B, allemaal met open gewichten onder Apache 2.0. Hier lees je waar kleine, gekalibreerde beslismodellen in de agents van een MSP passen, en waar ze ophouden.
Op 1 oktober 2026 publiceerden twee bedrijven op dezelfde dag hetzelfde idee. Cloudflare bracht twee beslismodellen uit, Clef en Clef-flash, gehost op Workers AI en gepubliceerd op Hugging Face onder Apache 2.0. Dezelfde dag bracht Strands Labs Strands Decider 2B uit, een beslismodel met twee miljard parameters waarvan de gewichten, trainingsdata en scripts open zijn onder Apache 2.0.
Een beslismodel schrijft geen tekst. Het leest een situatie, de “state”, en een reeks getypeerde vragen, en geeft voor elk toegestaan antwoord een kans terug, zodat je code een ticket kan routeren, een toolaanroep kan goedkeuren of tegenhouden, of kan doorgeven aan een mens. Beide leveranciers presenteren hun release als antwoord op de aandacht rond Jev, het beslismodel van Typesafe AI, en beide zeggen dat hun modellen compatibel zijn met de API daarvan.
Eén kader geldt voor alles hieronder: elk nauwkeurigheids- en latentiecijfer in dit artikel is door de leverancier gerapporteerd. Dat geldt voor de mediaan van 209 ms die Cloudflare voor Clef rapporteert en 39 ms voor Clef-flash, en voor de ongeveer 115 ms die Strands rapporteert op een lokale RTX 3090.
Voor een MSP is het interessante niet wie een ranglijst aanvoert. Het is dat de kleine, gestructureerde, herhaalbare beslissingen in een agent kunnen verhuizen van een groot algemeen model naar iets goedkoops, gekalibreerds en op je eigen hardware draaibaars. Dit artikel behandelt wat een beslismodel is, wat elke leverancier heeft uitgebracht, waar het patroon past en waar het ophoudt.
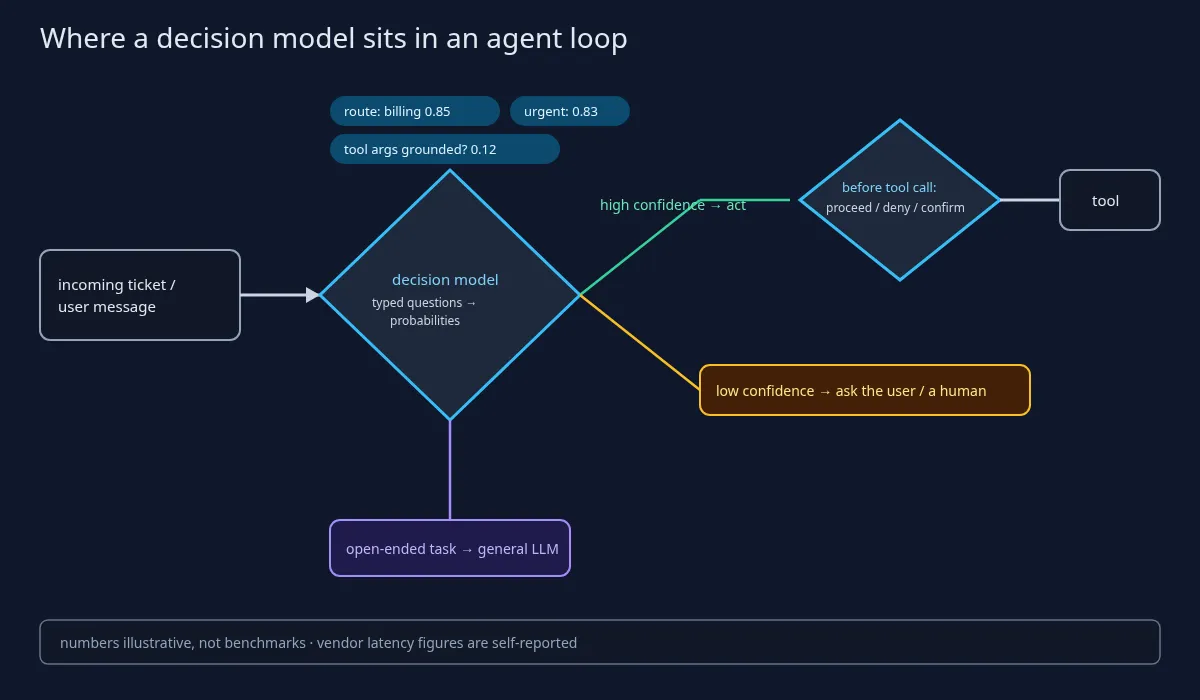
Beide berichten beschrijven dezelfde interface. Je geeft een state mee, die tekst of JSON kan zijn en bij Clef ook afbeeldingen, plus getypeerde vragen. Een ja/nee-vraag heet in beide API’s noul, een keuzevraag is een choice en een geordende schaal een score. Het model geeft voor elke toegestane optie een kans terug en antwoordt altijd uit de opties die je hebt opgegeven.
Dat is om twee redenen nuttig. Een antwoord uit een gesloten verzameling hoeft niet geparsed te worden en kan geen nieuwe categorie verzinnen. En met een kans kan code een drempel instellen: erboven handelen, eronder een mens vragen. Strands benadrukt dat meerdere vragen over dezelfde invoer goedkoop samen te stellen zijn, zodat één doorgang een behandelend team, een urgentievlag en een onderbouwingscontrole kan opleveren.
De leveranciers beschrijven het verschil met een taalmodel aan de hand van hoe het antwoord tot stand komt. De beslissing valt in één parallelle doorgang over de invoer in plaats van token voor token, en daar komen de snelheidsclaims vandaan.
Wat een beslismodel niet is, telt net zo zwaar. Volgens Strands zelf is zijn model bij complexe problemen veel zwakker dan redeneermodellen, en nutteloos voor programmeren, chat of samenvatten, omdat het geen tekst kan genereren. Zijn kracht ligt in kleine, herhaalde keuzes, niet in moeilijke.
Classificatiemodellen bestaan al jaren, en een sceptische lezer zal dat zeggen. De belofte, zoals Cloudflares bericht die brengt, is één model dat nieuwe categorieën op het moment van het verzoek accepteert zonder opnieuw te trainen: je verandert de vraag, niet het model.
Volgens Cloudflares bericht van 1 oktober en zijn modelkaart op Hugging Face zijn er twee modellen uitgebracht: Clef en Clef-flash, gehost op Workers AI en te downloaden onder Apache 2.0. De kaart beschrijft Clef als een multimodaal 27B-model, nagetraind vanuit Qwen3.8-27B, dat tekst, JSON, afbeeldingen of video leest en in één forward pass antwoordt, zonder vrije generatie. Volgens het bericht bevriest Clef-flash een Qwen3.5-9B-backbone. Beide voegen een kleine routeringskop en low-rank-adapters met rang 256 toe, getraind met kalibratieverliezen.
Cloudflare noemt twee dingen die Clef volgens het bedrijf onderscheiden: een vision-encoder, zodat afbeeldingen deel van de state kunnen zijn, en een contextvenster van 64k tokens, dat het tegenover de 32k van Jev zet.
De cijfers komen uit Cloudflares eigen interne run van de Decision Index-suite, en ze zijn allemaal door de leverancier gerapporteerd. Cloudflare rapporteert een BFCL-nauwkeurigheid (case-exact) van 98,47 voor Clef en 98,76 voor Clef-flash. Het rapporteert een mediane latentie van 209,3 ms voor Clef en 38,8 ms voor Clef-flash, met een gerapporteerde p95-latentie van respectievelijk 238,6 ms en 122,4 ms.
Dezelfde tabellen laten ook de zwakkere kant zien. Volgens Cloudflares eigen cijfers loopt Clef achter op Jev bij moeilijkere redeneersets zoals GPQA Diamond, MMLU-Pro en BBH. Dat past in het patroon: beslismodellen zijn gebouwd voor afgebakende keuzes, niet voor moeilijk redeneren.
Nog twee uitspraken van de leverancier, als zodanig gemarkeerd. In een anekdote meldt Cloudflare dat een workflow voor domeinclassificatie 2,2 seconden duurde met Clef tegenover 4,7 seconden met gpt-oss-120b. Als belofte zegt Cloudflare verzoeken en antwoorden niet te lezen, op te slaan of te gebruiken voor training, tenzij de klant kiest voor de fine-tuningdienst.
Zelf hosten kan, maar is niet licht. Het referentievoorbeeld van de kaart is getest op één H200; Clef is een 27B-model, geen laptopmodel. Clef-flash en het gehoste endpoint zijn de lichtere routes. Cloudflare kondigde ook een fine-tuningdienst op basis van reinforcement learning aan, eerst via zijn forward-deployed engineers en later als selfservice; het bericht noemt geen prijzen.
Volgens het bericht van Strands Labs van 1 oktober en de modelkaart op Hugging Face is Strands Decider 2B een beslismodel met twee miljard parameters, gebouwd op Qwen3.5-2B, waarbij de tekstgeneratiekop is verwijderd en vervangen door een kleine pointerkop van iets meer dan een miljoen parameters die elke optie scoort. De romp is gefinetuned met een LoRA van rang 16. Het uitgebrachte checkpoint is v19, na vele iteraties waarvan de geschiedenis in de repository staat.
Openheid is de kop. De code staat op GitHub, de gewichten op Hugging Face en, volgens Strands, ook alle trainingsdata en scripts waarmee het model is gebouwd, onder Apache 2.0. Volgens de kaart duurt opnieuw trainen ongeveer 11 uur op één RTX 3090. Voor een MSP die een beslismodel wil aanpassen aan zijn eigen ticketcategorieën, is die reproduceerbaarheid precies het punt.
De cijfers zijn door de leverancier gerapporteerd. Strands rapporteert een mediaan van ongeveer 115 ms voor lokale beslissingen op een RTX 3090, en het bijschrift van de grafiek zegt dat die meting op v18 is gedaan, niet op v19. Voor kleine taken op een M3 MacBook rapporteert het ongeveer 153 ms. De kaart rapporteert 167 van 231 openbare JevBench-taken correct en markeert dat resultaat als “self-reported”.
Strands publiceert zijn eigen beperkingen, en die horen in elke adoptienotitie. Lange documenten met meerdere stappen zijn het zwakke punt. Vragen worden minder zorgvuldig gelezen dan de documenten. De kalibratie is afgesteld op korte classificatietaken, dus de kaart raadt aan drempels op je eigen verkeer te meten voordat je ze vertrouwt.
Eén operationele regel die een MSP niet mag missen: volgens de kaart bindt het ingebouwde commando strands-decider serve aan 127.0.0.1 en heeft het geen authenticatie, en de kaart zegt het voor lokale experimenten te gebruiken. Stel het niet ongewijzigd open op een gedeeld netwerk.
Het uitgewerkte voorbeeld in het bericht is een controle vóór een toolaanroep: zijn de argumenten van de tool onderbouwd door wat de gebruiker werkelijk zei, en is het te vroeg om te handelen? Strands noemt het een illustratie en geen aanbeveling, en zo moet je het ook lezen.
Hieronder staat het voorbeeld van Strands uit de modelkaart, uitgevoerd op een lokale machine. De kaart merkt op dat opnieuw trainen iets andere cijfers oplevert.
pip install strands-decider

strands-decider ask StrandsAgents/strands-decider-2B-hobson-v19 \
  --state "Help! My payouts have been failing for 3 days! " \
  --choice "Which team should handle this?=billing,sales,retail" \
  --noul "Does this convey urgency?"
Beide leveranciers noemen dezelfde familie van toepassingen, en die sluiten goed aan op de agentprocessen van een MSP: ticketroutering en urgentie, modelroutering (een verzoek naar een goedkoop of een duur model sturen), toolkeuze, controles vóór een toolaanroep, policyclassificatie en triage van alerts. Dat zijn de routinebeslissingen waarbij een algemeen LLM traag, duur en moeilijker te auditen is.
Strands beschrijft de hybride vorm duidelijk: laat het LLM de moeilijke beslissingen nemen en het beslismodel de routinematige. Dat verlaagt kosten en latentie alleen als je het op je eigen workload meet. Een besparingscijfer staat hier niet, want voor jouw workload bestaat er geen totdat je er een meet.
Adoptiemaatregelen, aan de kant van de verdediging, elk met het bijbehorende bewijs:
Wat je niet moet doen: laat een beslismodel niet de enige poort zijn vóór een onomkeerbare actie. Combineer het met een deterministische policy of een mens, zoals het voorbeeld van Strands zelf doet met zijn acties proceed, deny en confirm.
Vier dingen die dit artikel niet is.
Het is geen review van Jev van Typesafe. Beide leveranciers noemen Jev als aanleiding voor hun releases; dit artikel heeft Jev niet getest en citeert geen Jev-cijfer, behalve zoals het in Cloudflares tabellen staat.
Het gaat niet over Laminar flow-1, een klein model dat agenttraces leest om fouten te vinden. Dat is een ander verhaal.
Het gaat niet over Reflection Beam, een groot algemeen model dat is aangekondigd terwijl de gewichten nog uitblijven.
Het is geen stuk over de prijzen van Workers AI. Cloudflares bericht noemt geen prijs voor Clef of voor de fine-tuningdienst, en dit artikel verzint er geen.
De geverifieerde feiten: op 1 oktober 2026 bracht Cloudflare Clef uit, een multimodaal 27B-beslismodel nagetraind vanuit Qwen3.8-27B, en Clef-flash, op Workers AI en op Hugging Face onder Apache 2.0, met een fine-tuningdienst op basis van reinforcement learning in het verschiet. Dezelfde dag bracht Strands Labs Strands Decider 2B uit, gebouwd op Qwen3.5-2B met een LoRA en een pointerkop, met gewichten, code, trainingsdata en scripts onder Apache 2.0.
Elk nauwkeurigheids- en latentiecijfer in dit artikel is door de leverancier gerapporteerd: Clefs gerapporteerde BFCL-score van 98,47 en mediaan van 209 ms, de gerapporteerde mediaan van 38,8 ms voor Clef-flash en het cijfer van ongeveer 115 ms op een RTX 3090 dat Strands voor de Decider rapporteert. Cloudflares eigen tabellen laten zien dat Clef achterloopt op moeilijkere redeneersets.
Het patroon is het verhaal. Afgebakende, gekalibreerde beslissingen in een agent kunnen verhuizen naar kleine modellen met open gewichten die je zelf kunt draaien, met een mens of een deterministische policy achter elke stap met lage zekerheid of zonder weg terug. Meet op je eigen verkeer voordat je een drempel vertrouwt.