





















01
Noodzakelijk Altijd aan
Nodig voor de werking van de site (login, voorkeuren, beveiliging). Altijd aan.
Verspreid over tien dagen in oktober 2026 bereiken verschillende gehoste model-ID's hun uitfaseringsdatum: legacy-snapshots van OpenAI op 23 oktober, de MaaS-ID's voor open modellen van Google op 21 oktober, Gemini 2.5 op Google Cloud op 16 of 20 oktober en twee Snowflake Cortex-modellen op 14 oktober. Pin model-ID's, geef elk een eigenaar en weet welke open gewichten je zelf zou kunnen draaien.
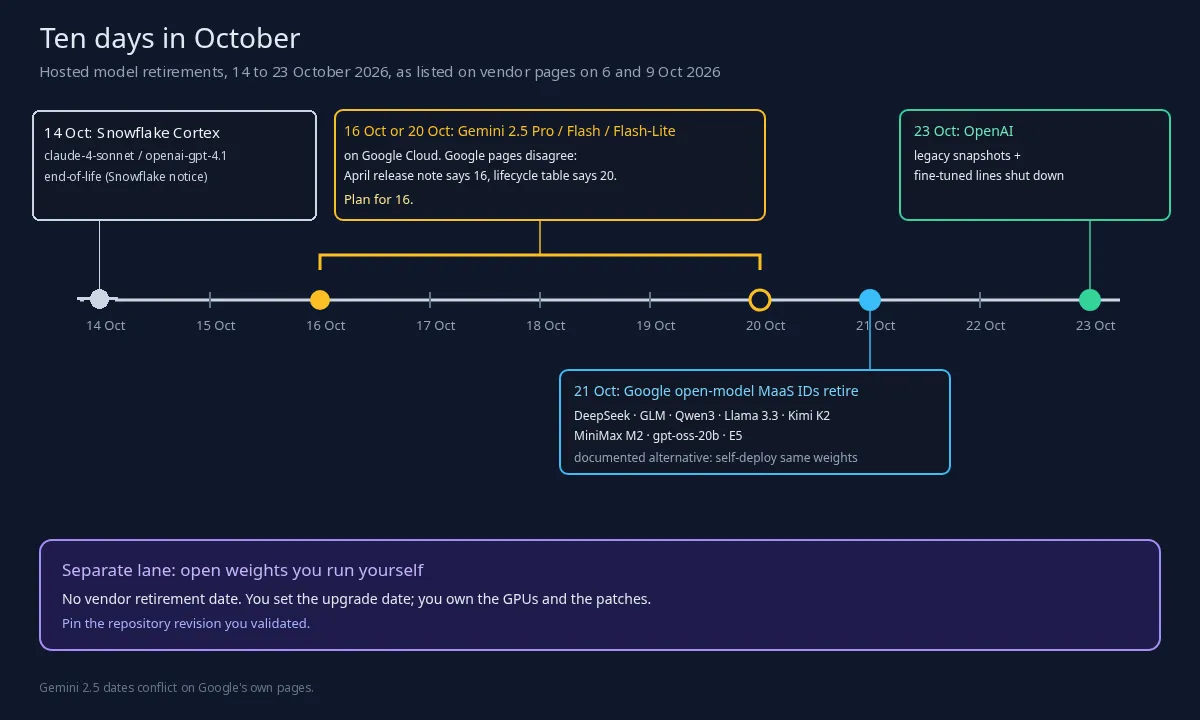
Begin bij de kalender. Verspreid over tien dagen in oktober 2026 bereiken verschillende gehoste model-ID's hun uitfaseringsdatum. De deprecationspagina van OpenAI noemt een reeks legacy-snapshots en fijngetunede lijnen met 23 oktober 2026 als uitschakeldatum. De Model-as-a-Service-tabel van Google voor open modellen legt 21 oktober vast als uitfaseringsdatum voor de ID's van DeepSeek, GLM, Qwen3, Llama 3.3, Kimi K2, MiniMax M2, gpt-oss-20b en E5-embeddings, en noemt het zelf uitrollen van dezelfde gewichten als alternatief. De eigen pagina's van Google spreken elkaar tegen over Gemini 2.5 Pro, Flash en Flash-Lite: een release note uit april zegt 16 oktober, terwijl de lifecycletabel die op 6 oktober is gelezen 20 oktober zegt. De eigen deprecationsmelding van Snowflake noemt 14 oktober 2026 als end-of-life-datum voor twee Cortex-modellen, claude-4-sonnet en openai-gpt-4.1.
De stelling past in twee zinnen. Een gehost model-ID is een afhankelijkheid met een vervaldatum en hoort dus in een inventaris met een eigenaar bij naam. Open gewichten die je zelf draait hebben geen uitfaseringsdatum van een leverancier, maar ze leggen het upgradetempo, de hardware en het patchen bij jou.
Wat volgt: de kalender per leverancier, wat ‘uitgefaseerd’ in de praktijk betekent, zes gewoonten om model-ID's te pinnen, de eerlijke afwegingen van zelf hosten en een kader over Kolibri van Aleph Alpha, uitgebracht op 3 oktober met open gewichten onder Apache 2.0. Elke datum hieronder komt van een leverancierspagina; die pagina's zijn op 6 oktober 2026 opnieuw gelezen, die van Snowflake op 9 oktober 2026.
OpenAI, 23 oktober. Het gedeelte van de deprecationspagina van OpenAI met de datum 22 april 2026 noemt deze snapshots voor uitschakeling op 23 oktober: gpt-3.5-turbo-0125, gpt-4-0613, gpt-4-turbo, gpt-4.1-nano, gpt-4o-2024-05-13, gpt-image-1, o1-2024-12-17, o1-pro-2025-03-19, o3-mini-2025-01-31, o4-mini-2025-04-16 en ft-o4-mini-2025-04-16, plus fijngetunede lijnen op gpt-3.5-turbo, gpt-4, gpt-4.1-nano, babbage-002 en davinci-002. Als vervangers noemt OpenAI de familie gpt-5.6-sol, gpt-5.6-terra en gpt-5.6-luna, met gpt-image-2.5-sunburst of gpt-image-2.5-flare voor gpt-image-1. Verschillende rijen noemen ook verwante namen in een aparte kolom, en de tabel zegt niet duidelijk of die namen ook stoppen. Waar een rij verwante namen noemt, controleer je elke naam die je code aanroept op de pagina.
Open modellen van Google, 21 oktober. De MaaS-deprecationstabel voor open modellen van Google noemt DeepSeek (OCR, R1-0528, V3.1 en V3.2), GLM (5 en 4.7), gpt-oss-20b, Kimi K2 Thinking, Llama 3.3 70B Instruct, MiniMax M2, twee meertalige E5-embeddingmodellen en vier Qwen3-varianten: in totaal 16 model-ID's met 21 oktober als uitfaseringsdatum. Ze zijn allemaal op 21 juli als verouderd gemarkeerd, en elke rij noemt het zelf uitrollen van het model in Model Garden als alternatief.
Gemini 2.5 op Google Cloud, 16 of 20 oktober. Een release note uit april noemde 16 oktober; de lifecycletabel van Google die op 6 oktober is gelezen, toont 20 oktober. Plan op de vroegste datum en controleer de lifecyclepagina voor je project. In detail: een release note van Vertex AI van rond 2 april 2026 zegt dat de uitfaseringsdata voor Gemini 2.5 Pro, Flash-Lite en Flash ‘zijn bijgewerkt naar 16 oktober 2026’ (onze vertaling). De actuele tabel met modelversies en lifecycle toont 20 oktober voor alle drie, met vervangers zoals gemini-3.8-flash, gemini-3.5-flash, gemini-3.5-flash-lite en gemini-3.1-flash-lite. We vonden geen latere notitie die het verschil verklaart. De deprecationspagina van Google voor de Gemini API kondigt voor deze drie modellen geen uitschakeldatum aan, dus de deadline hangt af van welk Google-platform een workload aanroept.
Snowflake Cortex, 14 oktober. De melding van Snowflake over deprecations van Cortex-modellen noemt 14 oktober 2026 als end-of-life-datum voor claude-4-sonnet en openai-gpt-4.1, die op 12 augustus 2026 de legacy-status kregen. Na de end-of-life-datum mislukken query's en API-aanroepen die een van beide modellen noemen.
ChatGPT en Codex, 14 oktober. De officiële changelog van ChatGPT en Codex van OpenAI legt in een bericht van 14 september 2026 vast dat GPT-5.5 op 14 oktober 2026 uit ChatGPT, ChatGPT Work en Codex wordt teruggetrokken, voor alle abonnementen, ook Business, Enterprise en Edu. Volgens hetzelfde bericht geldt dit niet voor de OpenAI-API, dus API-aanroepen naar gpt-5.5 worden er niet door geraakt. In Codex hebben standaardinstellingen van werkruimten, opgeslagen modelinstellingen, eigen agents, geplande taken en scripts die nog gpt-5.5 kiezen een vervangend model nodig.
De kalender stopt niet na oktober. De volgende OpenAI-data die al op de pagina staan, zijn 1 december voor GPT Image-modellen en 11 december voor gedateerde snapshots van GPT-5 en o3.
‘Uitgefaseerd’ klinkt administratief. In productie betekent het fouten. De pagina van Google over open modellen onderscheidt twee fasen. Tijdens de deprecationperiode blijft het endpoint werken voor bestaande workloads zodat je kunt migreren, maar nieuw gebruik van het endpoint kan worden beperkt. Op de uitfaseringsdatum wordt het endpoint gedeactiveerd en mislukken API-verzoeken die een uitgefaseerd model-ID aanroepen.
OpenAI formuleert het korter: bij uitschakeling is een model of endpoint niet meer bereikbaar. Eén regel op dezelfde pagina overvalt veel teams. Inferentie op een fijngetuned model stopt wanneer het basismodel als verouderd wordt gemarkeerd, dus een fine-tune gaat maar zo lang mee als het basismodel waarop hij is getraind. De klant die vorig jaar voor een fine-tune betaalde, kocht iets met de vervaldatum van het basismodel.
Opzegtermijnen verschillen per fase. De pagina van OpenAI belooft minstens zes maanden voor algemeen beschikbare modellen, minstens drie maanden voor gespecialiseerde varianten en mogelijk maar ongeveer twee weken voor modellen met preview in de naam. Google houdt open modellen in de previewfase minstens 45 dagen na release beschikbaar. De praktische regel: preview-ID's horen niet op een kritiek pad richting klant, tenzij het contract een snelle migratie toestaat.
Er is een nooduitgang, en die is commercieel. OpenAI zegt dat sommige ontwikkelaars via het salesteam mogelijk dedicated capaciteit kunnen regelen om na een uitschakeldatum toegang te houden. Dat is een onderhandeling, geen standaard, en het zou niet het plan moeten zijn.
Wat in een MSP-omgeving breekt, is zelden de vlaggenschip-app. Het is de vergeten samenvatter in een ticketingintegratie, de embeddingjob achter een zoekindex of de fine-tune waarvoor een klant vorig jaar betaalde. Uitfaseringen van embeddingmodellen tellen dubbel: een nieuw embeddingmodel betekent meestal het corpus opnieuw indexeren, niet alleen een naam in een configuratiebestand vervangen.
Een inventarisrij heeft een gepind ID nodig, de datum, een vervanger in test en een eigenaar bij naam. De illustratieve YAML hieronder toont de vorm; elke naam erin is een placeholder.
# model-inventory.yaml: one row per call site, reviewed monthly
- call_site: ticket-summarizer
  provider: openai
  model_id: o4-mini-2025-04-16        # listed for shutdown 2026-10-23
  replacement_under_test: gpt-5.6-terra
  owner: platform-team
  eval_set: summaries-golden-v3
  cutover_ticket: CHG-0000
- call_site: kb-search-embeddings
  provider: google-maas
  model_id: multilingual-e5-large-instruct-maas   # retires 2026-10-21
  plan: self-deploy same weights OR switch model + re-index
  owner: search-team
Pinnen is geen product. Het zijn zes gewoonten, elk met iets wat als bewijs telt.
1. Roep in productie gedateerde snapshots aan, geen zwevende namen. Een zwevende naam kan ongemerkt naar een nieuw model verschuiven. Een gedateerd ID verandert alleen als jij het verandert. Bewijs: de uitgerolde configuratie toont het gedateerde ID. Geen bewijs: ‘we gebruiken de nieuwste’.
2. Houd één inventarisrij per aanroeppunt bij, met leverancier, exact ID, eigenaar, uitfaseringsdatum en de vervanger in test. Doorzoek code, infrastructuurconfiguratie en low-code-automatiseringen, niet alleen de hoofdapplicatie. De aanroeppunten die pijn doen, zijn meestal die buiten de hoofdrepository zijn gebouwd.
3. Abonneer je op de gezaghebbende bron. Dat zijn de deprecationspagina's van de leveranciers en de account-e-mails die zij sturen. Een verzamelnieuwsbrief is een tip, geen bron. Dit artikel bewijst dat: over Gemini 2.5 spreekt de ene Google-pagina de andere tegen.
4. Test de vervanger op je eigen verkeer met een kleine golden set vóór de overstap: outputformaat, weigeringen, latentie en kosten per taak. Ga er nooit van uit dat een ‘aanbevolen vervanger’ zich hetzelfde gedraagt als het model dat hij vervangt.
5. Stap over vóór de datum, met een rollbackvenster dat vóór de datum eindigt. Een rollback naar een uitgefaseerd ID is geen rollback. Als de vroegste plausibele datum 16 oktober is, sluit het rollbackvenster vóór 16 oktober.
6. Behandel gewijzigde standaardwaarden als releases. Als een leverancier verandert naar welk model een standaardnaam verwijst, kunnen de rekening en het gedrag verschuiven zonder enige prijswijziging. Pinnen maakt daar een geplande wijziging van, met een ticket, een test en een eigenaar.
Het duidelijkste bewijs dat gehoste toegang en het model zelf twee verschillende dingen zijn, komt van Google. Voor elk open model met 21 oktober als uitfaseringsdatum documenteert de eigen tabel van Google het alternatief: dezelfde gewichten zelf uitrollen in Model Garden. Het endpoint verdwijnt; de gewichten niet.
Wat je wint, is concreet. Gewichten die je downloadt en zelf serveert, verdwijnen niet omdat een leverancier een endpoint uitfaseert. Jij kiest wanneer je upgradet en je kunt precies de revisie houden die je hebt gevalideerd. Pin de repositoryrevisie die je hebt getest, niet alleen de modelnaam, want een modelrepository kan veranderen na je eerste download.
Wat je op je neemt, is net zo concreet: GPU's of gereserveerde capaciteit, een servingstack en de updates daarvan, monitoring, je eigen evaluatie vóór elke upgrade en de beveiligingspatches van alles rond het model. Dat is een reële operationele kostenpost. Het bedrag hangt af van je workload en je contracten, dus dit artikel noemt geen getal.
Licenties verschillen. Sommige open modellen verschijnen onder Apache 2.0; andere gebruiken eigen licenties met eigen voorwaarden voor gebruik, naamsvermelding of schaal. Lees de licentie van precies die repository voordat een klant ervan afhangt, en bewaar een kopie naast de inventarisrij.
Waar past het voor een MSP? Stabiele, goed afgebakende workloads zoals classificatie, extractie en zoeken in de eigen documenten van een klant zijn goede kandidaten. Redeneren op frontierniveau bij grillige vraag vaak niet. Hybride is normaal: gehoste modellen voor de lastige staart, gepinde zelf gehoste gewichten voor de voorspelbare kern. Dit is een algemeen patroon, geen aanbeveling voor een specifiek hostingproduct.
Kader: Kolibri, open gewichten uitgebracht op 3 oktober. Aleph Alpha kondigde Kolibri op 5 oktober 2026 vanuit Heidelberg aan in een persbericht. Het model is sinds 3 oktober beschikbaar en ondersteunt Duits en Engels. Volgens het bedrijf is het ontworpen voor gebruik op infrastructuur die klanten zelf beheren, met gedocumenteerde herkomst van data en ontwerpkeuzes. Het ondersteunt agentische workflows, retrieval-augmented generation en native tool calling, en volgens Aleph Alpha is het getraind om zich te onthouden wanneer de aangeleverde documenten geen onderbouwing bevatten.
De opbouw, volgens de modelkaart op Hugging Face: een mixture-of-expertsmodel met in totaal 78 miljard parameters en ongeveer 3,46 miljard actief per token (het persbericht rondt dit af op ongeveer 3 miljard). De native context is 262.144 tokens; volgens de kaart is de kwaliteit gevalideerd tot ongeveer een miljoen tokens, maar wordt aanbevolen om voor efficiënte serving op of onder 262.144 te blijven.
De licentie, op 6 oktober op de kaart gecontroleerd, is Apache 2.0 voor de gewichten en configuratiebestanden die in die repository zijn gepubliceerd. De kaart zegt ook waar de licentie niet voor geldt: onderliggende code, modelarchitectuur, parameterinstellingen of trainingsmethoden. ‘Open gewichten onder Apache 2.0’ is de juiste omschrijving. De hele stack open source noemen gaat verder dan wat de kaart beweert.
De hardwarerealiteit, opnieuw volgens de kaart: FP8-gewichten met een geheugenvoetafdruk van ongeveer 78 GB, en als minimum twee A100 80 GB, twee H100 SXM5, of één H200, B200 of B300. Serving gebeurt met het pakket aleph-alpha-inference van Aleph Alpha, een vLLM-plug-in, of het bijbehorende containerimage, en de kaart toont een OpenAI-compatibele API zodra het model zo wordt geserveerd. Weinig actieve parameters verlagen de rekenkracht per token. Ze verkleinen het geheugen niet: het hele model moet er nog steeds in passen.
Waarom het hier thuishoort: voor gewichten die je zelf host geldt geen uitfaseringsdatum van een leverancier, en Kolibri is een actueel, gedateerd voorbeeld van die optie voor Duits- en Engelstalig werk. Drie contextpunten zijn belangrijk. Volgens de kaart is het model bedoeld voor workflows waarin een mens de output beoordeelt voordat erop wordt gehandeld. De overeenkomst van Aleph Alpha met Cohere is nog onderworpen aan goedkeuring door toezichthouders, en het bedrijf blijft tot de afronding zelfstandig opereren. En ‘soeverein’ is in het persbericht van Aleph Alpha het woord van het bedrijf voor controle door de klant en keuzevrijheid. Het is geen certificering, en dit artikel claimt er geen.
De gecontroleerde kalender in één alinea: de uitschakeldatum voor de legacy-snapshots en fijngetunede lijnen van OpenAI is 23 oktober. De uitfaseringsdatum voor de MaaS-ID's voor open modellen van Google is 21 oktober, met het zelf uitrollen van dezelfde gewichten als door Google zelf gedocumenteerd alternatief. Voor Gemini 2.5 Pro, Flash en Flash-Lite op Google Cloud is de uitfaseringsdatum 16 of 20 oktober, afhankelijk van welke Google-pagina je leest, dus plan op 16 oktober. De end-of-life-datum van Snowflake voor claude-4-sonnet en openai-gpt-4.1 in Cortex is 14 oktober.
De operationele regel verandert niet per leverancier. Een gehost model-ID is een afhankelijkheid met een vervaldatum: pin het, zet het in de inventaris, geef het een eigenaar en test de vervanger vóór de datum op je eigen verkeer. Open gewichten die je zelf draait, hebben geen uitfaseringsdatum van een leverancier, maar het upgradetempo, de hardware en het patchen worden jouw zaak. Kolibri is een gedateerd voorbeeld van open gewichten onder Apache 2.0, met een licentie die de modelkaart beperkt tot de gewichten en configuratiebestanden in de repository.
Alle hier aangehaalde leverancierspagina's zijn op 6 oktober 2026 opnieuw gelezen, de melding van Snowflake op 9 oktober 2026. Als een leverancier een datum verschuift, wordt dit artikel gecorrigeerd.