





















01
Necesare Mereu activ
Indispensabile pentru funcționarea site-ului (autentificare, preferințe, securitate). Mereu active.
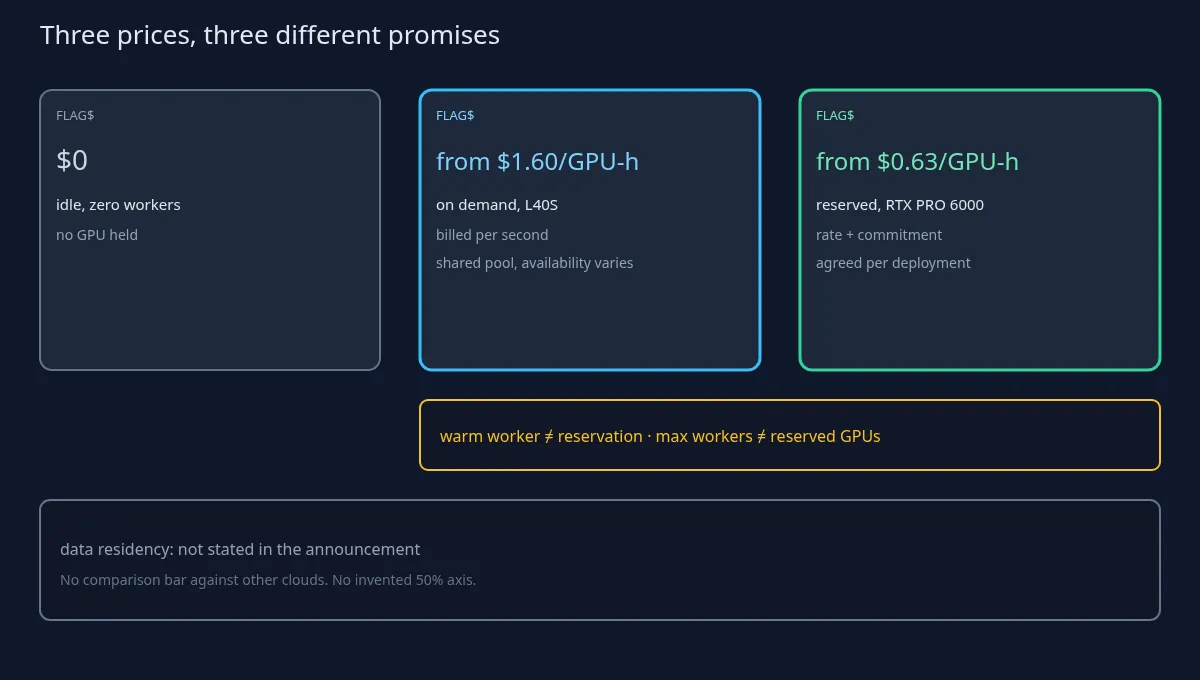
Runware spune că produsul său Serverless este disponibil: clienții își pot rula propriul cod, propriile modele și containere pe GPU-urile sale. Cei 0,63 $ pe oră-GPU din titlu sunt un tarif rezervat cu angajament; la cerere, prețul pornește de la 1,60 $ pe oră-GPU pe L40S.
Runware a anunțat pe 2 octombrie 2026, într-o postare de lansare semnată de Ryan Kerry (runware.ai/blog/runware-serverless-now-available), că produsul său Serverless este disponibil. Clienții își pot rula propriul cod, propriile modele și containere pe infrastructura GPU din spatele Model APIs ale companiei, cu workeri care scad la zero când sunt inactivi. O precizare de la început: titlul spune „de la 0,63 $ pe oră-GPU” (traducerea noastră), dar acest tarif se aplică pentru capacitate rezervată pe RTX PRO 6000, cu tarif și angajament convenite pentru fiecare implementare. La cerere, prețul pornește de la 1,60 $ pe oră-GPU pe L40S, facturat la secundă pe capacitate partajată.
Postarea mai susține că oferă „putere de calcul la jumătate din costul unui neocloud” (traducerea noastră), afirmație pe care nu o fundamentează și pe care nu am verificat-o. Anunțul nu spune unde rulează sarcinile de lucru și nici ce condiții de rezidență a datelor se aplică. Pentru un furnizor care găzduiește fine-tune-uri sau modele private ale clienților, scalarea la zero poate bate un GPU pornit permanent la costul de inactivitate. Dar întrebarea contractuală este capacitatea, nu tariful din titlu, pentru că Runware însuși spune că un worker încălzit nu este o rezervare.
Restul articolului acoperă ce s-a lansat, cum funcționează facturarea, ce înseamnă capacitatea, întrebările despre rezidența datelor și ce nu este această știre.
Tot ce apare în această secțiune provine din postarea Runware din 2 octombrie 2026. Produsul le permite clienților să ruleze propriul cod, propriile modele sau containere pe pool-ul de GPU care deservește Model APIs ale Runware. Runware se ocupă de planificare, ciclul de viață al workerilor, scalare, execuție și contorizare; clientul controlează codul, dependențele și cerințele de calcul.
Există două căi de intrare: o bază de cod Python pe care Runware o împachetează și o construiește, sau un container al clientului atunci când mediul de rulare și dependențele trebuie să rămână fixate (postarea menționează păstrarea versiunilor CUDA și a bibliotecilor). Modelul de joburi este asincron: trimiți un job, acesta este planificat pe pool-ul de workeri a aplicației, iar apoi preiei rezultatul. Runware nu îl descrie ca pe un endpoint sincron cu latență redusă.
Workerii au câte 1, 2, 4 sau 8 GPU-uri, acolo unde tipul de GPU și capacitatea permit. Sarcina de lucru trebuie să se distribuie singură pe GPU-uri; postarea spune clar că alegerea a patru GPU-uri nu face de patru ori mai rapid un cod scris pentru un singur GPU. Potrivit Runware, Sonic Pods găzduiesc aproximativ 1.200 de GPU-uri într-un container de 20 de picioare cu răcire cu lichid, iar compania le construiește singură pentru a-și reduce costul de furnizare a puterii de calcul. Nu am inspectat niciunul.
Observabilitatea include un panou cu implementări, starea workerilor, alocarea GPU-urilor, adâncimea cozii, cereri, erori, jurnale și costuri, plus SDK, CLI și API. Captura de ecran a consolei de pe pagină este marcată ca date simulate. Gama de produse pe un rând: Model APIs pentru modelele din catalog, Serverless pentru propria sarcină de lucru pe o platformă gestionată, Runware Compute pentru acces direct la mașini.
Aliniază cele trei cifre și nu le amesteca. Toate trei sunt prețuri de listă ale furnizorului. 0 $ pentru calcul în inactivitate, cu zero workeri. De la 1,60 $/oră-GPU la cerere (L40S), facturare la secundă, fără angajament pe termen lung, capacitate partajată. De la 0,63 $/oră-GPU rezervat (RTX PRO 6000), tarif și angajament convenite per implementare. „De la” înseamnă un prag minim pentru un singur tip de GPU; tarifele variază în funcție de hardware.
Problema titlului într-o frază: titlul paginii și primul rând pun în față 0,63 $, care este pragul pentru capacitate rezervată. Cine vede doar titlul va estima o sarcină la cerere la mai puțin de jumătate din tariful ei real de pornire.
„Jumătate din costul unui neocloud” este o afirmație a furnizorului. Postarea nu oferă nicio bază pentru comparație: ce neocloud, ce GPU, ce grad de utilizare, ce perioadă. Nu am verificat-o, iar acest articol nu calculează un procent propriu.
Detalii de facturare care merită atenția unui MSP, toate din postare: costurile la cerere curg din momentul în care un worker ocupă un GPU până când îl eliberează, inclusiv încărcarea modelului după alocare și timpul de inactivitate cu workerul încălzit între joburi. Nu se facturează: așteptarea capacității, descărcarea imaginii înainte de alocare și recuperarea de către Runware după o defecțiune a platformei. Workerii cu mai multe GPU-uri sunt facturați pentru fiecare GPU alocat. Despre debit, postarea susține că tariful orar singur nu arată cât costă o sarcină, pentru că volumul de lucru pe oră-GPU variază. Este adevărat în general și înseamnă, de asemenea, că niciunul dintre aceste prețuri nu poate fi transformat într-un cost per cerere. Postarea nu conține un tabel TCO, nicio cifră privind economiile clienților și nicio comparație cu hyperscaleri numiți.
Ideea Runware însuși, parafrazată: menținerea unui worker încălzit costă bani și nu constituie o rezervare de capacitate. Workerii încălziți ajută latența; o rezervare asigură o cantitate convenită de capacitate GPU. Sunt promisiuni diferite, iar confundarea lor este felul în care un SLA ajunge scris pe controlul greșit.
Setarea numărului maxim de workeri, tot din postare, limitează numărul de workeri și nu rezervă acele GPU-uri în pool-ul partajat. Scalarea în sus la cerere are loc „în funcție de disponibilitatea GPU-urilor” (traducerea noastră), iar joburile așteaptă în coadă când capacitatea lipsește. Workerii cu mai multe GPU-uri au nevoie de mai multe GPU-uri libere în același timp și pot fi plasați mai greu când pool-ul este ocupat. Remediul propus chiar de postare este rezervarea unei capacități de bază.
Pornirile la rece: Runware spune că a construit optimizări de pornire și volume persistente pentru ponderi și cache-uri, iar timpii de pornire variază totuși în funcție de mărimea modelului, mediul de rulare, disponibilitate și configurație. Nu există cifre publicate pentru pornirile la rece, iar acest articol nu estimează niciuna.
Pentru un MSP, asta înseamnă: dacă un contract cu un client promite un timp de răspuns, pool-ul la cerere plus un worker încălzit nu reprezintă, după propria descriere a furnizorului, o garanție de capacitate. Garanția este capacitatea de bază rezervată, cu preț și angajament per implementare. Este o întrebare contractuală, nu o critică. Întrebări pentru formularul de comandă: mărimea și tipul de GPU ale capacității de bază rezervate; ce se întâmplă cu joburile din coadă când cererea depășește rezervarea; și dacă recuperarea după o defecțiune a platformei vine cu vreun credit de serviciu (postarea spune că recuperarea nu se taxează; nu menționează credite sau un SLA).
Mai întâi lacuna: postarea de lansare nu numește regiuni, rezidența datelor, condiții de prelucrare a datelor, subprocesatori sau perioade de păstrare pentru jurnale și datele joburilor. Nu completăm niciunul dintre aceste puncte, iar descrierea Sonic Pods nu dezvăluie nici ea o regiune.
De ce contează pentru un MSP care găzduiește fine-tune-ul sau modelul privat al unui client: ponderile, datele de intrare ale joburilor, rezultatele și jurnalele afișate în panou sunt toate date ale clientului sau derivate din acestea. Propriul container păstrează controlul asupra mediului de rulare; în sine, nu spune unde se află GPU-urile sau cine poate vedea volumele.
Întrebări de pus Runware înainte ca o sarcină a unui client să ajungă acolo, ca întrebări și nu ca acuzații: unde rulează fizic workerii și volumele persistente; dacă o implementare poate fi fixată într-o regiune; cât timp se păstrează datele joburilor, rezultatele și jurnalele; cine sunt subprocesatorii; cum sunt transmise secretele către containere; ce se întâmplă cu volumele când o aplicație este ștearsă.
Tratează cheile API și datele de autentificare pentru registrul de modele al acestei platforme ca pe orice alt secret de producție: seif, rotație, privilegiu minim. Pagina nu face afirmații despre cloud suveran, certificare sau jurisdicție, și nici acest articol.
Aceasta nu este Prime Inference, o altă ofertă de inferență, și nu există aici un tabel comparativ. Nu este nici Nebius și Inferize, o achiziție care vizează pornirile la rece în Nebius Token Factory; acea tranzacție este o altă știre.
Aceasta nu este Cloudflare Web Search: acela este un produs de căutare, nu putere de calcul GPU. Nu este nici lansarea unui model, nici o știre despre cipuri: Runware Serverless este un strat de calcul pentru propriile sarcini de lucru. Fără benchmark-uri de modele, fără foi de parcurs pentru acceleratoare.
Pe scurt, singurele prețuri pe care pagina le susține, toate prețuri de listă ale furnizorului: 0 $ pentru calcul în inactivitate, cu zero workeri; la cerere de la 1,60 $/oră-GPU pe L40S, cu facturare la secundă pe capacitate partajată; rezervat de la 0,63 $/oră-GPU pe RTX PRO 6000, cu angajament convenit per implementare. „Jumătate din costul unui neocloud” este o afirmație neverificată a furnizorului. Afirmațiile despre pornirile la rece și debit nu au benchmark-uri publice. Anunțul nu precizează rezidența datelor.
Înainte de semnare, obține în scris capacitatea de bază rezervată, comportamentul cozii peste acest prag și răspunsurile despre rezidența datelor. Până atunci, fă ofertele pe tariful la cerere, nu pe cel din titlu.