






















01
Necessários Sempre ativo
Indispensáveis para o funcionamento do site (sessão, preferências, segurança). Sempre ativos.
Os anúncios de IA local da NVIDIA vistos por uma PME: memória, desempenho, custos e dados a verificar antes de comprar equipamento ou implementar agentes.
A IA local está no centro do anúncio da NVIDIA de 3 de setembro de 2026 na IFA, com modelos de pesos abertos e ferramentas para RTX, DGX Spark e Jetson, incluindo o Nemotron 3.5 Lightning com 30 mil milhões de parâmetros. Esta análise, atualizada a 28 de outubro, distingue as características anunciadas das verificações necessárias a uma PME ou MSP antes da compra de equipamento ou da ligação de um agente aos dados da empresa.
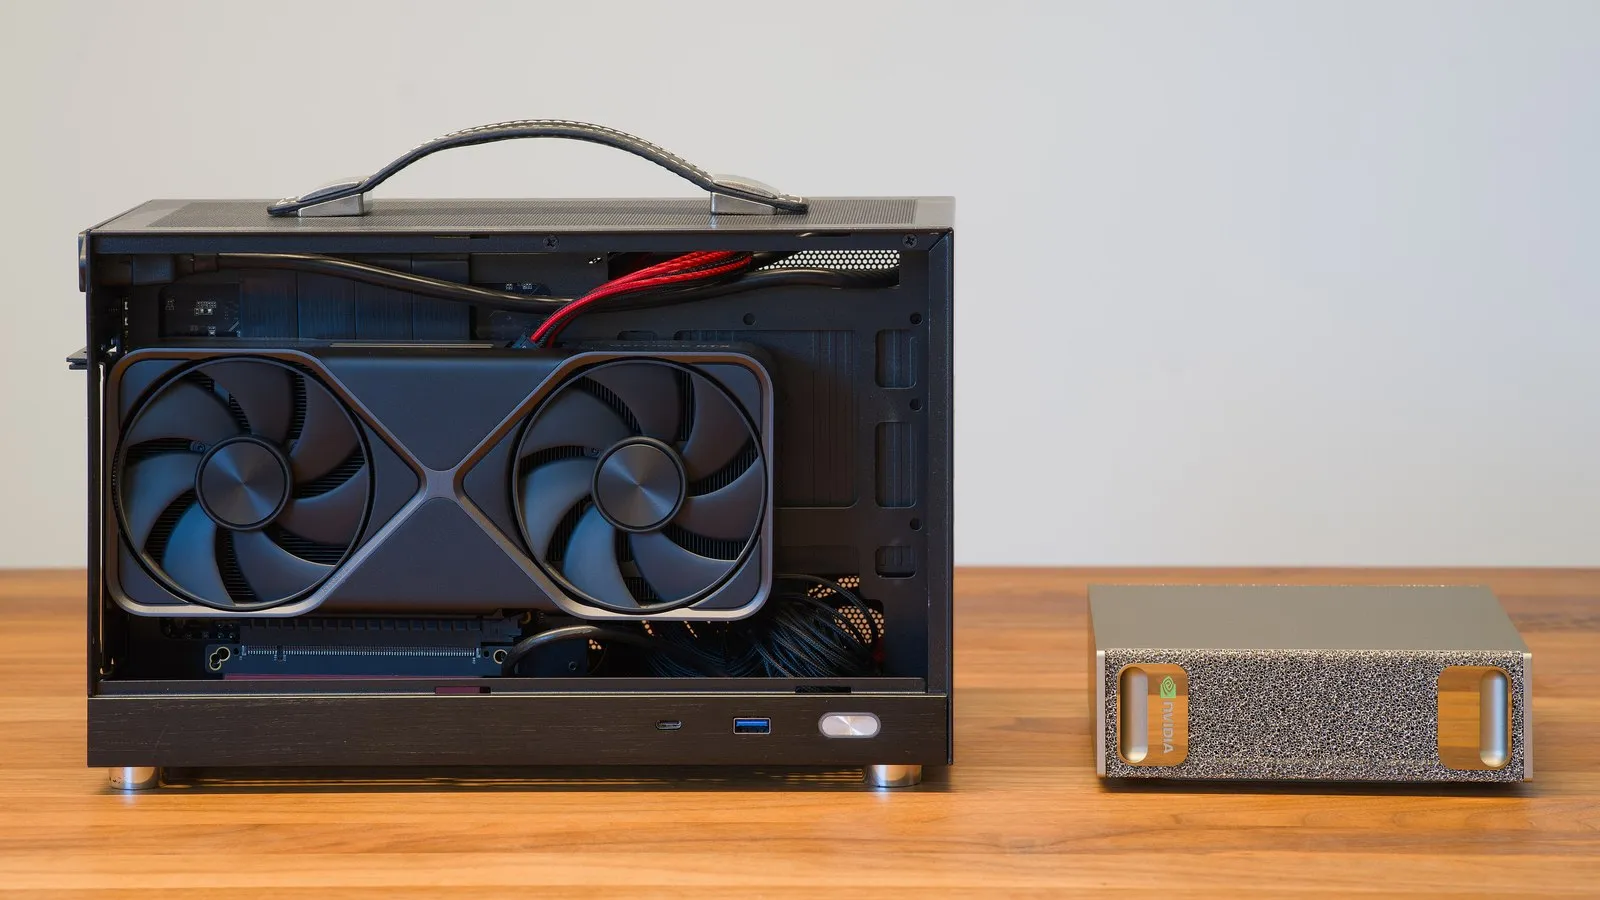
A NVIDIA não é a única fonte destes modelos. A Qwen lançou o Qwen3.8-Flash-Next, um modelo multimodal de mistura de especialistas e de pesos abertos para o DGX Spark e o DGX Station, juntamente com um Qwen3.8-27B mais pequeno, ajustado para trabalho agêntico e de programação local. O Muse Glimmer da Meta, um modelo de programação e agente de 30 mil milhões de parâmetros e de pesos abertos, funciona em PCs RTX, DGX Spark, DGX Station e Jetson. O v4 Flash da DeepSeek, um modelo de mistura de especialistas com 284 mil milhões de parâmetros e 13 mil milhões de parâmetros ativos, está dimensionado para funcionar num cluster DGX Spark de dois nós, e o LTX 2.5 da LTX, um modelo de geração de vídeo, visa GPUs RTX e hardware DGX com novas otimizações de eficiência de memória.
A NVIDIA apontou ainda para os PCs Windows RTX Spark que chegam da Lenovo e da Acer, construídos em torno de uma GPU RTX Blackwell de 1 petaflop com até 128 GB de memória unificada — destinados a programadores que querem inferência local de classe de estação de trabalho num formato de PC. Para gerir a inferência em mais do que uma máquina, a NVIDIA apresentou o PAIR (Personal AI Router), uma ferramenta que distribui cargas de trabalho de IA por PCs em rede, funcionando com GPUs GeForce RTX da série 20 e mais recentes.
As promessas de facilidade e velocidade continuam a ser declarações do fabricante, não medições realizadas pela Altovar. Os prazos citados referem-se ao comunicado de 3 de setembro: disponibilidade, suporte do sistema operativo e compatibilidade de cada configuração devem ser confirmados diretamente antes da compra. Não se apresentam rumores como factos nem se deduz a memória necessária apenas a partir do número de parâmetros.
A proposta é uma menor fricção para executar modelos localmente: a NVIDIA afirma que as aplicações de agentes populares criadas com base no llama.cpp terão uma configuração local simplificada com um clique no Windows, eliminando parte do trabalho manual de escolher um modelo, encontrar um servidor de inferência compatível e afinar as definições de quantização. Para organizações com restrições de residência de dados ou de latência, isso baixa a fasquia para executar modelos capazes no local ou na periferia, em vez de depender de um fornecedor de IA na nuvem — embora os compradores devam continuar a validar o seu próprio desempenho e o custo total de propriedade, em vez de tomarem os números de débito da NVIDIA como garantia.
Antes de um ensaio, deve escolher-se uma tarefa delimitada, como procurar informação em documentos de teste ou preparar uma alteração de código. É preciso registar modelo, quantização, memória disponível, dimensão do contexto e número de pedidos simultâneos. Devem medir-se o tempo até à primeira resposta útil e até ao trabalho concluído, incluindo erros e revisão. Uma demonstração com um pedido não prova que a máquina serve um escritório inteiro. Na comparação com API, contam compra, energia, manutenção, atualizações e horas de gestão: a ausência de uma fatura por token não torna o serviço gratuito.
O percurso dos dados exige uma verificação separada. Um modelo executado no computador não garante que conectores, telemetria, pesquisas web ou pedidos encaminhados para um modelo remoto permaneçam no dispositivo. O fluxo deve ser testado com dados sintéticos e permissões limitadas, observando também falhas da rede ou a indisponibilidade de uma máquina. Um MSP deve separar arquivos e credenciais dos clientes. A adoção deve partir de um resultado verificável e de uma responsabilidade operacional clara; os serviços de inteligência artificial da Altovar ajudam a definir o âmbito, a revisão e os critérios de avaliação antes da escolha das ferramentas.
Fontes: NVIDIA Blog.