





















01
Necessari Sempre attivo
Indispensabili per il funzionamento del sito (login, preferenze, sicurezza). Sempre attivi.
Il modello ternario Bonsai 2 27B di PrismML occupa 5,9 GB e gira su GPU consumer; il motore Splash di Inco AI è costruito specificamente per Apple Silicon. Entrambi sono dati dichiarati dai produttori, non verificati da audit.
Questo mese sono arrivati a pochi giorni di distanza due rilasci per l'inferenza locale: Ternary Bonsai 2 27B di PrismML, un modello fortemente compresso pensato per le GPU consumer, e Splash di Inco AI, un motore di inferenza creato specificamente per Apple Silicon.
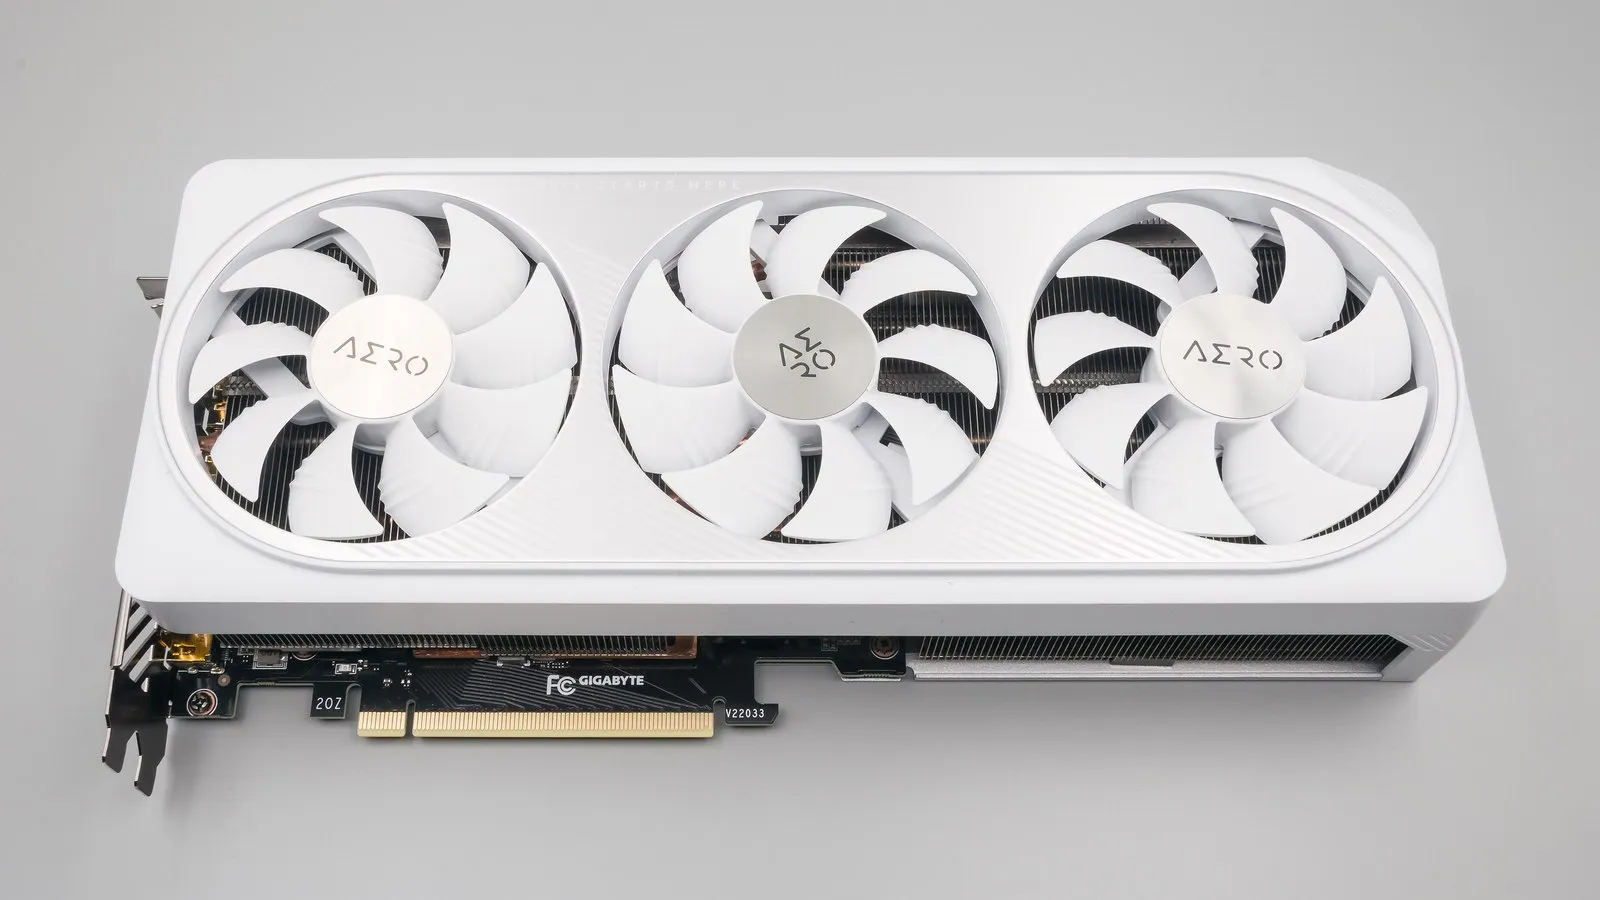
PrismML ha rilasciato Ternary Bonsai 2 27B il 17 settembre con licenza Apache 2.0. Usa pesi ternari con scalatura di gruppo FP16 per ridurre il modello a 5,93 GB, contro i 53,8 GB dello stesso modello in FP16, mentre PrismML dichiara che conserva il 98,2% del punteggio medio del modello genitore Qwen3.8-27B in 20 benchmark. L'azienda segnala fino a 143 token al secondo su una RTX 5090. Un progetto comunitario separato, anch'esso con licenza Apache 2.0, ha ottimizzato le prestazioni di decodifica specificamente per la RTX 3060 12GB — descritta nei suoi stessi benchmark come la singola GPU desktop più diffusa nell'indagine hardware di Steam di agosto 2026, con una quota di poco inferiore al 4% — e ha misurato un miglioramento della velocità di decodifica fino a 1,53x con contesti brevi.
Inco AI ha rilasciato Splash come motore di inferenza open source dedicato esclusivamente ad Apple Silicon e specializzato per due modelli specifici, Qwen3.8-27B e Qwen3.6-35B-A3B, anziché essere costruito come server di modelli generico. Inco segnala circa 144 token al secondo eseguendo Qwen3.8-27B su un MacBook Pro M5 Max e afferma che, nei suoi confronti, è fino a tre volte più veloce nella decodifica rispetto a Ollama e due volte rispetto a MLX. Il motore richiede un chip Apple M3 o più recente e almeno 36 GB di memoria unificata; Inco dichiara inoltre che è stato integrato nella release Bionic di LM Studio nella stessa settimana.
Entrambe le serie di dati provengono dai benchmark del produttore o del progetto, non da una verifica indipendente, e una demo convincente su una singola GPU desktop o su un MacBook non equivale a eseguire inferenza isolata per tenant per molti clienti contemporaneamente. Ciò che questa coppia di annunci dimostra è che l'hardware consumer sta riducendo il divario su carichi di lavoro che un tempo richiedevano un rack: vale la pena monitorarla per casi d'uso pilota ed edge, ma non è ancora un sostituto di una piattaforma ospitata multi-tenant.
Fonti: MarkTechPost, Inco AI.