






















01
Necessari Sempre attivo
Indispensabili per il funzionamento del sito (login, preferenze, sicurezza). Sempre attivi.
Gli annunci NVIDIA sull'AI locale letti dal punto di vista di una PMI: memoria, prestazioni, costi e dati da verificare prima di acquistare o distribuire agenti.
L'AI in locale è al centro dell'annuncio NVIDIA del 3 settembre 2026 all'IFA, che presenta modelli open-weight e strumenti per eseguirli su RTX, DGX Spark e Jetson, incluso Nemotron 3.5 Lightning da 30 miliardi di parametri. Questa analisi, aggiornata il 28 ottobre, distingue le caratteristiche descritte dal produttore dalle verifiche che servono a una PMI o a un MSP prima di acquistare hardware o collegare un agente ai dati aziendali.
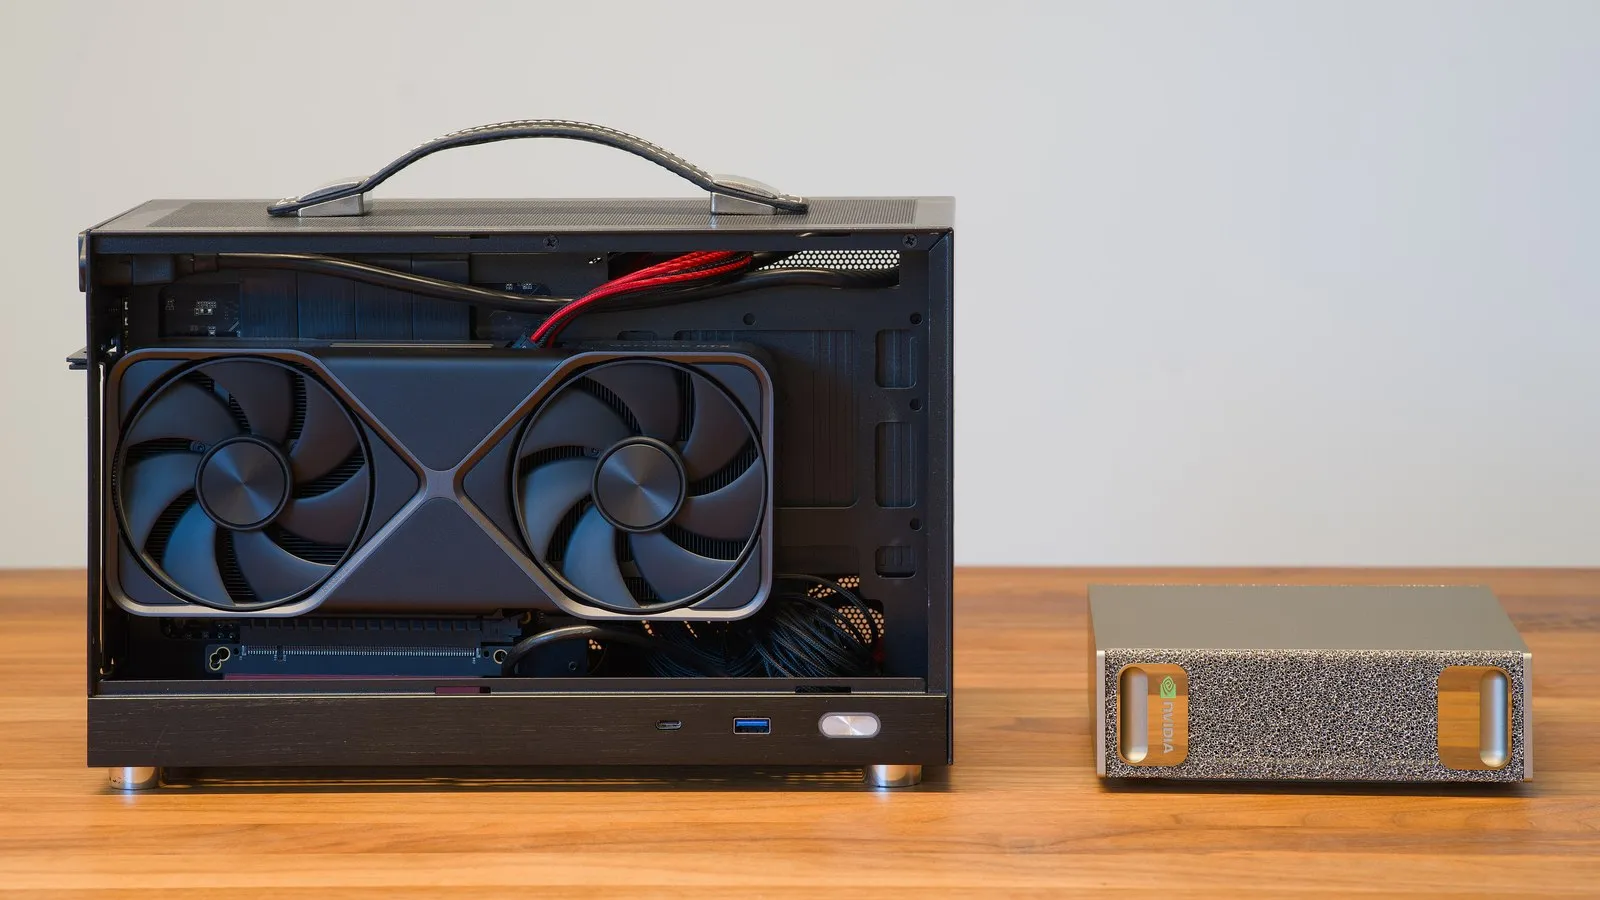
NVIDIA non è l'unica fonte di questi modelli. Qwen ha rilasciato Qwen3.8-Flash-Next, un modello multimodale open-weight a miscela di esperti per DGX Spark e DGX Station, insieme a un Qwen3.8-27B più piccolo ottimizzato per il lavoro agentico e di codifica locale. Muse Glimmer di Meta, un modello open-weight di coding e agenti da 30 miliardi di parametri, gira su PC RTX, DGX Spark, DGX Station e Jetson. DeepSeek v4 Flash, un modello a miscela di esperti da 284 miliardi di parametri con 13 miliardi di parametri attivi, è dimensionato per girare su un cluster DGX Spark a due nodi, e il modello di generazione video LTX 2.5 di LTX punta alle GPU RTX e all'hardware DGX con nuove ottimizzazioni per l'efficienza della memoria.
NVIDIA ha anche indicato i PC Windows RTX Spark in arrivo da Lenovo e Acer, costruiti attorno a una GPU RTX Blackwell da 1 petaflop con fino a 128GB di memoria unificata — pensati per sviluppatori che vogliono un'inferenza locale di classe workstation in un formato PC. Per gestire l'inferenza su più di una macchina, NVIDIA ha introdotto PAIR (Personal AI Router), uno strumento che distribuisce i carichi di lavoro AI tra PC in rete, funzionando con GPU GeForce RTX serie 20 e successive.
Le promesse di facilità d'uso e velocità restano dichiarazioni del produttore, non misurazioni effettuate da Altovar. Le finestre di lancio citate si riferiscono al comunicato del 3 settembre: disponibilità commerciale, supporto del sistema operativo e compatibilità della singola configurazione vanno verificati direttamente prima dell'acquisto. Non riportiamo indiscrezioni come fatti né deduciamo la memoria necessaria dal solo numero di parametri.
La proposta è una minore frizione per eseguire i modelli localmente: NVIDIA afferma che le popolari app agentiche basate su llama.cpp otterranno una configurazione locale semplificata con un clic su Windows, eliminando parte del lavoro manuale di scelta del modello, ricerca di un server di inferenza compatibile e regolazione delle impostazioni di quantizzazione. Per le organizzazioni con vincoli di residenza dei dati o latenza, questo abbassa la barriera per eseguire modelli capaci on-premises o all'edge invece di dipendere da un provider AI cloud — anche se gli acquirenti dovrebbero comunque validare le proprie prestazioni e il costo totale di proprietà piuttosto che prendere le cifre di throughput di NVIDIA come una garanzia.
Prima di una prova scegli un'attività circoscritta, per esempio cercare informazioni in documenti di test o preparare una modifica al codice. Registra modello, quantizzazione, memoria disponibile, lunghezza del contesto e numero di richieste contemporanee. Misura il tempo fino alla prima risposta utile e quello necessario a completare il lavoro, includendo errori e revisione. Una demo con una sola richiesta non dimostra che la macchina possa sostenere un intero ufficio. Nel confronto con le API considera acquisto, energia, manutenzione, aggiornamenti e ore di gestione: l'assenza di una fattura per token non rende gratuito il servizio.
Controlla separatamente il percorso dei dati. Un modello eseguito sul PC non garantisce che connettori, telemetria, ricerca web o richieste inoltrate a un modello remoto restino sul dispositivo. Prova il flusso con dati sintetici, limita i permessi degli strumenti e verifica che cosa accade quando manca la rete o una macchina non è disponibile. Per un MSP, separa anche archivi e credenziali dei clienti. L'adozione dovrebbe partire da un risultato verificabile e da una responsabilità operativa chiara; i servizi di intelligenza artificiale di Altovar offrono un punto di partenza per definire il perimetro e i criteri di valutazione.
Fonti: NVIDIA Blog.