





















01
Nécessaires Toujours actif
Indispensables au fonctionnement du site (session, préférences, sécurité). Toujours actifs.
Le modèle ternaire Bonsai 2 27B de PrismML tient dans 5,9 Go et tourne sur les GPU grand public ; le moteur Splash d’Inco AI est conçu pour Apple Silicon. Les chiffres proviennent des éditeurs, sans audit indépendant.
Deux sorties d’inférence locale ont eu lieu à quelques jours d’intervalle ce mois-ci : le modèle Ternary Bonsai 2 27B de PrismML, un modèle fortement compressé destiné aux GPU grand public, et Splash d’Inco AI, un moteur d’inférence conçu spécifiquement pour Apple Silicon.
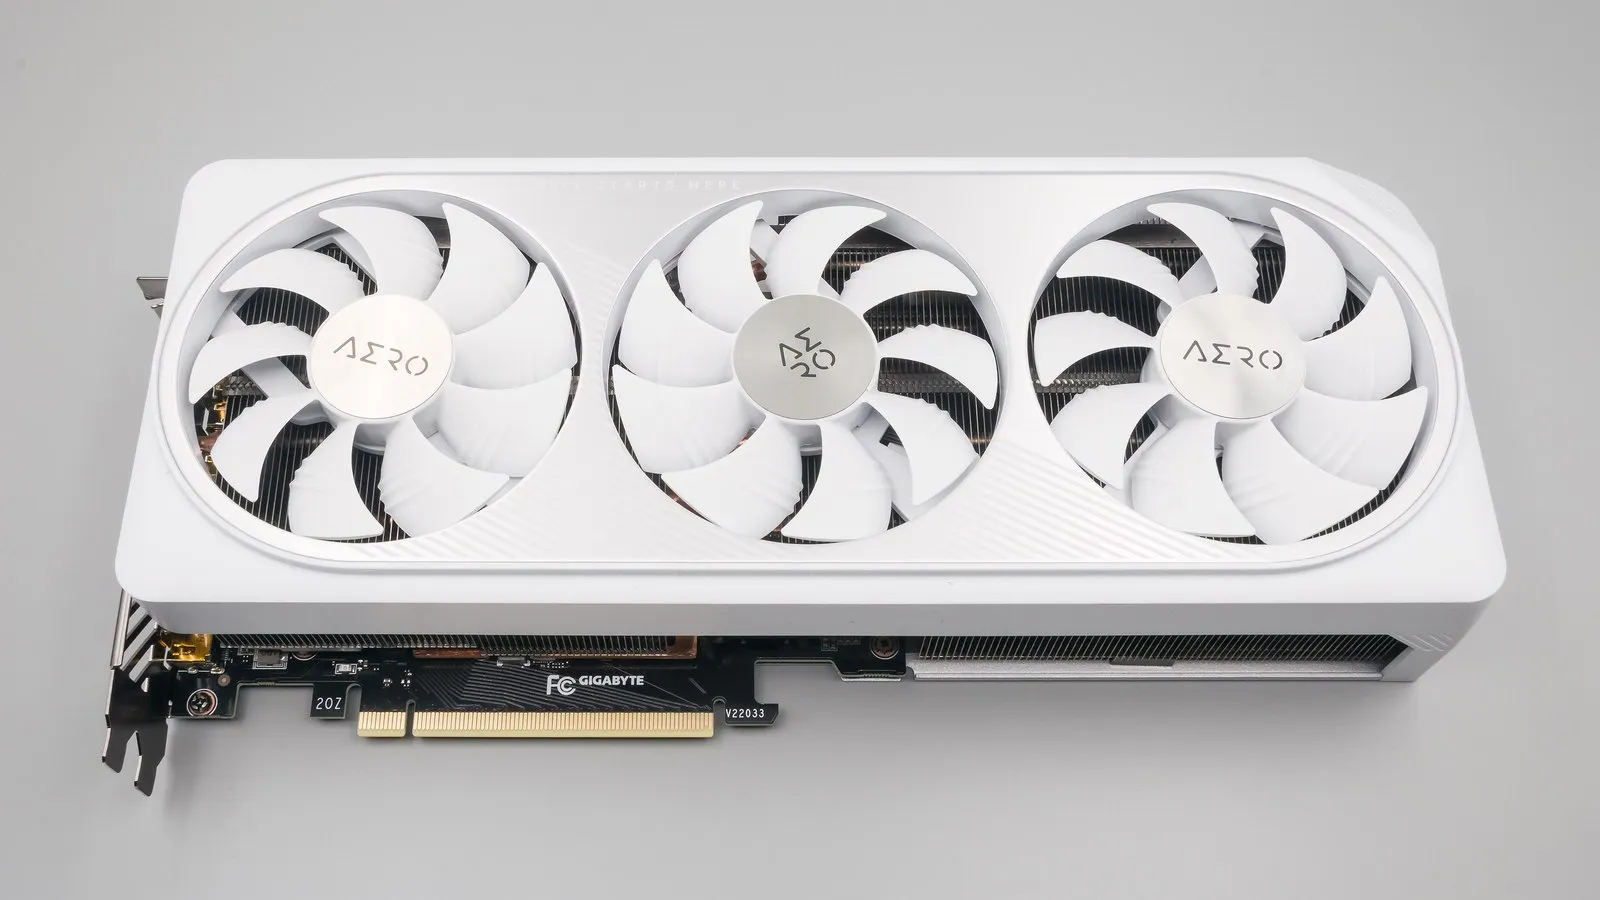
PrismML a publié Ternary Bonsai 2 27B le 17 septembre sous licence Apache 2.0. Il utilise des poids ternaires avec une mise à l’échelle par groupe en FP16 pour réduire le modèle à 5,93 Go, contre 53,8 Go pour le même modèle en FP16, tout en conservant, selon PrismML, 98,2 % du score moyen du modèle parent Qwen3.8-27B sur 20 benchmarks. L’entreprise annonce jusqu’à 143 jetons par seconde sur une RTX 5090. Un projet communautaire distinct, lui aussi sous licence Apache 2.0, a optimisé les performances de décodage spécifiquement pour la RTX 3060 12 Go – décrite dans ses propres benchmarks comme la carte graphique de bureau la plus courante dans l’enquête matérielle Steam d’août 2026, avec un peu moins de 4 % de part – et a mesuré une amélioration de la vitesse de décodage pouvant atteindre 1,53x sur des contextes courts.
Inco AI a publié Splash comme un moteur d’inférence open source, réservé à Apple Silicon, spécialisé pour deux modèles précis, Qwen3.8-27B et Qwen3.6-35B-A3B, plutôt que conçu comme un serveur de modèles généraliste. Inco annonce environ 144 jetons par seconde pour Qwen3.8-27B sur un MacBook Pro M5 Max, soit, selon ses propres comparaisons, jusqu’à trois fois la vitesse de décodage d’Ollama et deux fois celle de MLX. Le moteur nécessite une puce Apple M3 ou plus récente et au moins 36 Go de mémoire unifiée, et Inco indique qu’il a été intégré à la version Bionic de LM Studio la même semaine.
Les deux séries de chiffres proviennent de l’éditeur ou des benchmarks internes du projet, et non d’un audit indépendant ; une bonne démonstration sur un seul GPU de bureau ou un MacBook ne pose pas le même problème que l’exécution d’une inférence isolée par locataire pour de nombreux clients à la fois. Ce que ce duo montre, en revanche, c’est que le matériel grand public comble l’écart sur des charges qui exigeaient auparavant une baie – un point à suivre pour les projets pilotes et les cas d’usage en périphérie, pas encore un substitut à une plateforme hébergée multi-locataires.
Sources : MarkTechPost, Inco AI.