






















01
Nécessaires Toujours actif
Indispensables au fonctionnement du site (session, préférences, sécurité). Toujours actifs.
Les annonces NVIDIA sur l'IA locale vues par une PME : mémoire, performances, coûts et flux de données à vérifier avant l'achat ou le déploiement d'agents.
L'IA locale est au cœur de l'annonce NVIDIA du 3 septembre 2026 à l'IFA, qui présente des modèles à poids ouverts et des outils pour RTX, DGX Spark et Jetson, dont Nemotron 3.5 Lightning à 30 milliards de paramètres. Cette analyse, actualisée le 28 octobre, distingue les caractéristiques annoncées des vérifications nécessaires à une PME ou à un MSP avant d'acheter du matériel ou de relier un agent aux données de l'entreprise.
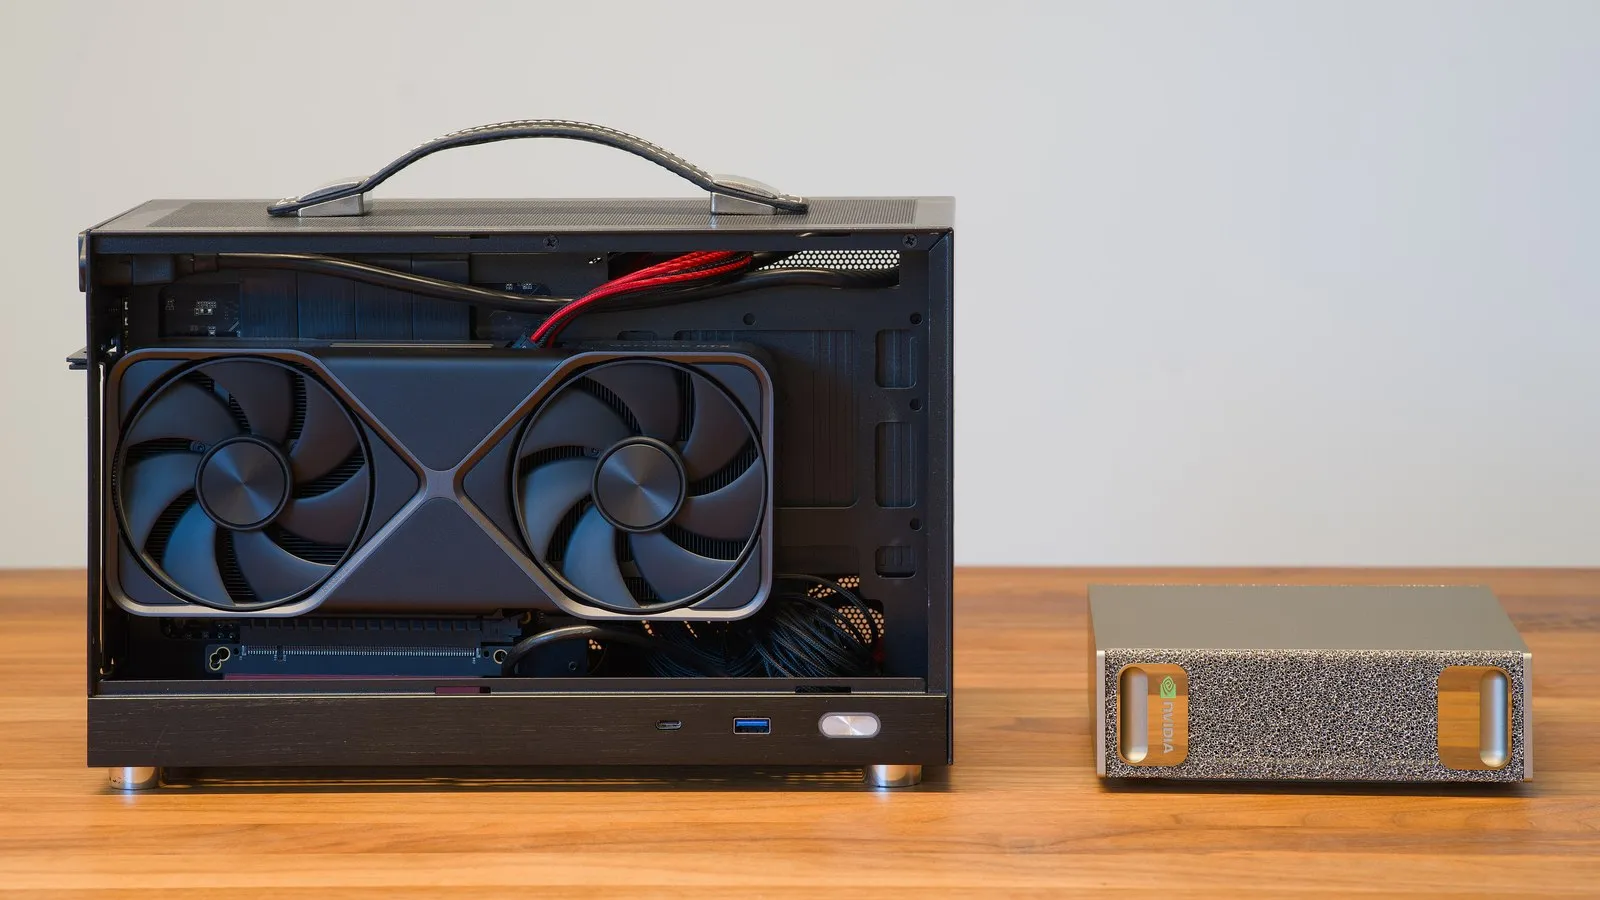
NVIDIA n’est pas la seule source de ces modèles. Qwen a publié Qwen3.8-Flash-Next, un modèle multimodal à mélange d’experts et à poids ouverts pour DGX Spark et DGX Station, aux côtés d’un Qwen3.8-27B plus petit, optimisé pour les tâches agentiques et de codage en local. Muse Glimmer de Meta, un modèle de codage et d’agent à poids ouverts de 30 milliards de paramètres, fonctionne sur les PC RTX, DGX Spark, DGX Station et Jetson. Le modèle v4 Flash de DeepSeek, un modèle à mélange d’experts de 284 milliards de paramètres avec 13 milliards de paramètres actifs, est dimensionné pour fonctionner sur un cluster DGX Spark à deux nœuds, et le modèle de génération vidéo LTX 2.5 de LTX cible les GPU RTX et le matériel DGX avec de nouvelles optimisations d’efficacité mémoire.
NVIDIA a également évoqué les PC Windows RTX Spark qui arrivent de chez Lenovo et Acer, construits autour d’un GPU RTX Blackwell d’un pétaflops avec jusqu’à 128 Go de mémoire unifiée — destinés aux développeurs qui veulent une inférence locale de classe station de travail dans un format PC. Pour gérer l’inférence sur plusieurs machines, NVIDIA a présenté PAIR (Personal AI Router), un outil qui répartit les charges de travail d’IA sur des PC en réseau, compatible avec les GPU GeForce RTX série 20 et plus récents.
Les promesses de simplicité et de vitesse restent des affirmations du fabricant, pas des mesures effectuées par Altovar. Les fenêtres de lancement citées correspondent au communiqué du 3 septembre : disponibilité commerciale, prise en charge du système et compatibilité de chaque configuration doivent être vérifiées directement avant l'achat. Nous ne présentons pas de rumeurs comme des faits et ne déduisons pas la mémoire nécessaire du seul nombre de paramètres.
L’argument consiste à réduire les frictions pour exécuter des modèles en local : NVIDIA indique que les applications d’agents populaires construites sur llama.cpp bénéficieront d’une installation locale simplifiée en un clic sous Windows, éliminant une partie du travail manuel consistant à choisir un modèle, à trouver un serveur d’inférence compatible et à régler les paramètres de quantification. Pour les organisations soumises à des contraintes de résidence des données ou de latence, cela abaisse la barrière pour exécuter des modèles performants sur site ou en périphérie au lieu de dépendre d’un fournisseur d’IA cloud — même si les acheteurs doivent valider leurs propres performances et leur coût total de possession plutôt que de considérer les chiffres de débit de NVIDIA comme une garantie.
Avant un essai, choisissez une tâche délimitée, comme rechercher une information dans des documents de test ou préparer une modification de code. Notez le modèle, la quantification, la mémoire disponible, la taille du contexte et le nombre de requêtes simultanées. Mesurez le délai jusqu'à la première réponse utile et jusqu'au travail terminé, erreurs et révision comprises. Une démonstration avec une seule requête ne prouve pas qu'une machine peut servir tout un bureau. Pour comparer aux API, incluez achat, électricité, maintenance, mises à jour et temps de gestion : sans facture par token, le service n'est pas gratuit.
Vérifiez séparément les flux de données. Un modèle exécuté sur le PC ne garantit pas que les connecteurs, la télémétrie, les recherches web ou les requêtes envoyées à un modèle distant restent sur l'appareil. Testez le parcours avec des données synthétiques, limitez les droits des outils et observez les conséquences d'une panne réseau ou de l'indisponibilité d'une machine. Un MSP doit aussi séparer archives et identifiants des clients. L'adoption doit partir d'un résultat vérifiable et d'une responsabilité opérationnelle claire ; les services d'intelligence artificielle d'Altovar aident à définir le périmètre et les critères d'évaluation.
Sources : NVIDIA Blog.