





















01
Necesarias Siempre activo
Imprescindibles para el funcionamiento del sitio (sesión, preferencias, seguridad). Siempre activas.
El Bonsai 2 27B ternario de PrismML cabe en 5,9 GB y corre en GPU de consumo; el motor Splash de Inco AI está creado para Apple Silicon. Ambos evaluados por sus fabricantes, no auditados de forma independiente.
Este mes se publicaron dos lanzamientos de inferencia local con pocos días de diferencia: el Ternary Bonsai 2 27B de PrismML, un modelo muy comprimido orientado a GPU de consumo, y Splash de Inco AI, un motor de inferencia creado específicamente para Apple Silicon.
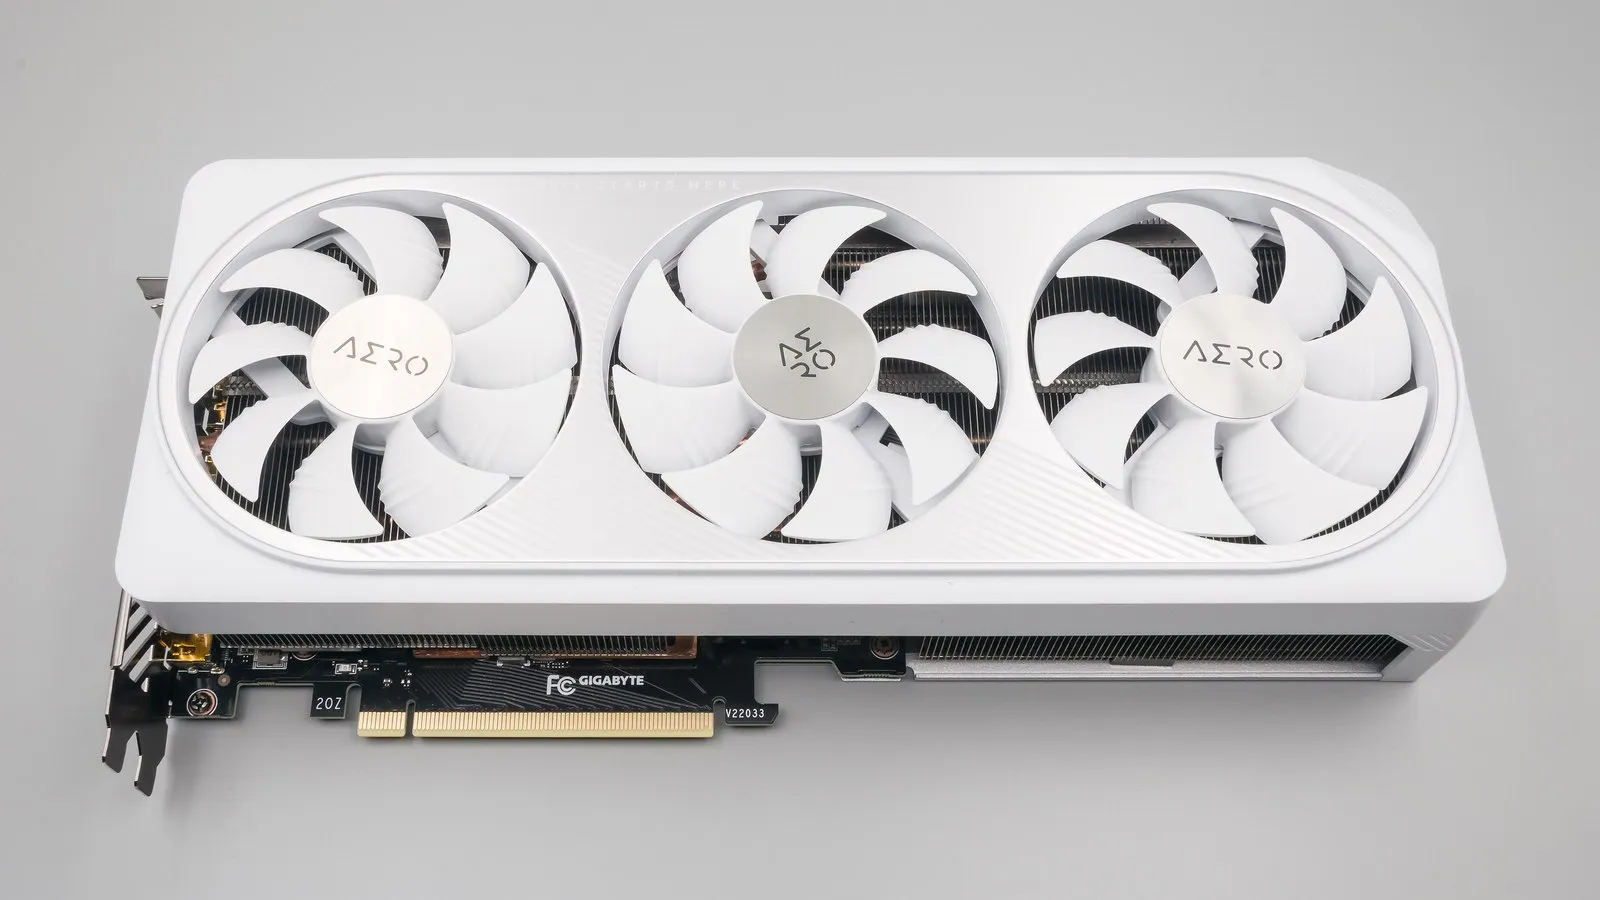
PrismML publicó Ternary Bonsai 2 27B el 17 de septiembre bajo una licencia Apache 2.0. Utiliza pesos ternarios con escalado por grupos en FP16 para reducir el modelo a 5,93 GB, frente a los 53,8 GB del mismo modelo en FP16, mientras que PrismML afirma que conserva el 98,2 % de la puntuación media del modelo original Qwen3.8-27B en 20 pruebas de referencia. La compañía informa de hasta 143 tokens por segundo en una RTX 5090. Un proyecto comunitario independiente, también con licencia Apache 2.0, ajustó el rendimiento de decodificación específicamente para la RTX 3060 de 12 GB —descrita en sus propias pruebas como la GPU de sobremesa más común en la encuesta de hardware de Steam de agosto de 2026, con una cuota de poco menos del 4 %— y midió una mejora de la velocidad de decodificación de hasta 1,53 veces en longitudes de contexto cortas.
Inco AI publicó Splash como un motor de inferencia de código abierto exclusivo para Apple Silicon, especializado en dos modelos concretos —Qwen3.8-27B y Qwen3.6-35B-A3B— en lugar de estar construido como un servidor de modelos de propósito general. Inco informa de unos 144 tokens por segundo ejecutando Qwen3.8-27B en un MacBook Pro con M5 Max, lo que según afirma supone hasta tres veces la velocidad de decodificación de Ollama y el doble que MLX en sus propias comparaciones. El motor requiere un chip Apple M3 o posterior y al menos 36 GB de memoria unificada, e Inco afirma que se integró en la versión Bionic de LM Studio esa misma semana.
Ambos conjuntos de cifras proceden del fabricante o de las propias pruebas del proyecto, no de una auditoría independiente, y una buena demostración en una única GPU de sobremesa o en un MacBook no es el mismo problema que ejecutar inferencia aislada por inquilino para muchos clientes a la vez. Lo que sí demuestra esta combinación es que el hardware de consumo está cerrando la brecha en cargas de trabajo que antes requerían un bastidor; es algo que merece la pena seguir para casos piloto y de borde, pero todavía no sustituye a una plataforma alojada y multiinquilino.
Fuentes: MarkTechPost, Inco AI.