






















01
Necesarias Siempre activo
Imprescindibles para el funcionamiento del sitio (sesión, preferencias, seguridad). Siempre activas.
Los anuncios de IA local de NVIDIA desde la perspectiva de una pyme: memoria, rendimiento, costes y datos que revisar antes de comprar o desplegar agentes.
La IA local protagoniza el anuncio de NVIDIA del 3 de septiembre de 2026 en IFA, que presenta modelos de pesos abiertos y herramientas para RTX, DGX Spark y Jetson, incluido Nemotron 3.5 Lightning de 30.000 millones de parámetros. Este análisis, actualizado el 28 de octubre, distingue las características anunciadas por el fabricante de las comprobaciones necesarias para una pyme o un MSP antes de comprar hardware o conectar un agente a datos empresariales.
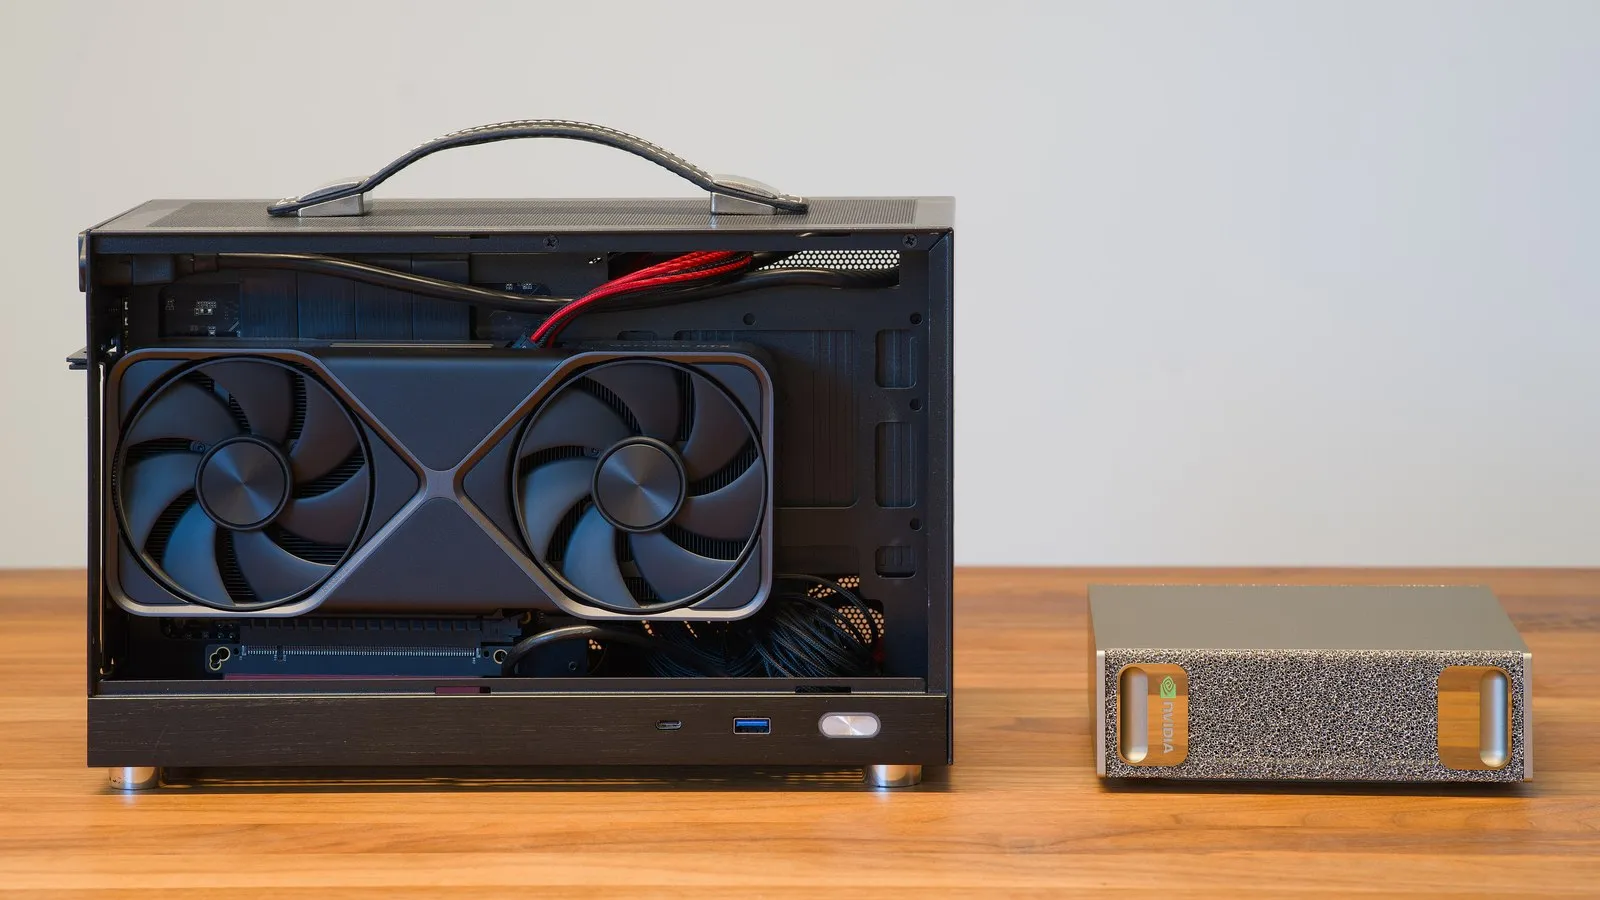
NVIDIA no es la única fuente de estos modelos. Qwen lanzó Qwen3.8-Flash-Next, un modelo multimodal de mezcla de expertos y pesos abiertos para DGX Spark y DGX Station, junto con un Qwen3.8-27B más pequeño ajustado para tareas locales de agentes y programación. Muse Glimmer, de Meta, un modelo de pesos abiertos de 30.000 millones de parámetros para programación y agentes, se ejecuta en PC RTX, DGX Spark, DGX Station y Jetson. DeepSeek v4 Flash, un modelo de mezcla de expertos de 284.000 millones de parámetros con 13.000 millones de parámetros activos, está dimensionado para ejecutarse en un clúster DGX Spark de dos nodos, y el modelo de generación de vídeo LTX 2.5 de LTX apunta a las GPU RTX y al hardware DGX con nuevas optimizaciones de eficiencia de memoria.
NVIDIA también señaló la llegada de PC con Windows RTX Spark de Lenovo y Acer, construidos en torno a una GPU RTX Blackwell de 1 petaflop con hasta 128 GB de memoria unificada, dirigidos a desarrolladores que quieren inferencia local de nivel de estación de trabajo en formato PC. Para gestionar la inferencia en más de una máquina, NVIDIA presentó PAIR (Personal AI Router), una herramienta que distribuye cargas de trabajo de IA entre PC conectados en red y que funciona con las GPU GeForce RTX serie 20 y posteriores.
Las promesas de facilidad de uso y velocidad siguen siendo afirmaciones del fabricante, no mediciones realizadas por Altovar. Las fechas de lanzamiento citadas corresponden al comunicado del 3 de septiembre: hay que comprobar directamente la disponibilidad, el soporte del sistema operativo y la compatibilidad de cada configuración antes de comprar. No presentamos rumores como hechos ni deducimos la memoria necesaria solo del número de parámetros.
La propuesta es reducir la fricción para ejecutar modelos en local: NVIDIA afirma que las aplicaciones de agentes populares creadas sobre llama.cpp tendrán una configuración local simplificada con un clic en Windows, lo que elimina parte del trabajo manual de elegir un modelo, encontrar un servidor de inferencia compatible y ajustar la configuración de cuantización. Para las organizaciones con restricciones de residencia de datos o latencia, esto reduce la barrera para ejecutar modelos capaces en las instalaciones o en el extremo de la red en lugar de depender de un proveedor de IA en la nube, aunque los compradores deberían validar de todos modos su propio rendimiento y coste total de propiedad en lugar de tomar las cifras de rendimiento de NVIDIA como una garantía.
Antes de una prueba, elige una tarea acotada, como buscar información en documentos de prueba o preparar un cambio de código. Registra modelo, cuantización, memoria disponible, longitud del contexto y número de peticiones simultáneas. Mide el tiempo hasta la primera respuesta útil y hasta el trabajo terminado, incluidos errores y revisión. Una demostración con una petición no acredita que la máquina pueda atender a toda una oficina. Frente a las API, incluye compra, electricidad, mantenimiento, actualizaciones y horas de gestión: no tener una factura por token no convierte el servicio en gratuito.
Comprueba por separado el recorrido de los datos. Ejecutar un modelo en el PC no garantiza que conectores, telemetría, búsquedas web o peticiones dirigidas a un modelo remoto permanezcan en el dispositivo. Prueba el flujo con datos sintéticos, limita los permisos de las herramientas y comprueba qué ocurre si falla la red o una máquina participante. Un MSP debe separar también archivos y credenciales de sus clientes. La adopción debe partir de un resultado verificable y una responsabilidad operativa clara; los servicios de inteligencia artificial de Altovar ayudan a definir el alcance y los criterios de evaluación antes de seleccionar las herramientas.
Fuentes: NVIDIA Blog.