





















01
Nödvändiga Alltid på
Krävs för att webbplatsen ska fungera (inloggning, inställningar, säkerhet). Alltid på.
Runware säger att produkten Serverless är tillgänglig: kunder kan köra egen kod, egna modeller och containrar på företagets GPU:er. Rubrikpriset 0,63 dollar per GPU-timme är ett reserverat pris med åtagande; on demand börjar på 1,60 dollar per GPU-timme på L40S.
Runware meddelade den 2 oktober 2026, i ett lanseringsinlägg av Ryan Kerry (runware.ai/blog/runware-serverless-now-available), att produkten Serverless är tillgänglig. Kunder kan köra egen kod, egna modeller och containrar på GPU-infrastrukturen bakom företagets Model APIs, med workers som skalar ned till noll när de är inaktiva. Ett förbehåll direkt: rubriken säger ”från 0,63 dollar per GPU-timme” (vår översättning), men det priset gäller reserverad kapacitet på RTX PRO 6000, med pris och åtagande som avtalas per driftsättning. On demand börjar på 1,60 dollar per GPU-timme på L40S, debiterat per sekund på delad kapacitet.
Inlägget hävdar också ”beräkningskraft till halva priset jämfört med ett neomoln” (vår översättning), något det inte belägger och som vi inte har verifierat. Tillkännagivandet säger inte var arbetslaster körs eller vilka villkor för datalokalisering som gäller. För en leverantör som hostar kunders finjusterade eller privata modeller kan nedskalning till noll slå en ständigt påslagen GPU i kostnad för tomgång. Men avtalsfrågan är kapacitet, inte rubrikpriset, eftersom Runware själv säger att en varm worker inte är en reservation.
Resten av artikeln går igenom vad som lanserades, hur debiteringen fungerar, vad kapacitet betyder, frågorna om datalokalisering och vad den här nyheten inte är.
Allt i det här avsnittet kommer från Runwares inlägg den 2 oktober 2026. Produkten låter kunder köra egen kod, egna modeller eller containrar i den GPU-pool som betjänar Runwares Model APIs. Runware sköter schemaläggning, workers livscykel, skalning, körning och mätning; kunden styr kod, beroenden och beräkningskrav.
Det finns två vägar in: en Python-kodbas som Runware paketerar och bygger, eller en egen container när körmiljö och beroenden måste vara låsta (inlägget nämner att behålla CUDA-versioner och bibliotek). Jobbmodellen är asynkron: du skickar in ett jobb, det schemaläggs mot appens worker-pool och du hämtar resultatet. Runware beskriver det inte som en synkron slutpunkt med låg latens.
Workers har 1, 2, 4 eller 8 GPU:er, där GPU-typ och kapacitet tillåter det. Arbetslasten måste själv fördela sig över GPU:erna; inlägget säger rakt ut att fyra GPU:er inte gör kod skriven för en GPU fyra gånger snabbare. Enligt Runware rymmer dess Sonic Pods omkring 1 200 GPU:er i en 20-fotscontainer med vätskekylning, och företaget bygger dem själv för att sänka sin kostnad för att leverera beräkningskraft. Vi har inte inspekterat någon.
Observerbarheten omfattar en instrumentpanel med driftsättningar, worker-status, GPU-tilldelning, ködjup, förfrågningar, fel, loggar och kostnad, plus SDK, CLI och API. Skärmbilden av konsolen på sidan är märkt som simulerade data. Produktutbudet på en rad: Model APIs för katalogmodeller, Serverless för din egen arbetslast på en hanterad plattform, Runware Compute för direkt åtkomst till maskiner.
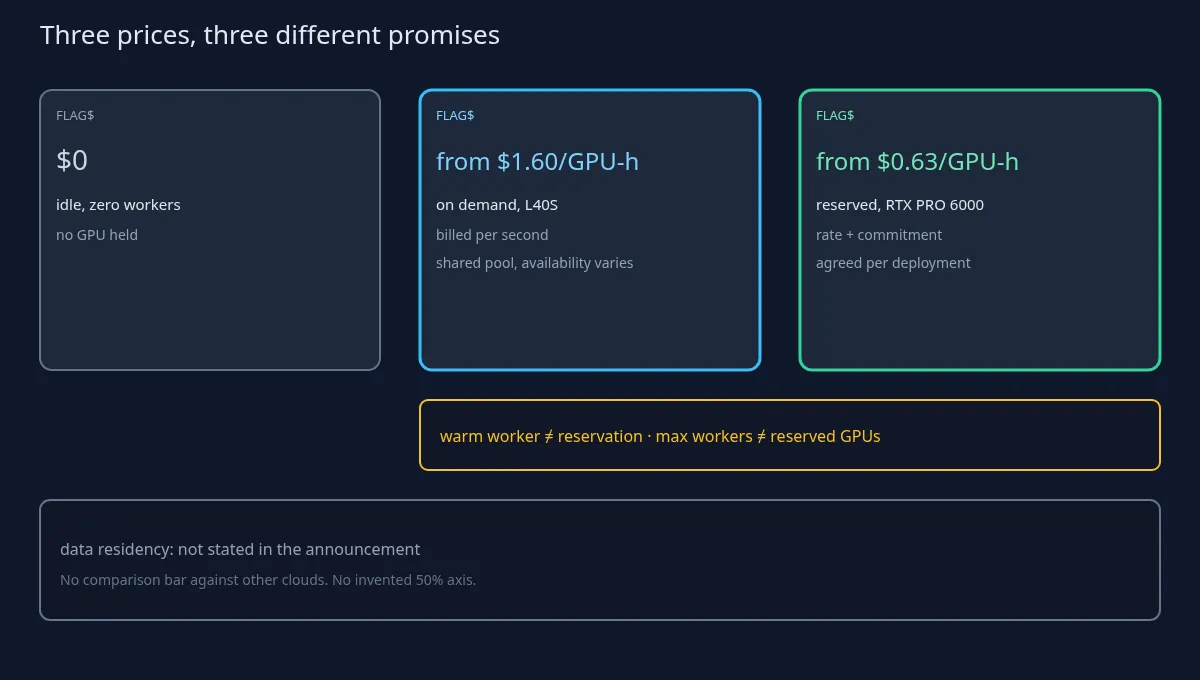
Ställ upp de tre siffrorna bredvid varandra och blanda inte ihop dem. Alla tre är leverantörens listpriser. 0 dollar i beräkningskostnad vid tomgång med noll workers. Från 1,60 dollar/GPU-timme on demand (L40S), debitering per sekund, inget långsiktigt åtagande, delad kapacitet. Från 0,63 dollar/GPU-timme reserverat (RTX PRO 6000), pris och åtagande avtalas per driftsättning. ”Från” betyder ett golv för en GPU-typ; priserna varierar med hårdvaran.
Rubrikproblemet i en mening: sidans titel och första rad leder med 0,63 dollar, vilket är golvet för reserverad kapacitet. Den som bara ser titeln kommer att prissätta en on demand-arbetslast till mindre än hälften av dess verkliga startpris.
”Halva priset jämfört med ett neomoln” är leverantörens påstående. Inlägget anger ingen grund för jämförelsen: vilket neomoln, vilken GPU, vilken utnyttjandegrad, vilken period. Vi har inte verifierat det, och den här artikeln räknar inte fram någon egen procentsats.
Debiteringsdetaljer som en MSP bör uppmärksamma, alla från inlägget: on demand-kostnaden löper från det ögonblick en worker håller en GPU tills den släpper den, inklusive modellinläsning efter tilldelning och varm tomgångstid mellan jobb. Debiteras inte: väntan på kapacitet, hämtning av avbilden före tilldelning och återställning efter ett plattformsfel på Runwares sida. Workers med flera GPU:er debiteras för varje tilldelad GPU. Om genomströmning hävdar inlägget att timpriset ensamt inte visar vad en arbetslast kostar, eftersom arbetet per GPU-timme varierar. Det stämmer i allmänhet och betyder också att inget av dessa priser kan räknas om till en kostnad per förfrågan. Inlägget har ingen TCO-tabell, inga besparingssiffror från kunder och ingen jämförelse med namngivna hyperskalare.
Runwares egen poäng, återgiven med andra ord: att hålla en worker varm kostar pengar och utgör ingen kapacitetsreservation. Varma workers hjälper latensen; en reservation säkrar en avtalad mängd GPU-kapacitet. Det är olika löften, och att blanda ihop dem är hur ett SLA skrivs mot fel kontroll.
Inställningen för maximalt antal workers, också enligt inlägget, begränsar antalet workers och reserverar inte de GPU:erna i den delade poolen. Uppskalning on demand sker ”beroende på GPU-tillgång” (vår översättning), och jobb väntar i kön när kapaciteten inte finns. Workers med flera GPU:er behöver flera lediga GPU:er samtidigt och kan ta längre tid att placera när poolen är upptagen. Inläggets egen lösning är att reservera en baskapacitet.
Kallstarter: Runware säger att företaget har byggt startoptimeringar och beständiga volymer för vikter och cacheminnen, och att starttiderna ändå varierar med modellstorlek, körmiljö, tillgång och konfiguration. Det finns inga publicerade siffror för kallstarter, och den här artikeln uppskattar inga.
För en MSP betyder det: om ett kundavtal utlovar en svarstid är on demand-poolen plus en varm worker, enligt leverantörens egen beskrivning, ingen kapacitetsgaranti. Garantin är den reserverade baskapaciteten, prissatt och avtalad per driftsättning. Det är en avtalsfråga, inte kritik. Frågor till beställningsformuläret: storlek och GPU-typ för den reserverade baskapaciteten; vad som händer med köade jobb när efterfrågan överstiger reservationen; och om återställning efter plattformsfel ger någon servicekredit (inlägget säger att återställning inte debiteras; det nämner inte krediter eller något SLA).
Först luckan: lanseringsinlägget anger inga regioner, ingen datalokalisering, inga villkor för databehandling, inga underbiträden och inga lagringstider för loggar och jobbdata. Vi fyller inte i något av detta, och beskrivningen av Sonic Pods avslöjar inte heller någon region.
Varför det spelar roll för en MSP som hostar en kunds finjusterade eller privata modell: vikterna, jobbens indata, utdata och loggarna i instrumentpanelen är alla kunddata eller härledda från dem. En egen container behåller kontrollen över körmiljön; den säger i sig inte var GPU:erna står eller vem som kan se volymerna.
Frågor att ställa till Runware innan en kunds arbetslast läggs där, som frågor och inte som anklagelser: var körs workers och beständiga volymer fysiskt; kan en driftsättning låsas till en region; hur länge sparas jobbdata, resultat och loggar; vilka är underbiträdena; hur skickas hemligheter till containrar; vad händer med volymer när en app raderas.
Behandla API-nycklar och inloggningsuppgifter till modellregistret för den här plattformen som vilken annan produktionshemlighet som helst: valv, rotation, minsta behörighet. Sidan gör inga påståenden om suveränt moln, certifiering eller jurisdiktion, och det gör inte den här artikeln heller.
Det här är inte Prime Inference, ett annat inferenserbjudande, och här finns ingen jämförelsetabell. Det är inte heller Nebius och Inferize, ett förvärv inriktat på kallstarter inom Nebius Token Factory; den affären är en annan nyhet.
Det här är inte Cloudflare Web Search: det är en sökprodukt, inte GPU-beräkning. Det är varken en modellansering eller en chippnyhet: Runware Serverless är ett beräkningslager för dina egna arbetslaster. Inga modellbenchmarks, inga färdplaner för acceleratorer.
Kort sagt, de enda priser sidan stöder, alla leverantörens listpriser: 0 dollar i beräkningskostnad vid tomgång med noll workers; on demand från 1,60 dollar/GPU-timme på L40S, med debitering per sekund på delad kapacitet; reserverat från 0,63 dollar/GPU-timme på RTX PRO 6000, med åtagande som avtalas per driftsättning. ”Halva priset jämfört med ett neomoln” är ett overifierat påstående från leverantören. Påståenden om kallstarter och genomströmning saknar offentliga benchmarks. Tillkännagivandet anger inte datalokalisering.
Innan ni skriver på: få den reserverade baskapaciteten, köbeteendet över den och svaren om datalokalisering skriftligt. Räkna fram till dess med on demand-priset, inte med rubrikpriset.