





















01
Necesare Mereu activ
Indispensabile pentru funcționarea site-ului (autentificare, preferințe, securitate). Mereu active.
Modelul ternar Bonsai 2 27B de la PrismML încape în 5,9 GB și rulează pe GPU-uri de consum; motorul Splash de la Inco AI este construit special pentru Apple Silicon. Ambele au fost testate de producători, nu auditate independent.
Luna aceasta au apărut două lansări pentru inferență locală la câteva zile distanță: Ternary Bonsai 2 27B de la PrismML, un model puternic comprimat destinat GPU-urilor de consum, și Splash de la Inco AI, un motor de inferență construit special pentru Apple Silicon.
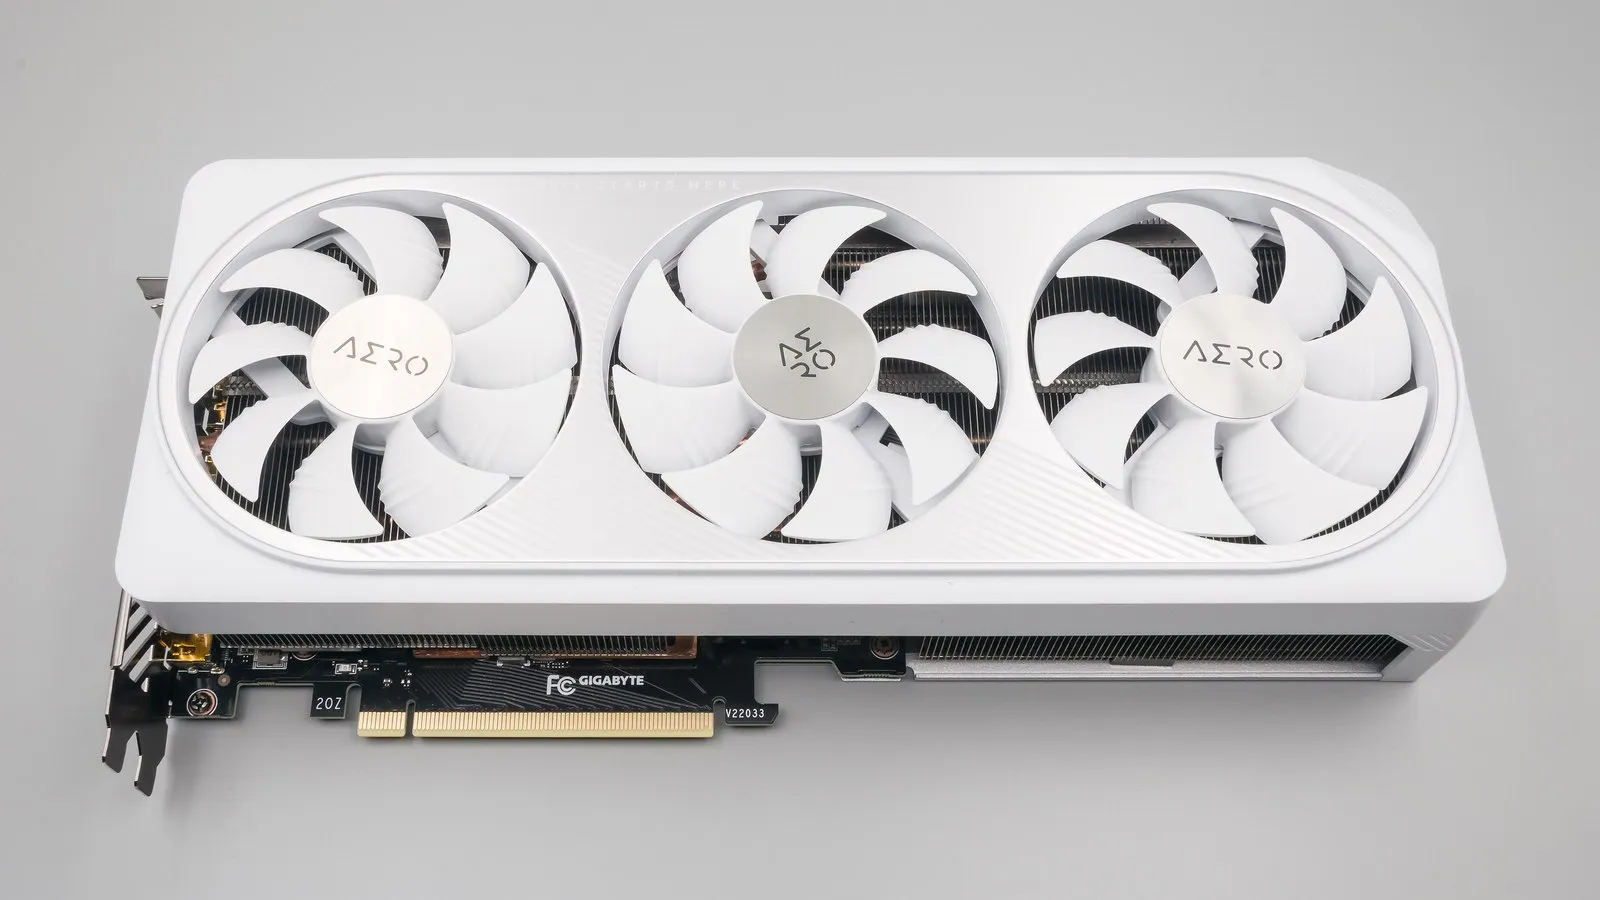
PrismML a lansat Ternary Bonsai 2 27B pe 17 septembrie sub licență Apache 2.0. Modelul folosește ponderi ternare cu scalare FP16 pe grupuri pentru a-l comprima la 5,93 GB, față de 53,8 GB pentru același model în FP16, iar PrismML afirmă că păstrează 98,2% din scorul mediu al modelului părinte Qwen3.8-27B în 20 de benchmarkuri. Compania raportează până la 143 de tokeni pe secundă pe un RTX 5090. Un proiect comunitar separat, licențiat tot sub Apache 2.0, a optimizat performanța de decodare special pentru RTX 3060 12GB -- descris în propriile teste comparative drept cel mai răspândit GPU desktop din sondajul hardware Steam din august 2026, cu o cotă de puțin sub 4% -- și a măsurat o îmbunătățire a vitezei de decodare de până la 1,53x la lungimi scurte de context.
Inco AI a lansat Splash ca motor de inferență open-source, destinat exclusiv Apple Silicon și specializat pentru două modele anume, Qwen3.8-27B și Qwen3.6-35B-A3B, nu ca server de modele de uz general. Inco raportează aproximativ 144 de tokeni pe secundă rulând Qwen3.8-27B pe un MacBook Pro M5 Max, ceea ce, potrivit companiei, înseamnă o viteză de decodare de până la trei ori mai mare decât cea a Ollama și de două ori mai mare decât cea a MLX în propriile comparații. Motorul necesită un cip Apple M3 sau mai nou și cel puțin 36 GB de memorie unificată, iar Inco spune că a fost integrat în versiunea Bionic a LM Studio în aceeași săptămână.
Ambele seturi de cifre provin din testele comparative ale producătorului sau ale proiectului, nu dintr-un audit independent, iar o demonstrație convingătoare pe un singur GPU desktop sau MacBook nu este aceeași problemă cu rularea inferenței izolate pe tenant pentru mulți clienți simultan. Ceea ce arată această pereche este că hardware-ul de consum reduce decalajul față de sarcinile care înainte necesitau un rack -- merită urmărit pentru scenarii pilot și edge, dar nu este încă un substitut pentru o platformă găzduită multi-tenant.
Surse: MarkTechPost, Inco AI.