






















01
Necesare Mereu activ
Indispensabile pentru funcționarea site-ului (autentificare, preferințe, securitate). Mereu active.
Anunțurile NVIDIA despre AI locală văzute de o firmă: memorie, performanță, costuri și traseul datelor de verificat înainte de cumpărare sau implementare.
AI locală este tema anunțului NVIDIA de la IFA din 3 septembrie 2026, cu modele cu ponderi deschise și instrumente pentru RTX, DGX Spark și Jetson, inclusiv Nemotron 3.5 Lightning cu 30 de miliarde de parametri. Această analiză, actualizată la 28 octombrie, separă caracteristicile anunțate de verificările necesare unui IMM sau MSP înainte de cumpărarea echipamentelor ori conectarea unui agent la datele firmei.
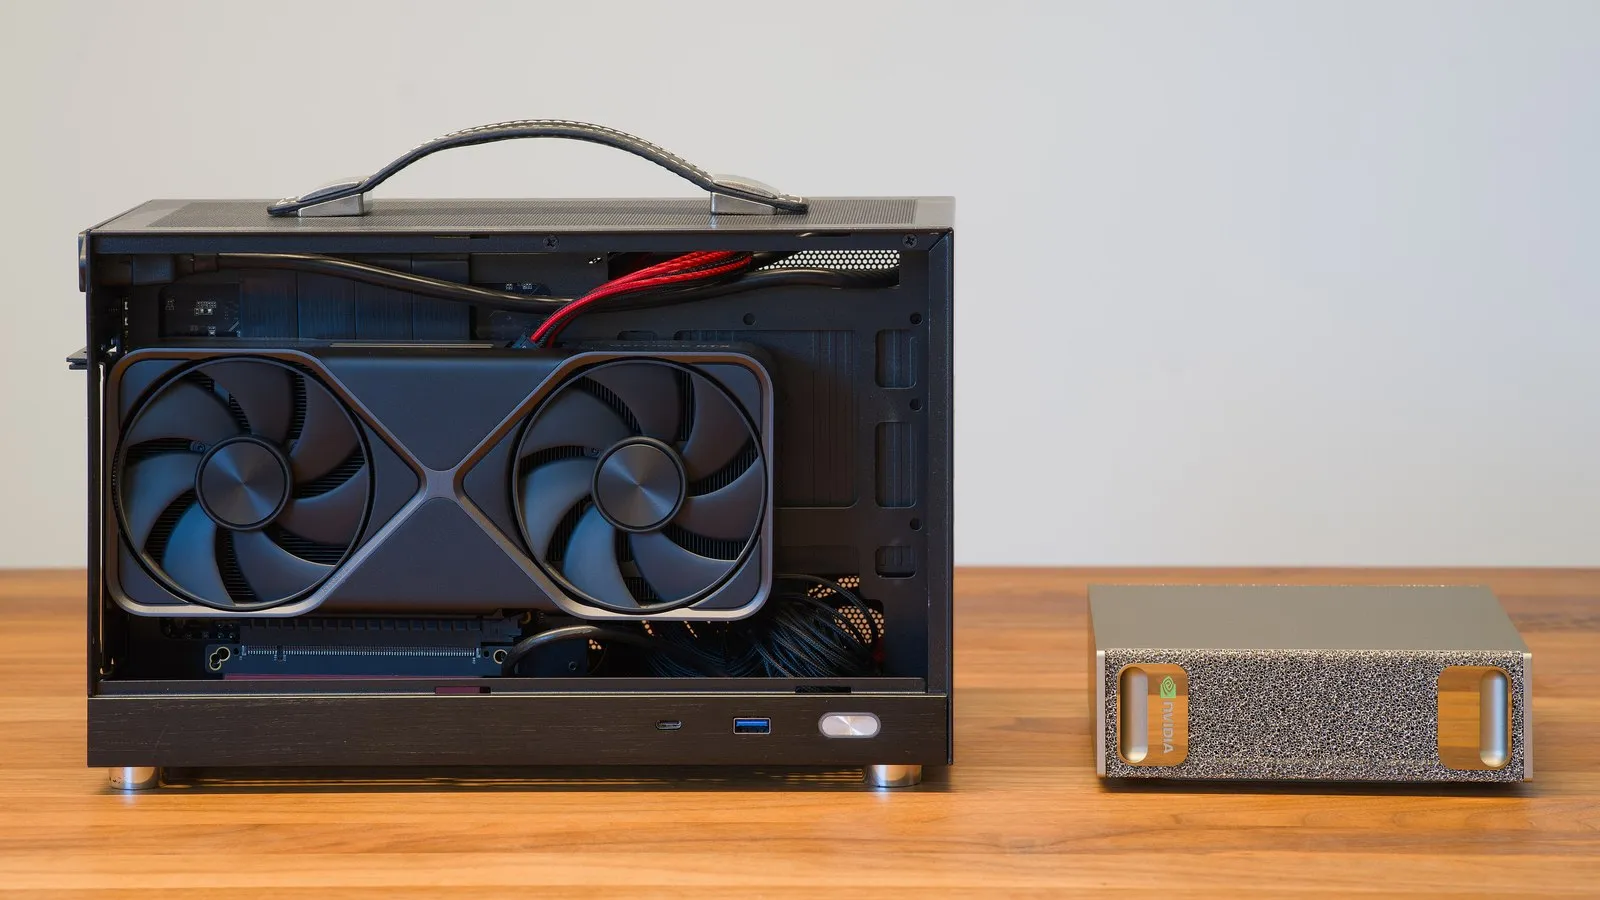
NVIDIA nu este singura sursă a modelelor de aici. Qwen a lansat Qwen3.8-Flash-Next, un model multimodal mixture-of-experts cu greutate deschisă pentru DGX Spark și DGX Station, alături de un Qwen3.8-27B mai mic ajustat pentru lucrări agentice și de codare locale. Muse Glimmer de la Meta, un model de codare și agent cu 30 de miliarde de parametri și greutate deschisă, rulează pe PC-uri RTX, DGX Spark, DGX Station și Jetson. v4 Flash de la DeepSeek, un model mixture-of-experts cu 284 de miliarde de parametri și 13 miliarde de parametri activi, este dimensionat pentru a rula pe un cluster DGX Spark cu două noduri, iar modelul de generare video LTX 2.5 de la LTX vizează GPU-uri RTX și hardware DGX cu noi optimizări de eficiență a memoriei.
NVIDIA a indicat, de asemenea, PC-uri Windows RTX Spark care sosesc de la Lenovo și Acer, construite în jurul unui GPU RTX Blackwell de 1 petaflop cu până la 128 GB de memorie unificată — destinate dezvoltatorilor care doresc inferență locală de clasă stație de lucru într-un factor de formă PC. Pentru a gestiona inferența pe mai multe mașini, NVIDIA a introdus PAIR (Personal AI Router), un instrument care distribuie sarcinile de lucru AI pe PC-uri în rețea, funcționând cu GPU-uri GeForce RTX seria 20 și mai noi.
Promisiunile de simplitate și viteză rămân declarații ale producătorului, nu măsurători realizate de Altovar. Termenele citate se referă la comunicatul din 3 septembrie: disponibilitatea, suportul sistemului de operare și compatibilitatea configurației trebuie verificate direct înainte de cumpărare. Nu prezentăm zvonuri ca fapte și nu deducem memoria necesară doar din numărul de parametri.
Avantajul este o fricțiune mai mică pentru rularea modelelor local: NVIDIA spune că aplicațiile agent populare construite pe llama.cpp vor primi o configurare locală simplificată cu un singur clic pe Windows, eliminând o parte din munca manuală de alegere a unui model, găsirea unui server de inferență compatibil și ajustarea setărilor de cuantizare. Pentru organizațiile cu constrângeri de rezidență a datelor sau latență, aceasta scade pragul pentru rularea modelelor capabile on-premises sau la margine în loc să depindă de un furnizor cloud AI — deși cumpărătorii ar trebui să își valideze în continuare propriile performanțe și costul total de proprietate în loc să ia cifrele de debit ale NVIDIA ca garanție.
Înainte de test, alege o sarcină delimitată, precum căutarea unor informații în documente de test sau pregătirea unei modificări de cod. Înregistrează modelul, cuantizarea, memoria disponibilă, lungimea contextului și numărul de cereri simultane. Măsoară timpul până la primul răspuns util și până la finalizarea muncii, inclusiv erorile și revizuirea. O demonstrație cu o singură cerere nu dovedește că sistemul poate servi un birou întreg. În comparația cu API-urile, include achiziția, energia, întreținerea, actualizările și orele de administrare: lipsa unei facturi per token nu face serviciul gratuit.
Verifică separat traseul datelor. Un model care rulează pe PC nu garantează că și conectorii, telemetria, căutările web sau cererile trimise unui model la distanță rămân pe dispozitiv. Testează fluxul cu date sintetice, limitează permisiunile instrumentelor și verifică efectele pierderii rețelei ori indisponibilității unui calculator. Un MSP trebuie să separe și arhivele și acreditările clienților. Adoptarea trebuie să pornească de la un rezultat verificabil și o responsabilitate operațională clară; serviciile de inteligență artificială Altovar ajută la definirea domeniului, a revizuirii și a criteriilor de evaluare înainte de alegerea instrumentelor.
Surse: NVIDIA Blog.