





















01
Noodzakelijk Altijd aan
Nodig voor de werking van de site (login, voorkeuren, beveiliging). Altijd aan.
Volgens Runware is zijn product Serverless beschikbaar: klanten kunnen hun eigen code, modellen en containers op zijn GPU’s draaien. De $0,63 per GPU-uur uit de kop is een gereserveerd tarief met verbintenis; on demand begint bij $1,60 per GPU-uur op L40S.
Runware maakte op 2 oktober 2026 in een lanceringsbericht van Ryan Kerry (runware.ai/blog/runware-serverless-now-available) bekend dat zijn product Serverless beschikbaar is. Klanten kunnen hun eigen code, modellen en containers draaien op de GPU-infrastructuur achter de Model API’s van het bedrijf, met workers die bij inactiviteit naar nul schalen. Eén kanttekening vooraf: de kop zegt “vanaf $0,63 per GPU-uur” (onze vertaling), maar dat tarief geldt voor gereserveerde capaciteit op RTX PRO 6000, met tarief en verbintenis die per deployment worden afgesproken. On demand begint bij $1,60 per GPU-uur op L40S, per seconde gefactureerd op gedeelde capaciteit.
Het bericht claimt ook “rekenkracht voor de helft van de prijs van een neocloud” (onze vertaling), maar onderbouwt dat niet, en wij hebben het niet geverifieerd. De aankondiging zegt niet waar workloads draaien of welke voorwaarden voor dataresidentie gelden. Voor een provider die fine-tunes of privémodellen van klanten host, kan schalen naar nul goedkoper zijn dan een GPU die altijd aanstaat. Maar de contractvraag is capaciteit, niet het kopbedrag, want Runware zegt zelf dat een warme worker geen reservering is.
De rest van dit stuk behandelt wat er is gelanceerd, hoe de facturering werkt, wat capaciteit betekent, de vragen over dataresidentie en wat dit nieuws niet is.
Alles in deze sectie komt uit het bericht van Runware van 2 oktober 2026. Met het product kunnen klanten hun eigen code, modellen of containers draaien op de GPU-pool die de Model API’s van Runware bedient. Runware regelt scheduling, de levenscyclus van workers, schaling, uitvoering en verbruiksmeting; de klant bepaalt code, afhankelijkheden en rekenvereisten.
Er zijn twee ingangen: een Python-codebase die Runware verpakt en bouwt, of een eigen container van de klant wanneer runtime en afhankelijkheden vast moeten liggen (het bericht noemt het behouden van CUDA-versies en bibliotheken). Het jobmodel is asynchroon: je dient een job in, die wordt ingepland op de workerpool van de app, en je haalt het resultaat op. Runware beschrijft het niet als een synchroon endpoint met lage latentie.
Workers hebben 1, 2, 4 of 8 GPU’s, voor zover het GPU-type en de capaciteit dat toelaten. De workload moet zichzelf over de GPU’s verdelen; het bericht zegt duidelijk dat vier GPU’s kiezen code voor één GPU niet vier keer zo snel maakt. Volgens Runware bevatten zijn Sonic Pods ongeveer 1.200 GPU’s in een container van 20 voet met vloeistofkoeling, en bouwt het bedrijf ze zelf om zijn kosten voor het leveren van rekenkracht te verlagen. Wij hebben er geen geïnspecteerd.
Observability omvat een dashboard met deployments, workerstatus, GPU-toewijzing, wachtrijdiepte, verzoeken, fouten, logs en kosten, plus een SDK, een CLI en een API. De consoleschermafbeelding op de pagina is aangeduid als gesimuleerde data. Het productaanbod in één regel: Model API’s voor catalogusmodellen, Serverless voor je eigen workload op een beheerd platform, Runware Compute voor directe toegang tot machines.
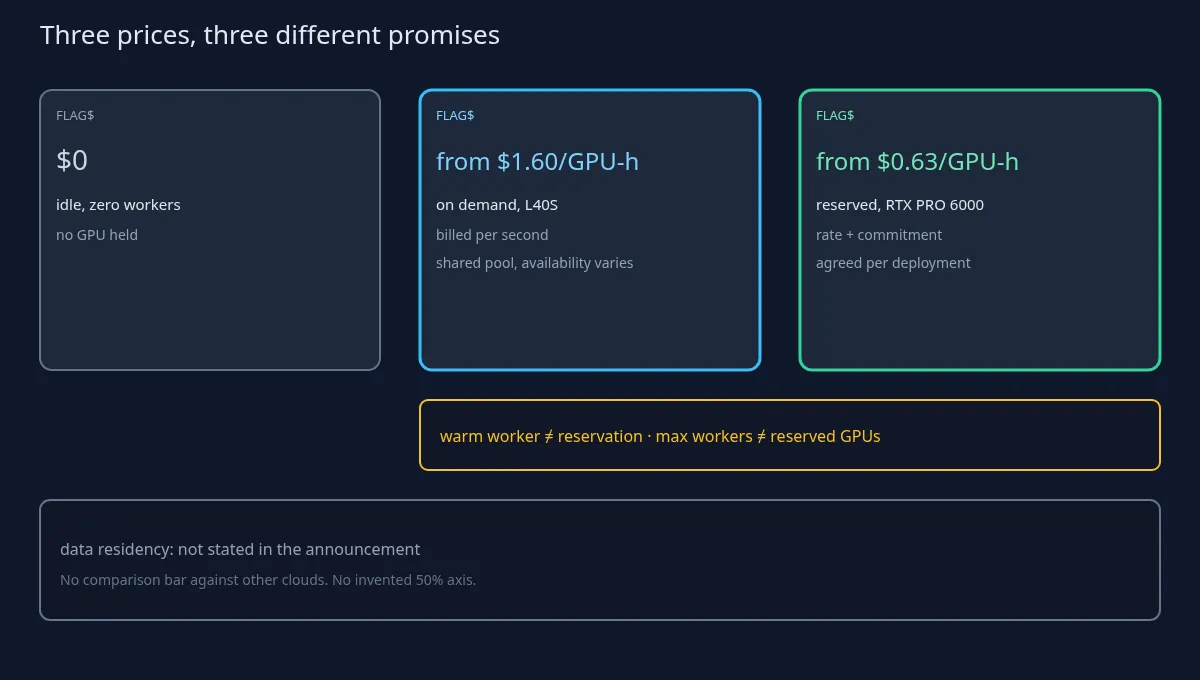
Zet de drie bedragen naast elkaar en meng ze niet. Alle drie zijn catalogusprijzen van de leverancier. $0 rekenkosten bij inactiviteit met nul workers. Vanaf $1,60/GPU-uur on demand (L40S), facturering per seconde, geen langetermijnverbintenis, gedeelde capaciteit. Vanaf $0,63/GPU-uur gereserveerd (RTX PRO 6000), tarief en verbintenis per deployment afgesproken. “Vanaf” betekent een ondergrens voor één GPU-type; tarieven verschillen per hardware.
Het probleem met de kop in één zin: de paginatitel en de eerste regel openen met $0,63, en dat is de ondergrens voor reserveringen. Wie alleen de titel ziet, begroot een on-demand-workload op minder dan de helft van het werkelijke starttarief.
“De helft van de prijs van een neocloud” is een claim van de leverancier. Het bericht geeft geen basis voor de vergelijking: welke neocloud, welke GPU, welke bezettingsgraad, welke periode. Wij hebben de claim niet geverifieerd, en dit artikel berekent geen eigen percentage.
Factureringsdetails die de aandacht van een MSP verdienen, allemaal uit het bericht: on-demandkosten lopen vanaf het moment dat een worker een GPU vasthoudt tot hij die vrijgeeft, inclusief het laden van het model na toewijzing en warme inactieve tijd tussen jobs. Niet gefactureerd: wachten op capaciteit, het ophalen van de image vóór toewijzing en herstel na een platformstoring aan de kant van Runware. Multi-GPU-workers worden gefactureerd voor elke toegewezen GPU. Over doorvoer stelt het bericht dat het uurtarief alleen niet laat zien wat een workload kost, omdat het werk per GPU-uur varieert. Dat klopt in het algemeen, en het betekent ook dat geen van deze prijzen kan worden omgerekend naar kosten per verzoek. Het bericht bevat geen TCO-tabel, geen besparingscijfers van klanten en geen vergelijking met bij naam genoemde hyperscalers.
Het punt van Runware zelf, in eigen woorden: een worker warm houden kost geld en is geen capaciteitsreservering. Warme workers helpen bij latentie; een reservering zekert een afgesproken hoeveelheid GPU-capaciteit. Dat zijn verschillende beloften, en wie ze door elkaar haalt, schrijft een SLA tegen de verkeerde maatregel.
De instelling voor het maximale aantal workers, ook volgens het bericht, begrenst het aantal workers en reserveert die GPU’s niet in de gedeelde pool. On-demand opschalen gebeurt “afhankelijk van de beschikbaarheid van GPU’s” (onze vertaling), en jobs wachten in de wachtrij als er geen capaciteit is. Multi-GPU-workers hebben meerdere vrije GPU’s tegelijk nodig en kunnen langer op plaatsing wachten als de pool druk is. De oplossing die het bericht zelf noemt, is een basiscapaciteit reserveren.
Koude starts: Runware zegt dat het startoptimalisaties en persistente volumes voor gewichten en caches heeft gebouwd, en dat starttijden toch variëren met modelgrootte, runtime, beschikbaarheid en configuratie. Er zijn geen gepubliceerde cijfers over koude starts, en dit artikel schat er geen.
Voor een MSP betekent dat: als een klantcontract een responstijd belooft, zijn de on-demandpool plus een warme worker volgens de eigen beschrijving van de leverancier geen capaciteitsgarantie. De garantie is de gereserveerde basiscapaciteit, geprijsd en vastgelegd per deployment. Dat is een contractvraag, geen kritiek. Vragen voor het bestelformulier: omvang en GPU-type van de gereserveerde basiscapaciteit; wat er met jobs in de wachtrij gebeurt als de vraag de reservering overstijgt; en of herstel na een platformstoring servicecredits oplevert (volgens het bericht wordt herstel niet in rekening gebracht; credits of een SLA worden niet genoemd).
Eerst het gat: het lanceringsbericht noemt geen regio’s, geen dataresidentie, geen voorwaarden voor gegevensverwerking, geen subverwerkers en geen bewaartermijnen voor logs en jobpayloads. Wij vullen geen van die punten in, en de beschrijving van de Sonic Pods verraadt ook geen regio.
Waarom het ertoe doet voor een MSP die de fine-tune of het privémodel van een klant host: de gewichten, de jobinvoer, de uitvoer en de logs in het dashboard zijn allemaal klantdata of daarvan afgeleid. Een eigen container houdt de controle over de runtime; die zegt op zich niet waar de GPU’s staan of wie de volumes kan zien.
Vragen voor Runware voordat er een klantworkload op komt, als vragen en niet als beschuldigingen: waar draaien workers en persistente volumes fysiek; kan een deployment aan een regio worden gebonden; hoe lang worden jobpayloads, resultaten en logs bewaard; wie zijn de subverwerkers; hoe worden secrets aan containers doorgegeven; wat gebeurt er met volumes als een app wordt verwijderd.
Behandel API-sleutels en inloggegevens voor de modelregistry van dit platform als elk ander productiegeheim: vault, rotatie, minimale rechten. De pagina claimt geen soevereine cloud, certificering of jurisdictie, en dit artikel evenmin.
Dit is niet Prime Inference, een ander inferentieaanbod, en er staat hier geen vergelijkingstabel. Het is ook niet Nebius en Inferize, een overname gericht op koude starts binnen Nebius Token Factory; die deal is een ander verhaal.
Dit is niet Cloudflare Web Search: dat is een zoekproduct, geen GPU-rekenkracht. Dit is geen modellancering en geen chipverhaal: Runware Serverless is een rekenlaag voor je eigen workloads. Geen modelbenchmarks, geen roadmaps voor accelerators.
Kortom, de enige prijzen die de pagina onderbouwt, allemaal catalogusprijzen van de leverancier: $0 rekenkosten bij inactiviteit met nul workers; on demand vanaf $1,60/GPU-uur op L40S, met facturering per seconde op gedeelde capaciteit; gereserveerd vanaf $0,63/GPU-uur op RTX PRO 6000, met een per deployment afgesproken verbintenis. “De helft van de prijs van een neocloud” is een niet-geverifieerde claim van de leverancier. Voor uitspraken over koude starts en doorvoer zijn er geen openbare benchmarks. De aankondiging vermeldt geen dataresidentie.
Laat vóór ondertekening de gereserveerde basiscapaciteit, het gedrag van de wachtrij daarboven en de antwoorden over dataresidentie op papier zetten. Reken tot die tijd met het on-demandtarief, niet met het kopbedrag.