






















01
Notwendig Immer aktiv
Erforderlich für den Betrieb der Seite (Login, Einstellungen, Sicherheit). Immer aktiv.
NVIDIAs Ankündigungen zu lokaler KI aus Unternehmenssicht: Speicher, Leistung, Kosten und Datenwege vor dem Hardwarekauf oder dem Einsatz von Agenten prüfen.
Lokale KI steht im Mittelpunkt von NVIDIAs IFA-Ankündigung vom 3. September 2026: Open-Weight-Modelle und Werkzeuge für RTX, DGX Spark und Jetson, darunter Nemotron 3.5 Lightning mit 30 Milliarden Parametern. Diese am 28. Oktober aktualisierte Analyse trennt die Herstellerangaben von den Prüfungen, die ein KMU oder MSP vor dem Hardwarekauf oder dem Zugriff eines Agenten auf Unternehmensdaten durchführen sollte.
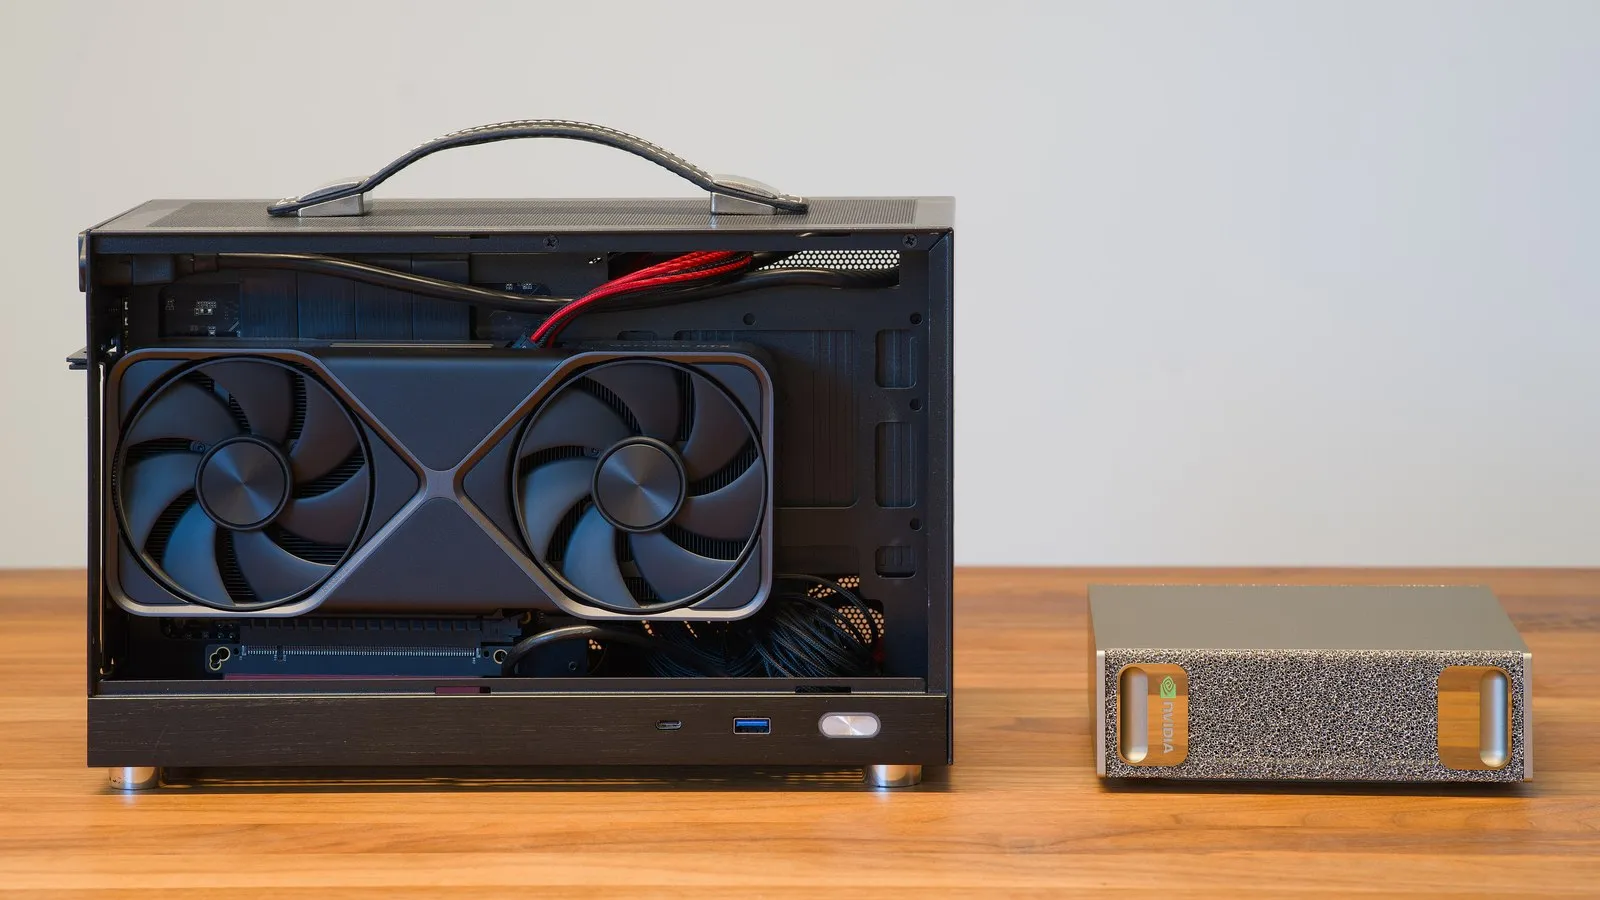
NVIDIA ist hier nicht die einzige Quelle der Modelle. Qwen veröffentlichte Qwen3.8-Flash-Next, ein multimodales Open-Weight-Mixture-of-Experts-Modell für DGX Spark und DGX Station, zusammen mit einem kleineren Qwen3.8-27B, das für lokale agentische und Coding-Aufgaben abgestimmt ist. Metas Muse Glimmer, ein Open-Weight-Coding- und Agentenmodell mit 30 Milliarden Parametern, läuft auf RTX-PCs, DGX Spark, DGX Station und Jetson. DeepSeeks v4 Flash, ein Mixture-of-Experts-Modell mit 284 Milliarden Parametern und 13 Milliarden aktiven Parametern, ist für den Betrieb auf einem DGX-Spark-Cluster mit zwei Knoten ausgelegt, und das Videogenerierungsmodell LTX 2.5 von LTX zielt mit neuen Speichereffizienz-Optimierungen auf RTX-GPUs und DGX-Hardware.
NVIDIA verwies zudem auf Windows-PCs mit RTX Spark von Lenovo und Acer, die auf einer RTX-Blackwell-GPU mit 1 Petaflop und bis zu 128 GB Unified Memory basieren – gedacht für Entwickler, die lokale Inferenz auf Workstation-Niveau in einem PC-Formfaktor wollen. Um Inferenz über mehr als eine Maschine zu verwalten, stellte NVIDIA PAIR (Personal AI Router) vor, ein Tool, das KI-Workloads auf vernetzte PCs verteilt und mit GeForce-RTX-GPUs der 20er-Serie und neuer funktioniert.
Versprechen über einfache Bedienung und Geschwindigkeit bleiben Herstellerangaben, keine von Altovar durchgeführten Messungen. Genannte Starttermine beziehen sich auf die Mitteilung vom 3. September: Verfügbarkeit, Betriebssystemunterstützung und Kompatibilität einer konkreten Konfiguration müssen vor dem Kauf direkt geprüft werden. Gerüchte werden hier nicht als Tatsachen dargestellt; der Speicherbedarf lässt sich nicht allein aus der Parameterzahl ableiten.
Das Versprechen ist weniger Reibung beim lokalen Betrieb von Modellen: NVIDIA zufolge erhalten beliebte Agenten-Apps auf Basis von llama.cpp eine vereinfachte lokale Einrichtung per Ein-Klick unter Windows, wodurch ein Teil der manuellen Arbeit entfällt – das Auswählen eines Modells, das Finden eines kompatiblen Inferenzservers und das Anpassen der Quantisierungseinstellungen. Für Organisationen mit Anforderungen an Datenresidenz oder Latenz senkt das die Hürde, leistungsfähige Modelle on-premises oder an der Edge zu betreiben, statt von einem Cloud-KI-Anbieter abhängig zu sein – auch wenn Einkäufer ihre eigene Leistung und Gesamtbetriebskosten weiterhin selbst validieren sollten, statt NVIDIAs Durchsatzwerte als Garantie zu nehmen.
Vor einem Versuch sollte eine klar begrenzte Aufgabe ausgewählt werden, etwa die Suche in Testdokumenten oder die Vorbereitung einer Codeänderung. Zu erfassen sind Modell, Quantisierung, verfügbarer Speicher, Kontextlänge und gleichzeitige Anfragen. Gemessen werden die Zeit bis zur ersten brauchbaren Antwort und die Zeit bis zum geprüften Abschluss, einschließlich Fehlern und Nacharbeit. Eine Demo mit nur einer Anfrage belegt nicht, dass ein Rechner ein ganzes Büro versorgen kann. Beim Vergleich mit APIs gehören Anschaffung, Strom, Wartung, Updates und Verwaltungsaufwand in die Rechnung: Ohne Token-Rechnung ist ein Dienst noch lange nicht kostenlos.
Die Datenwege sind gesondert zu prüfen. Ein auf dem PC ausgeführtes Modell garantiert nicht, dass auch Konnektoren, Telemetrie, Websuchen oder an entfernte Modelle weitergeleitete Anfragen auf dem Gerät bleiben. Der Ablauf sollte mit synthetischen Daten und eingeschränkten Werkzeugrechten getestet werden. Wichtig ist auch das Verhalten bei einem Netzwerkfehler oder dem Ausfall eines beteiligten Rechners. Ein MSP muss Kundenarchive und Zugangsdaten getrennt halten. Grundlage einer Einführung sind ein überprüfbares Ergebnis und klare Betriebsverantwortung. Die KI-Dienstleistungen von Altovar bieten einen Ausgangspunkt, um Umfang und Kriterien dieser Bewertung vor der Werkzeugauswahl festzulegen.
Quellen: NVIDIA Blog.