





















01
Niezbędne Zawsze włączone
Wymagane do działania strony (logowanie, preferencje, bezpieczeństwo). Zawsze włączone.
Ternary Bonsai 2 27B od PrismML mieści się w 5,9 GB i działa na konsumenckich GPU; silnik Splash od Inco AI powstał z myślą o Apple Silicon. Obie propozycje opierają się na testach dostawców, nie na niezależnym audycie.
Dwa wydania związane z inferencją lokalną pojawiły się w odstępie kilku dni w tym miesiącu: Ternary Bonsai 2 27B od PrismML, mocno skompresowany model przeznaczony dla konsumenckich GPU, oraz Splash od Inco AI, silnik inferencyjny stworzony specjalnie dla Apple Silicon.
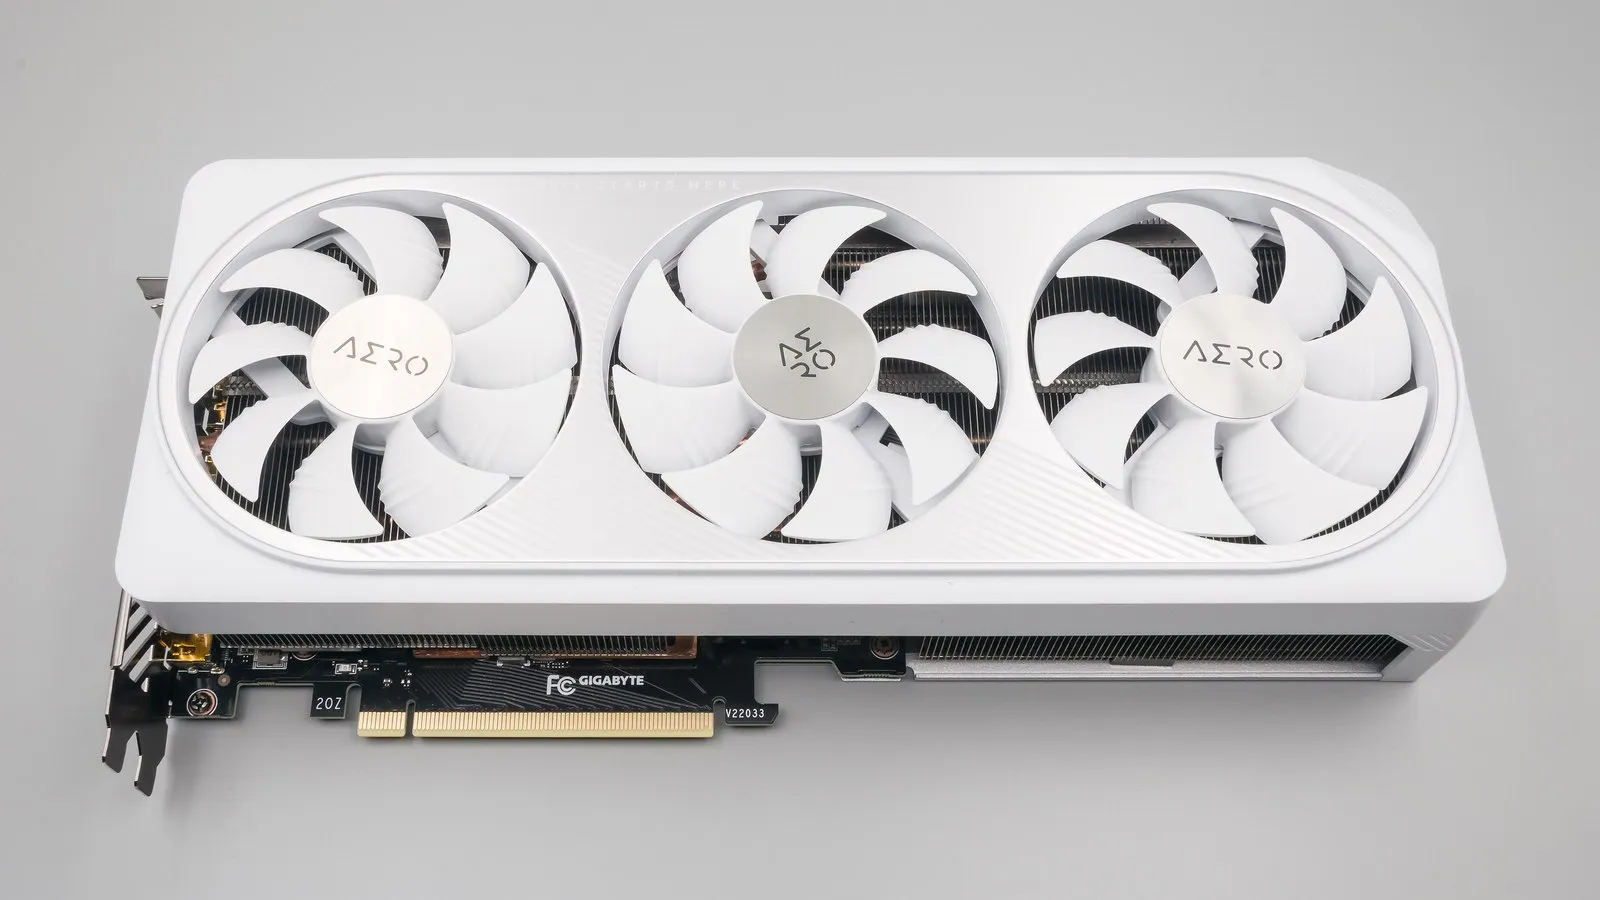
PrismML wydało Ternary Bonsai 2 27B 17 września na licencji Apache 2.0. Model wykorzystuje wagi trójstanowe z skalowaniem grupowym FP16, co zmniejsza jego rozmiar do 5,93 GB w porównaniu z 53,8 GB dla tej samej architektury w FP16. PrismML podaje, że zachowuje 98,2 % średniego wyniku modelu bazowego Qwen3.8-27B w 20 benchmarkach. Firma raportuje do 143 tokenów na sekundę na RTX 5090. Osobny projekt społecznościowy, również na licencji Apache 2.0, zoptymalizował wydajność dekodowania pod RTX 3060 12GB – określany w jego własnych testach jako najpopularniejsza karta graficzna desktopowa w badaniu sprzętu Steam z sierpnia 2026 r. z udziałem nieco poniżej 4 % – i zmierzył wzrost prędkości dekodowania nawet o 1,53× przy krótkich kontekstach.
Inco AI wydało Splash jako otwartoźródłowy silnik inferencyjny wyłącznie dla Apple Silicon, wyspecjalizowany w dwóch konkretnych modelach – Qwen3.8-27B i Qwen3.6-35B-A3B – zamiast uniwersalnego serwera modeli. Inco raportuje około 144 tokenów na sekundę przy uruchamianiu Qwen3.8-27B na MacBooku Pro z M5 Max, co według własnych porównań firmy oznacza do trzech razy większą prędkość dekodowania niż Ollama i dwa razy większą niż MLX. Silnik wymaga układu Apple M3 lub nowszego oraz co najmniej 36 GB pamięci zunifikowanej i został zintegrowany z wersją Bionic LM Studio w tym samym tygodniu.
Oba zestawy wyników pochodzą od dostawcy lub z testów własnych projektu, a nie z niezależnego audytu. Dobry wynik na pojedynczej karcie desktopowej lub MacBooku to nie to samo co izolowana inferencja dla wielu klientów jednocześnie. Połączenie tych informacji pokazuje jednak, że sprzęt konsumencki zbliża się do obciążeń, które kiedyś wymagały szafy serwerowej – warto śledzić te rozwiązania pod kątem projektów pilotażowych i zastosowań brzegowych, choć nie zastępują one jeszcze hostowanej platformy wielodostępnej.
Źródła: MarkTechPost, Inco AI.