






















01
Niezbędne Zawsze włączone
Wymagane do działania strony (logowanie, preferencje, bezpieczeństwo). Zawsze włączone.
Zapowiedzi lokalnej AI od NVIDIA z perspektywy firmy: pamięć, wydajność, koszty i przepływ danych do sprawdzenia przed zakupem sprzętu lub wdrożeniem agentów.
Lokalna AI jest tematem ogłoszenia NVIDIA z targów IFA z 3 września 2026 r., obejmującego modele o otwartych wagach i narzędzia dla RTX, DGX Spark oraz Jetson, w tym Nemotron 3.5 Lightning z 30 miliardami parametrów. Ta analiza, zaktualizowana 28 października, oddziela deklarowane cechy od kontroli potrzebnych MŚP lub MSP przed zakupem sprzętu albo podłączeniem agenta do danych firmy.
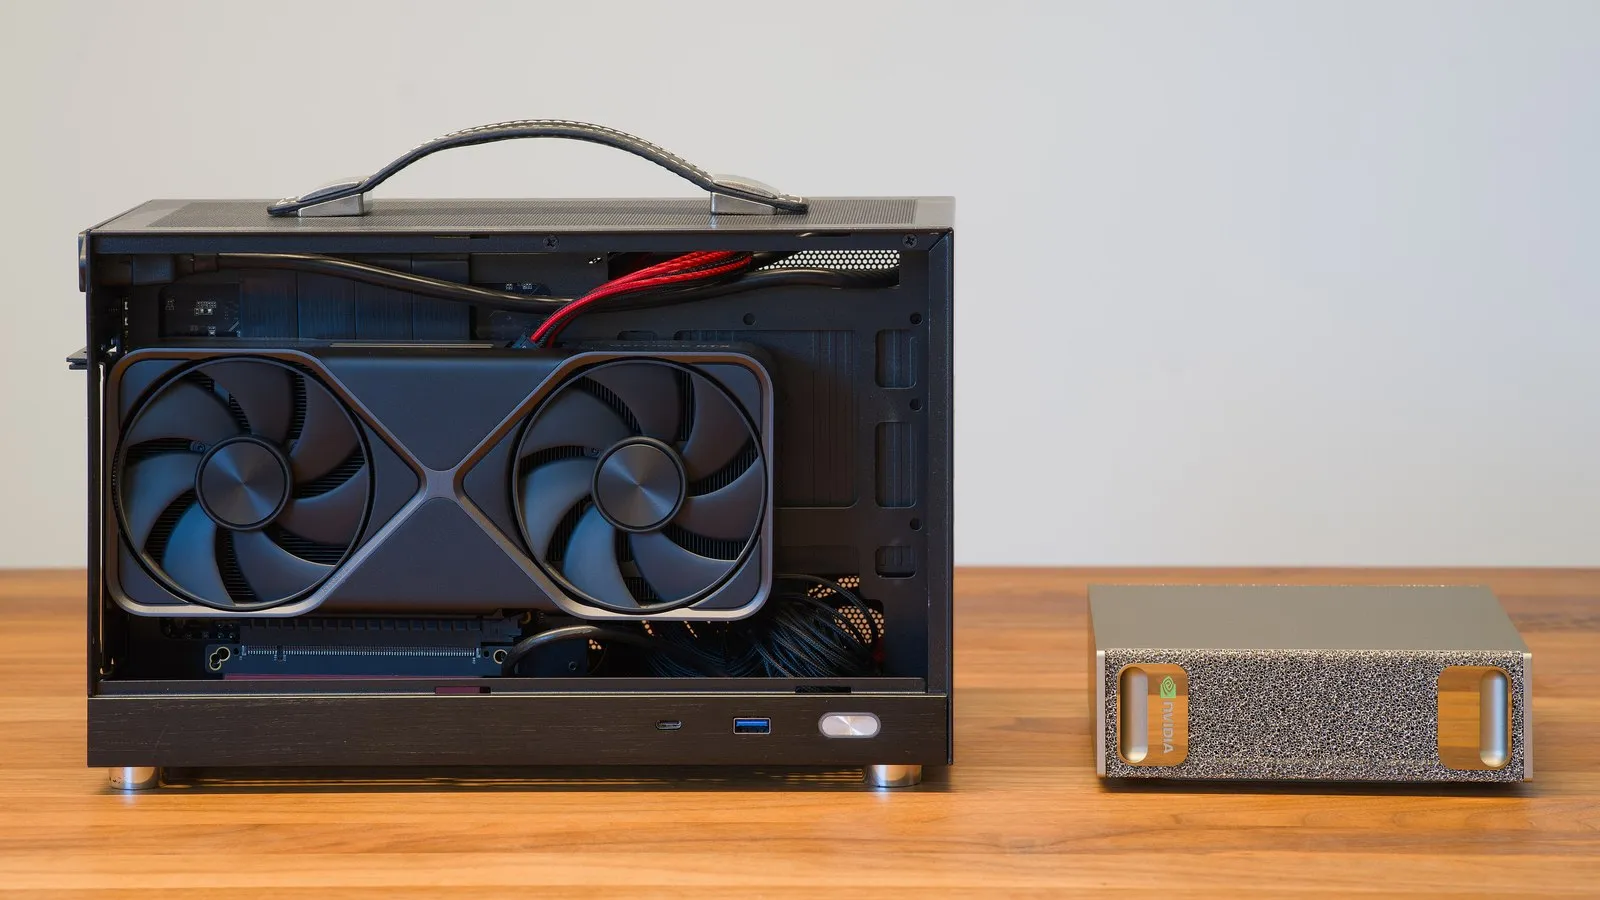
NVIDIA nie jest tu jedynym źródłem modeli. Qwen wypuścił Qwen3.8-Flash-Next, multimodalny model typu mixture-of-experts o otwartych wagach dla DGX Spark i DGX Station, a obok niego mniejszy Qwen3.8-27B dostrojony do lokalnych zadań agentowych i programistycznych. Muse Glimmer od Meta, model do kodowania i zadań agentowych o otwartych wagach i 30 miliardach parametrów, działa na komputerach RTX, DGX Spark, DGX Station i Jetson. DeepSeek v4 Flash, model typu mixture-of-experts o 284 miliardach parametrów i 13 miliardach parametrów aktywnych, jest zaprojektowany do pracy na dwuwęzłowym klastrze DGX Spark, a model generowania wideo LTX 2.5 firmy LTX celuje w układy GPU RTX i sprzęt DGX dzięki nowym optymalizacjom efektywności pamięci.
NVIDIA wskazała również komputery RTX Spark z systemem Windows od Lenovo i Acer, zbudowane wokół układu GPU RTX Blackwell o wydajności 1 petaflopa i do 128 GB zunifikowanej pamięci — skierowane do deweloperów, którzy chcą lokalnego wnioskowania klasy stacji roboczej w formie komputera PC. Aby zarządzać wnioskowaniem na więcej niż jednej maszynie, NVIDIA wprowadziła PAIR (Personal AI Router) — narzędzie, które rozdziela obciążenia AI między komputery w sieci i współpracuje z układami GPU GeForce RTX serii 20 i nowszymi.
Obietnice łatwej obsługi i szybkości pozostają deklaracjami producenta, a nie pomiarami wykonanymi przez Altovar. Podane terminy odnoszą się do komunikatu z 3 września: dostępność, obsługę systemu operacyjnego i zgodność konkretnej konfiguracji trzeba sprawdzić bezpośrednio przed zakupem. Nie przedstawiamy pogłosek jako faktów ani nie wyliczamy potrzebnej pamięci wyłącznie na podstawie liczby parametrów.
Obietnica to mniejsze tarcie przy lokalnym uruchamianiu modeli: NVIDIA zapowiada, że popularne aplikacje agentowe zbudowane na llama.cpp otrzymają uproszczoną, jednoklikową konfigurację lokalną w systemie Windows, co usuwa część ręcznej pracy związanej z wyborem modelu, znalezieniem kompatybilnego serwera inferencyjnego i dostrajaniem ustawień kwantyzacji. Dla organizacji z ograniczeniami dotyczącymi rezydencji danych lub opóźnień obniża to próg uruchamiania wydajnych modeli lokalnie lub na brzegu sieci, zamiast zależności od dostawcy AI w chmurze — choć kupujący nadal powinni samodzielnie zweryfikować wydajność i całkowity koszt posiadania, zamiast traktować podawane przez firmę NVIDIA wartości przepustowości jako gwarancję.
Przed próbą należy wybrać ograniczone zadanie, na przykład wyszukanie informacji w dokumentach testowych lub przygotowanie zmiany kodu. Warto zapisać model, kwantyzację, dostępną pamięć, długość kontekstu i liczbę równoczesnych żądań. Trzeba zmierzyć czas do pierwszej przydatnej odpowiedzi oraz do ukończenia pracy, uwzględniając błędy i przegląd. Demonstracja z jednym żądaniem nie dowodzi, że komputer obsłuży całe biuro. W porównaniu z API należy uwzględnić zakup, energię, utrzymanie, aktualizacje i czas administratora. Brak rachunku za tokeny nie oznacza bezpłatnej usługi, a porównanie wymaga tych samych obciążeń i kryteriów odbioru.
Oddzielnie trzeba sprawdzić przepływ danych. Model działający na komputerze nie gwarantuje, że konektory, telemetria, wyszukiwanie w sieci lub żądania kierowane do modelu zdalnego pozostają na urządzeniu. Próby powinny korzystać z danych syntetycznych i ograniczonych uprawnień narzędzi. Należy również sprawdzić działanie przy awarii sieci albo niedostępności jednego z komputerów. MSP musi rozdzielać archiwa i poświadczenia klientów. Podstawą wdrożenia powinny być weryfikowalny rezultat i jasno określona odpowiedzialność operacyjna; usługi sztucznej inteligencji Altovar pomagają ustalić zakres, sposób przeglądu oraz kryteria oceny przed wyborem narzędzi i rozpoczęciem pracy z rzeczywistymi danymi.
Źródła: NVIDIA Blog.