






















01
Noodzakelijk Altijd aan
Nodig voor de werking van de site (login, voorkeuren, beveiliging). Altijd aan.
NVIDIA's lokale AI vanuit een bedrijfsperspectief: geheugen, prestaties, kosten en gegevensstromen om te controleren voor aanschaf of inzet van agents.
Lokale AI staat centraal in NVIDIA's IFA-aankondiging van 3 september 2026, met open-weight modellen en hulpmiddelen voor RTX, DGX Spark en Jetson, waaronder Nemotron 3.5 Lightning met 30 miljard parameters. Deze op 28 oktober bijgewerkte analyse onderscheidt de genoemde productkenmerken van de controles die een mkb-bedrijf of MSP nodig heeft vóór aanschaf van hardware of aansluiting van een agent op bedrijfsgegevens.
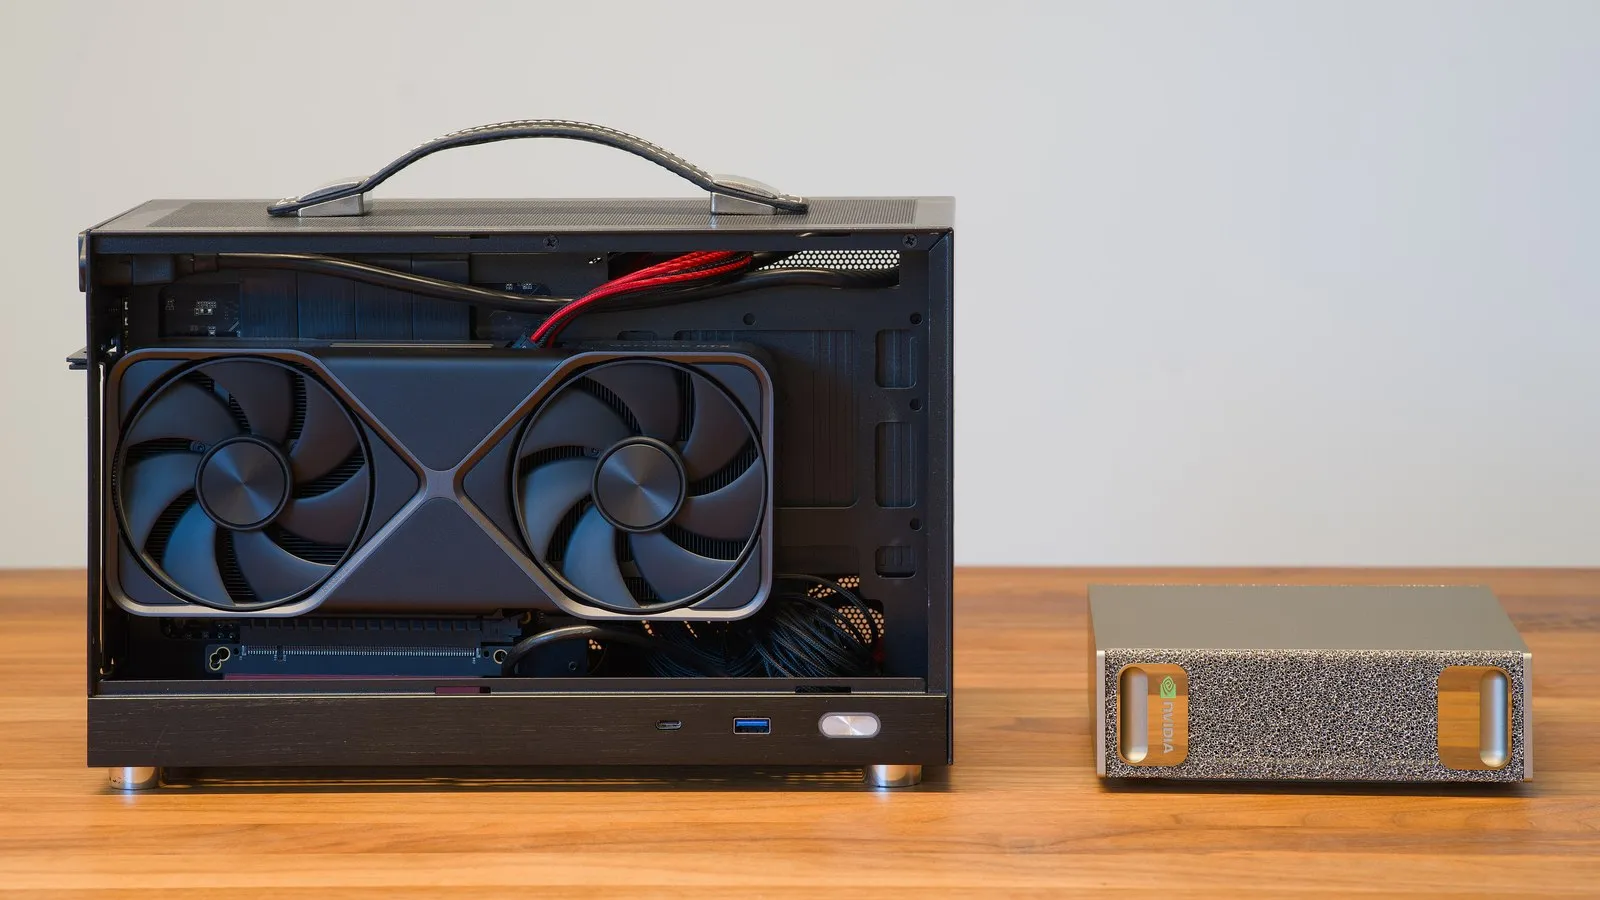
NVIDIA is niet de enige bron van de modellen hier. Qwen bracht Qwen3.8-Flash-Next uit, een open-weight multimodaal mixture-of-experts-model voor DGX Spark en DGX Station, naast een kleiner Qwen3.8-27B dat is afgestemd op lokaal agentisch en codeerwerk. Meta's Muse Glimmer, een open-weight codeer- en agentmodel met 30 miljard parameters, draait op RTX-pc's, DGX Spark, DGX Station en Jetson. DeepSeeks v4 Flash, een mixture-of-experts-model met 284 miljard parameters en 13 miljard actieve parameters, is gedimensioneerd om te draaien op een DGX Spark-cluster met twee nodes, en LTX' LTX 2.5-videogeneratiemodel richt zich op RTX-gpu's en DGX-hardware met nieuwe geheugenefficiëntie-optimalisaties.
NVIDIA wees ook op RTX Spark Windows-pc's die van Lenovo en Acer komen, gebouwd rond een RTX Blackwell-gpu van 1 petaflop met tot 128 GB unified memory — gericht op ontwikkelaars die workstation-klasse lokale inferentie in een pc-vormfactor willen. Om inferentie over meer dan één machine te beheren, introduceerde NVIDIA PAIR (Personal AI Router), een tool die AI-workloads verdeelt over genetwerkte pc's en werkt met GeForce RTX 20-serie gpu's en nieuwer.
Beloften over gebruiksgemak en snelheid blijven uitspraken van de fabrikant, geen metingen van Altovar. De genoemde introductieperiodes horen bij het bericht van 3 september: controleer beschikbaarheid, ondersteuning van het besturingssysteem en compatibiliteit van de concrete configuratie rechtstreeks vóór aanschaf. We presenteren geruchten niet als feiten en leiden de geheugenbehoefte niet alleen uit het aantal parameters af.
De pitch is minder frictie bij het lokaal draaien van modellen: NVIDIA zegt dat populaire agent-apps die op llama.cpp zijn gebouwd vereenvoudigde one-click lokale setup op Windows krijgen, waardoor een deel van het handmatige werk vervalt — een model kiezen, een compatibele inferentieserver vinden en quantisatie-instellingen afstemmen. Voor organisaties met datalokalisatie- of latentiebeperkingen verlaagt dat de drempel om capabele modellen on-premises of aan de edge te draaien in plaats van afhankelijk te zijn van een cloud-AI-provider — al moeten inkopers nog steeds hun eigen prestaties en total cost of ownership valideren in plaats van NVIDIA's throughput-cijfers als garantie te nemen.
Kies vóór een proef een afgebakende taak, zoals informatie zoeken in testdocumenten of een codewijziging voorbereiden. Noteer model, kwantisatie, beschikbaar geheugen, contextlengte en aantal gelijktijdige verzoeken. Meet de tijd tot het eerste bruikbare antwoord en tot het afgeronde werk, inclusief fouten en beoordeling. Een demo met één verzoek toont niet aan dat een machine een heel kantoor kan bedienen. Neem bij vergelijking met API's aanschaf, stroom, onderhoud, updates en beheeruren mee: het ontbreken van een rekening per token maakt een dienst niet gratis. Gebruik steeds dezelfde belasting en acceptatiecriteria.
Controleer de gegevensstromen afzonderlijk. Een model op een pc garandeert niet dat connectoren, telemetrie, zoekopdrachten op het web of verzoeken aan een extern model op dat apparaat blijven. Test de werkwijze met synthetische gegevens, beperk de rechten van hulpmiddelen en kijk wat er gebeurt als het netwerk of een deelnemende machine uitvalt. Een MSP moet ook klantarchieven en inloggegevens scheiden. Begin met een controleerbaar resultaat en duidelijke verantwoordelijkheid voor het beheer; de AI-diensten van Altovar helpen om vooraf het bereik, de beoordelaar en de evaluatiecriteria te bepalen.
Bronnen: NVIDIA Blog.