





















01
Nödvändiga Alltid på
Krävs för att webbplatsen ska fungera (inloggning, inställningar, säkerhet). Alltid på.
PrismML:s ternära Bonsai 2 27B får plats i 5,9 GB och körs på konsument-GPU:er; Inco AI:s Splash-motor är byggd specifikt för Apple Silicon. Båda är leverantörsbenchmarkade, inte granskade.
Två releaser för lokal inferens landade inom några dagar från varandra denna månad: PrismML:s Ternary Bonsai 2 27B, en kraftigt komprimerad modell riktad mot konsument-GPU:er, och Inco AI:s Splash, en inferensmotor byggd specifikt för Apple Silicon.
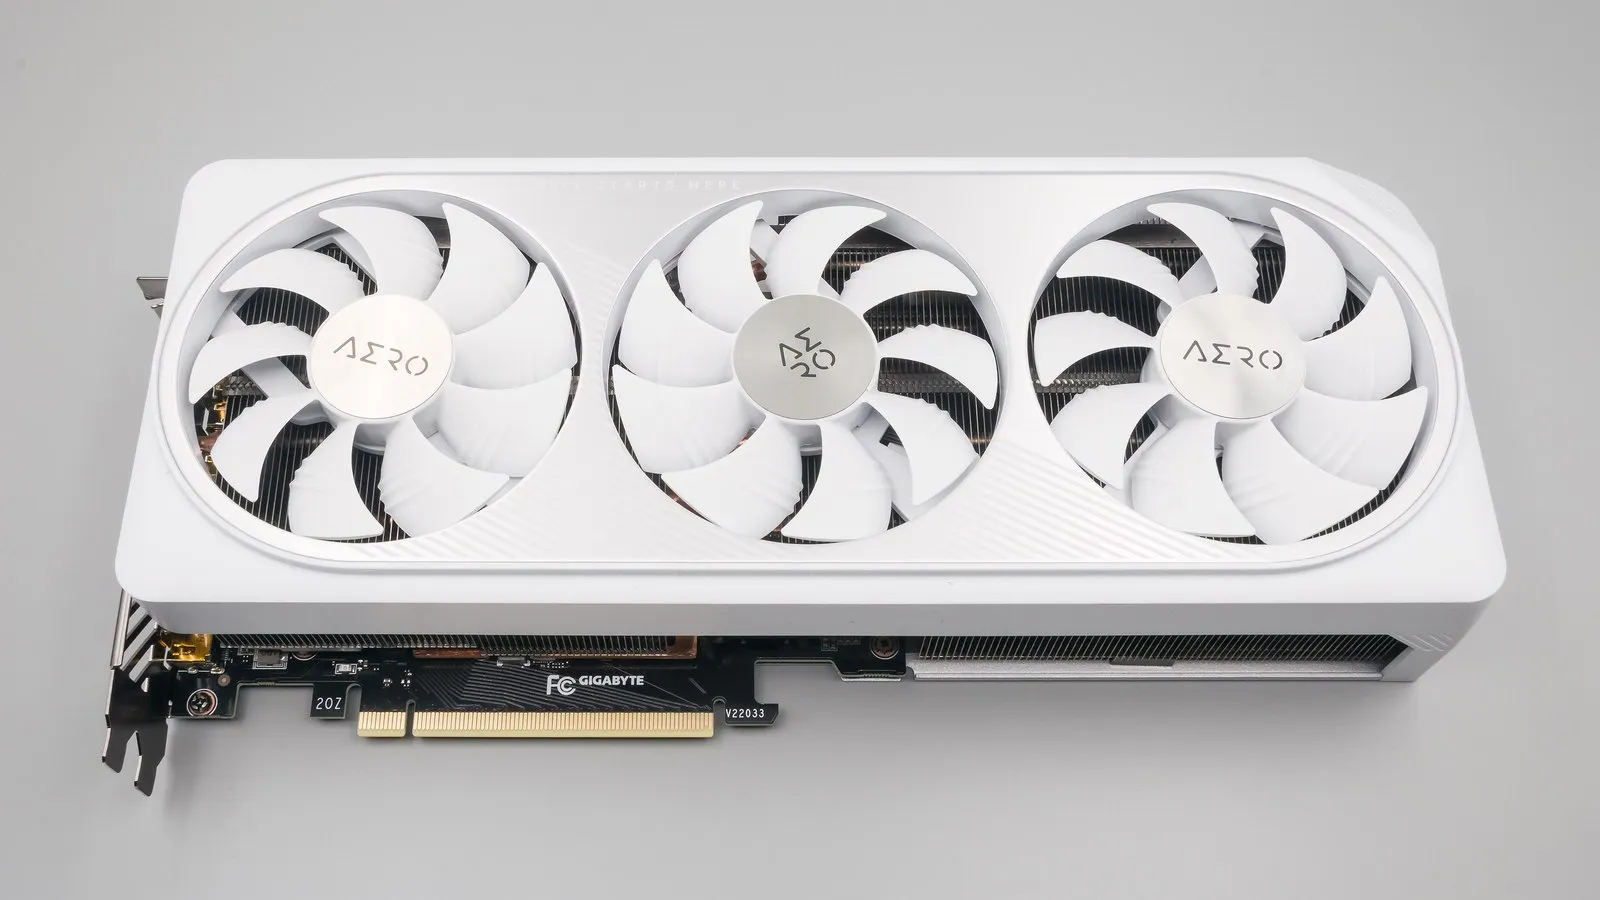
PrismML släppte Ternary Bonsai 2 27B den 17 september under Apache 2.0-licens. Den använder ternära vikter med FP16-gruppvis skalning för att krympa modellen till 5,93 GB, jämfört med 53,8 GB för samma modell i FP16, samtidigt som PrismML uppger att den behåller 98,2 % av föräldramodellen Qwen3.8-27B:s genomsnittliga poäng över 20 benchmark-tester. Företaget rapporterar upp till 143 tokens per sekund på en RTX 5090. Ett separat, också Apache 2.0-licensierat communityprojekt optimerade avkodningsprestanda specifikt för RTX 3060 12GB -- som i sin egen benchmark beskrivs som den enskilt vanligaste stationära GPU:n i Steams hårdvaruundersökning från augusti 2026, med strax under 4 % andel -- och mätte en avkodningshastighet som förbättrades med upp till 1,53x vid korta kontextlängder.
Inco AI släppte Splash som en öppen källkod, Apple Silicon-endast inferensmotor specialiserad för två specifika modeller, Qwen3.8-27B och Qwen3.6-35B-A3B, snarare än byggd som en generell modellserver. Inco rapporterar cirka 144 tokens per sekund vid körning av Qwen3.8-27B på en M5 Max MacBook Pro, vilket de säger är upp till tre gånger avkodningshastigheten hos Ollama och dubbelt så mycket som MLX i egna jämförelser. Motorn kräver ett Apple M3-chip eller nyare och minst 36 GB unified memory, och Inco uppger att den integrerades i LM Studio:s Bionic-release samma vecka.
Båda uppsättningarna siffror kommer från leverantören eller projektets egen benchmark, inte en oberoende granskning, och en stark demo på en enda stationär GPU eller MacBook är inte samma sak som att köra hyresgästisolerad inferens för många kunder samtidigt. Det som parningen visar är att konsumenthårdvara håller på att sluta klyftan till arbetslaster som tidigare krävde ett rack -- värt att följa för pilot- och edge-användningsfall, ännu inte en ersättning för en hostad, multi-tenant-plattform.
Källor: MarkTechPost, Inco AI.