






















01
Nödvändiga Alltid på
Krävs för att webbplatsen ska fungera (inloggning, inställningar, säkerhet). Alltid på.
NVIDIAs besked om lokal AI ur ett företagsperspektiv: minne, prestanda, kostnader och dataflöden att kontrollera före inköp eller införande av agenter.
Lokal AI står i centrum för NVIDIAs IFA-besked den 3 september 2026, med modeller med öppna vikter och verktyg för RTX, DGX Spark och Jetson, däribland Nemotron 3.5 Lightning med 30 miljarder parametrar. Den här analysen, uppdaterad den 28 oktober, skiljer tillverkarens uppgifter från de kontroller ett mindre företag eller en MSP behöver före hårdvaruinköp eller anslutning av en agent till företagsdata.
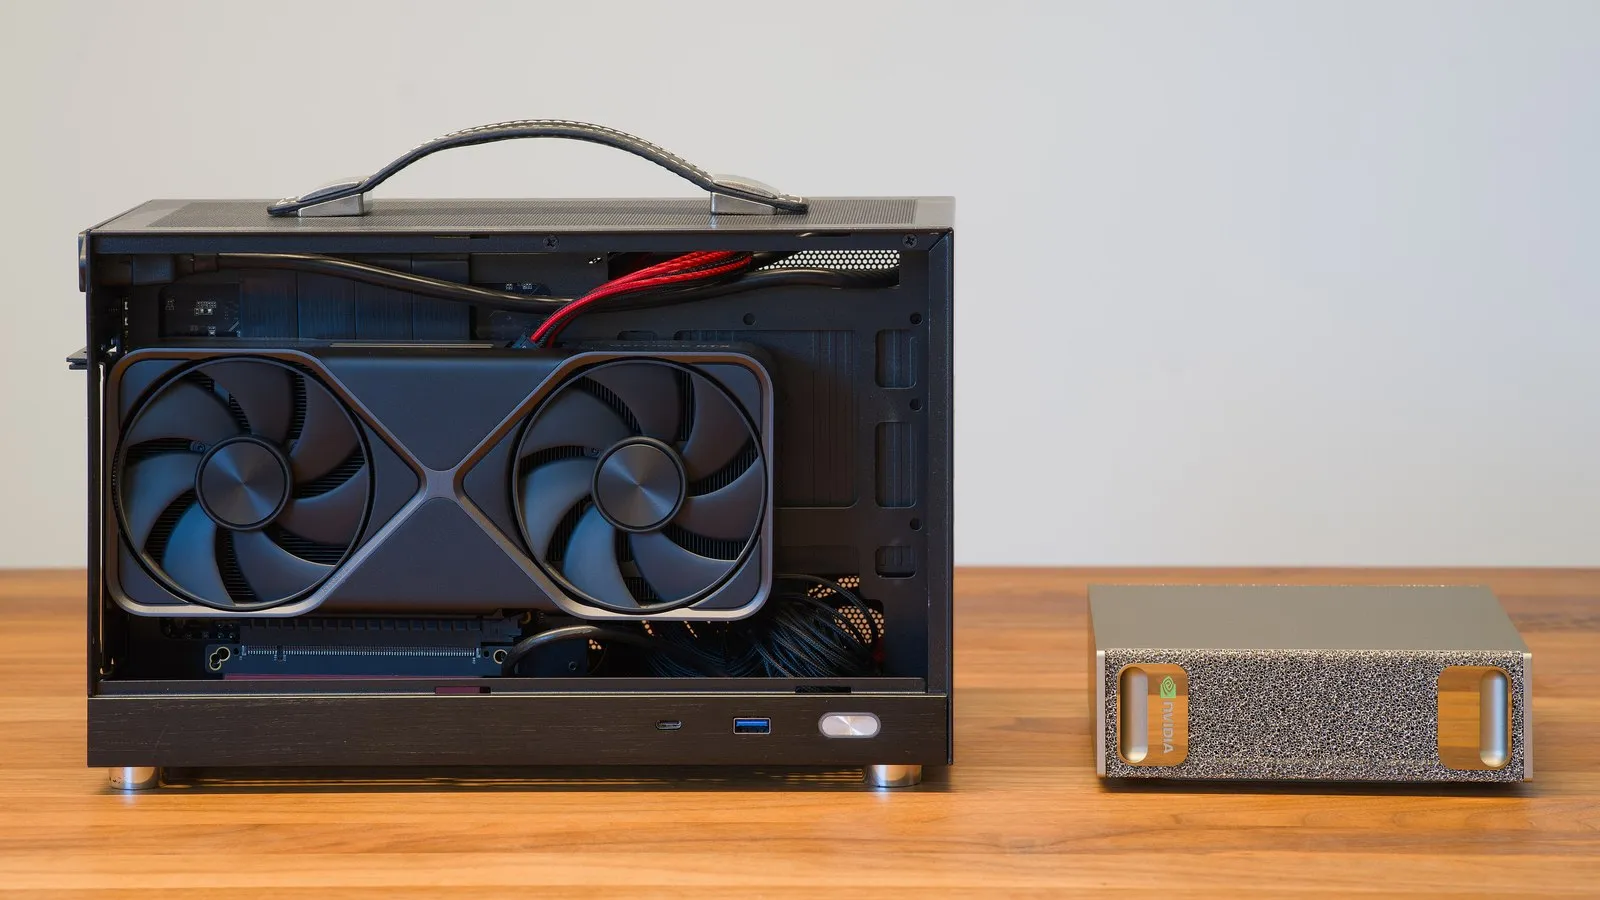
NVIDIA är inte den enda källan till modellerna här. Qwen släppte Qwen3.8-Flash-Next, en multimodal mixture-of-experts-modell med öppna vikter för DGX Spark och DGX Station, tillsammans med en mindre Qwen3.8-27B som är anpassad för lokalt agentiskt och kodningsarbete. Metas Muse Glimmer, en kodnings- och agentmodell med öppna vikter och 30 miljarder parametrar, körs på RTX-datorer, DGX Spark, DGX Station och Jetson. DeepSeeks v4 Flash, en mixture-of-experts-modell med 284 miljarder parametrar och 13 miljarder aktiva parametrar, är dimensionerad för att köras på ett DGX Spark-kluster med två noder, och LTX:s LTX 2.5-videogenereringsmodell riktar sig mot RTX-GPU:er och DGX-hårdvara med nya minneseffektivitetsoptimeringar.
NVIDIA pekade också på RTX Spark Windows-datorer från Lenovo och Acer, byggda kring en RTX Blackwell-GPU med 1 petaflop och upp till 128 GB enhetligt minne – avsedda för utvecklare som vill ha lokal inferens i arbetsstationsklass i ett PC-format. För att hantera inferens över fler än en maskin introducerade NVIDIA PAIR (Personal AI Router), ett verktyg som distribuerar AI-arbetsbelastningar över nätverksanslutna datorer och fungerar med GeForce RTX 20-seriens GPU:er och nyare.
Löften om enkelhet och hastighet är fortfarande tillverkarens uppgifter, inte mätningar utförda av Altovar. Angivna lanseringsperioder gäller beskedet den 3 september: tillgänglighet, stöd för operativsystemet och kompatibilitet för den aktuella konfigurationen måste kontrolleras direkt före köp. Vi presenterar inte rykten som fakta och beräknar inte minnesbehov enbart utifrån antalet parametrar.
Budskapet är lägre friktion för att köra modeller lokalt: NVIDIA säger att populära agentappar byggda på llama.cpp kommer att få förenklad installation lokalt med ett klick på Windows, vilket tar bort en del av det manuella arbetet med att välja modell, hitta en kompatibel inferensserver och justera kvantiseringsinställningar. För organisationer med krav på datahemvist eller latensbegränsningar sänker det tröskeln för att köra kapabla modeller lokalt eller i edge-miljö i stället för att vara beroende av en molnbaserad AI-leverantör – även om köpare fortfarande bör validera sin egen prestanda och totala ägandekostnad i stället för att ta NVIDIAs genomströmningssiffror som en garanti.
Välj en avgränsad uppgift före försöket, exempelvis att söka information i testdokument eller förbereda en kodändring. Registrera modell, kvantisering, tillgängligt minne, kontextlängd och antal samtidiga förfrågningar. Mät tiden till det första användbara svaret och till avslutat arbete, inklusive fel och granskning. En demo med en enda förfrågan visar inte att datorn kan försörja ett helt kontor. Ta med inköp, el, underhåll, uppdateringar och administrationstid vid jämförelse med API:er: avsaknad av en tokenfaktura gör inte tjänsten gratis. Samma arbetsbelastning och acceptanskriterier ska gälla under hela jämförelsen.
Kontrollera dataflödena separat. En modell som körs på datorn garanterar inte att anslutningar, telemetri, webbsökningar eller förfrågningar till en extern modell stannar på enheten. Prova arbetsflödet med syntetiska data, begränsa verktygens behörigheter och undersök vad som händer när nätverket eller en deltagande dator inte är tillgänglig. En MSP behöver även skilja kundernas arkiv och inloggningsuppgifter åt. Införandet bör utgå från ett verifierbart resultat och tydligt driftansvar; Altovars tjänster inom artificiell intelligens ger en startpunkt för att bestämma omfattning, granskning och bedömningskriterier innan verktygen väljs och verkliga kunddata används.
Källor: NVIDIA Blog.